TGViewer
Channel Public Channel
Мир аналитика данных

Мир аналитика данных

@analysts_world

Пишу о рабочих буднях аналитика. Тут много рабочего кода, прохождение собеседований и еще много всего полезного.
https://www.linkedin.com/in/valeriashuvaeva
Автор канала: @Valeria_Shuvaeva
Subscribers
4.56K
Photos
143
Videos
3
Links
114

Showing posts older than #72 · Back to latest

Older Posts 20 shown
Post #71 2.29K
✅ Расскажу об интересном кейсе случае. Есть у нас на работе таблица, в которую каждый день добавляются данные. Столбцов там много с разной инфой. Чтобы был понятен алгоритм приведу вот такой пример:

data – дата, account_id – номер клиента, info – определенная информация из списка, у одного клиента может быть таких несколько, поэтому в таблице бывает представлено двумя и более строками, turnover – оборот клиента за определенный период времени.
Создадим пример датафрейма:

data = {'data':['2023-07-27','2023-07-27','2023-07-27','2023-07-27'],
'account_id': [111,111,333,444],
'info':['параметр 1','параметр 2','параметр 3','параметр 2'],
'turnover': [100, 200,300,400]}
df_old = pd.DataFrame(data)

Раньше таблица дополнялась снизу новыми данными на определенную дату и в конце концов стала очень большой. Поэтому было решено ее ОПТИМИЗИРОВАТЬ! Но сложность была в том, что если у account_id есть параметр info на старую дату, которого не было в новой выгрузке, то эту старую строку и нужно оставлять со всеми сопутствующими столбцами.
Пример таблицы, которую добавляем к той первоначальной
df_new = pd.DataFrame({'data':['2023-07-28','2023-07-28','2023-07-28','2023-07-28'],
'account_id': [111,555,666,777],
'info':['параметр 1','параметр 2','параметр 3','параметр 2'],
'turnover': [500, 600,700,800]})

💡Я придумала вот такой способ. Выкачиваю файл, который был в гуглдоке, подтягиваю его в юпитер и соединяю с новой таблицей именно в этой последовательности (сначала новый датафрейм, а потом старый):

df_all = pd.concat([df_new, df_old], ignore_index = True, sort = False)

А потом убираю дубликаты по двум важным столбцам: account_id и info
df_final = df_all.drop_duplicates(subset=['account_id', 'info'])

И в результате получается то, что нужно. На картинке видно, что у аккаунта 111 есть строка с параметром 2, датированная 27 июля (то есть ее оставили нетронутой) и есть строка с аккаунтом 111 и параметром 1 уже новая от 28 июля.
  • 👍 14
Post #70 2.31K
🔤🔤🔤🔤 Вот про такой кейс сейчас расскажу. В прямом смысле про условную конструкцию case.
Она довольно часто используется в SQL запросах.
В when мы задаем условие и то, что нам нужно получить при его выполнении, а в else – выполнить то, что условию не соответствует. В конце после end as прописываем как называться будет столбик.

Сначала покажу на примерах из курса Карпова.
🔹Нужно повысить цену на 5% только на те товары, цена которых превышает 100 рублей. Цену остальных товаров оставить без изменений. Также не повышайте цену на икру, которая и так стоит 800 рублей. Выведите id и наименования всех товаров, их старую и новую цену. Результат отсортируйте сначала по убыванию новой цены, затем по возрастанию id товара.

SELECT
product_id,
name,
price as old_price,
case
when price > 100
and name != 'икра' then price * 1.05
else price
end as new_price
FROM
products
ORDER BY 4 desc, product_id

🔹В следующем задании необходимо посчитать стоимость заказа, в котором будут три пачки сухариков, две пачки чипсов и один энергетический напиток. Колонку с рассчитанной стоимостью заказа нужно назвать order_price.
Тут мы будем суммировать цены с помощью sum, в который поместим то, что нам выдаст case
SELECT
sum(
case
when name = 'сухарики' then price * 3
when name = 'чипсы' then price * 2
when name = 'энергетический напиток' then price
else 0
end
) as order_price
FROM
products

🔹 А теперь покажу на рабочем примере:
Вот так рассчитывается общая рублевая сумма при условии, что есть цены не только в рублях, но и в других валютах. Если валюта рублевая (in ('RUB','RUR')), то цена просто amount, в противном случае (else) цена умножается на курс (amount*rate)

sum(
case
when currency in ('RUB', 'RUR') then amount
else amount * rate
end
) as amount

🔹Или допустим, вот такой еще пример. Если в базе есть данные по фио или о продукте, но где-то они пропущены, то можно сделать столбец с текстом 'есть данные' или 'не указано'. Вместо текста можно 1 и 0 поставить.

case
when name != '' then 'есть данные'
when name = '' then 'не указано'
when name is null then 'не указано'
end
as 'инфа'

Ну и конечно в одном запросе может быть несколько case как обычно в select через запятую.
Если понравился такой формат разбора Карпов+рабочий опыт, ставьте 🐳
  • 🐳 36
  • 👍 11
  • ❤ 3
Post #69 2.4K
🤪🤫😙😑🤗 Всем привет! 😀 Ко мне обратились с просьбой прорекламировать блог, и я подумала, а почему бы и нет.
❗️Девушка - действующий главный бизнес аналитик в крупном банке , делится экспертизой, выкладывает полезные для БА материалы. Вдруг кому полезно будет. Канал небольшой, но уютный. ☕️
Да и вообще - покидайте в комментарии свои личные блоги, даже если и не про аналитику. Не все же про метрики и питоны читать. Я даю официальное добро. 🤲🤲🤲
https://t.me/BA_by_MA
Telegram Марина Ахрамеева |Думай в тишине 1) Остановиться и подумать можно здесь 2) Книги,в которые нужно инвестировать время 3) Личный опыт (хороший и не очень)
  • ❤ 5
  • 👍 2
Post #68 2.89K
🔥 У Яндекса открылся новый хендбук https://academy.yandex.ru/handbook/data-analysis
Прикладной анализ данных в социальных науках.
Читать можно без регистрации, удобно.
Там есть про:
- введение в понятие данных и описательные статистики числовых данных
- базовые статистические тесты в Python
- про категориальные переменные
- факторный анализ
- парсинг данных и автоматизация браузера, регулярные выражения
- про регрессии
и прочее. 🐍👨‍💻
  • 👍 27
  • 🔥 8
Post #67 2.33K
🔤🔤🔤🔤🔤 Где же ты, где или np.where()

Недавно открыла для себя использование np.where(). np – это numpy.
Покажу на простых примерах как его можно использовать. Создадим датафрейм. Не забываем import numpy as np Ну и как всегда import pandas as pd

df = pd.DataFrame({'Name': ['Дмитрий', 'Антон', 'Арсений', 'Сергей','Катерина'],
'Age': [38, 32, 40, 39, 37],
'Gender': ['M', 'M', 'M', 'M','F']})

Хочу создать столбец, основываясь на данных столбца Age:
📍 Если возраст старше или равен 35, то пусть в строке будет написано 'Старше 35', в противном случае - 'Моложе 35'
df['check_where_одно_условие'] = np.where(df.Age >=35, 'Старше 35', 'Моложе 35')

📍 Можно поставить два условия и больше. Если возраст старше или равен 35 и пол смотрим только мужской - M
df['check_where_два_условия'] = np.where((df.Age >=35)&(df.Gender == 'M'), 'Мужчина старше 35', 'нет')

Напротив Катерины в столбце 'check_where_два_условия' будет написано ‘нет’, так как оба условия одновременно не выполняются. Возраст старше 35, а вот пол женский - (df.Age >=35)&(df.Gender == 'M')

📍 Хотим рассчитать возраст через 3 года при условии, что это мужчина. Удобно, что посчитать что-то можно, не только текст вписать.
df['check_where_расчетное'] = np.where(df.Gender == 'M', df.Age+3, df.Age)

Мы также можем установить значения DataFrame, используя атрибут loc[].
df.loc[df.Age >=35, 'check_loc'] = 'да'
Но тогда там, где условие не выполняется будут пропуски – NaN. Как вариант, заполнить потом эти пропуски нулями.

В этом плане np.where() удобен тем, что можно сразу поставить, что будет прописано и при выполнении условия и при НЕ выполнении.
  • 👍 14
  • 🔥 5
  • ❤ 3
Post #66 3.21K
❓ Покажу на примере, что такое когортный анализ и с чем его едят. ❓
Начну с определения, прямо как в школе.
Когортный анализ - способ изучить группы пользователей и клиентов, объединённых общими признаками в определённый период времени.

SQL запросом отбираем аккаунты клиентов, которые вас интересуют. df['account_id'] Допустим, по дате создания или у кого первая дата оплаты продукта с начала года. Колонки будут: week – неделя. в которой произошло это событие, номер клиента - account_id.

Вот так можно в SQL соединить год и неделю, на случай если нужен не только 2023, но и прошлые года:
concat(YEAR(first_payed_product_at),'-',week(first_payed_product_at,1)) as week. В итоге будут данные в таком формате: 2023-0, 2023-1, 2023-2 и прочее

По отобранным клиентам считаем выручку за 2023 год в разрезе платежных систем.
type – это тип платежной системы (tinkoff, yandex_kassa и прочее)
query = f""" -- здесь нужен f, чтобы потом в условии where можно было бы воспользоваться и указать список клиентов, по которым мы ищем выручку.
select account_id, type
sum(amount) as 'amount'
from payment
where account_id in {tuple(df_acc['account_id'])}
and deleted=0
and status='accepted'
and created_at >= '2023-01-01'
group by 1,2
order by 1,3
df_rev = pd.read_sql(query, connection)

Выгрузка сохраняется в датафрейм df_rev.
Относим клиента в ту платежную систему, через которую прошли максимальные платежи за период – оставляем последние .last (мы сортировали их order by 3).
df_big = df_rev.groupby(by='account_id').last().reset_index()

Соединяем базу со всеми клиентами – df_acc, который мы выкачали вначале с выгрузкой df_rev
Если не было выручки, то пишем fillna('no_payment’)
df_merge = pd.merge(df_acc, df_big, on = 'account_id', how = 'left').fillna('no_payment’)

А теперь самое интересное!

df_final = df_merge.pivot_table(index = 'week', columns=['type'],  values = 'account_id',aggfunc = 'count', margins=True).fillna(0).reset_index()

✔️ Мы развернули таблицу, чтобы по строкам у нас были недели, по столбцам – типы оплат, а в значениях - кол-во account_id, то есть кол-во клиентов, максимальные платежи которых проходят через этот тип оплат.
  • 🔥 13
  • 👍 5
  • 🤯 5
  • ❤ 1
Post #65 2.33K
👍 Важная информация! Если вам нужна математика: мат.анализ и линейная алгебра (функции, их оптимизация, матрицы, вектора), то все это теперь есть бесплатно тут: https://karpov.courses/mathsds?utm_source=tg&utm_medium=post&utm_campaign=start&utm_content=1_lesson

Один вопрос - как на все, что я хочу изучить и в чем углубить знания, найти время? 🙈 Очень горячая пора. 🔥
karpov.courses Бесплатный курс Математика для анализа данных | karpov сourses Бесплатный курс Математика для анализа данных от Карпов Курсы. Изучите основы линейной алгебры, матанализа и статистики
  • 👍 28
  • 🔥 3
  • 🥰 1
Post #64 2.63K
На канале уже 1️⃣0️⃣0️⃣0️⃣ подписчиков! Для меня это прям ВАУ! 😮 Никогда не думала, что буду в своем роде блогером 😂, если можно так выразиться. Начинала писать, чтобы поделиться той информацией, которой мне самой не хватало, когда я училась. Ведь так хотелось посмотреть, а что же делают эти it аналитики? ❓Я рада, что могу помогать кому-то таким образом перейти в аналитику или подсказать что-то тем, кто уже работает. Пусть люди улучшают свою жизнь привнося в нее радость от того, что занимаются тем, что им действительно нравится. Ну и хорошая зарплата еще никому не мешала. 🔼 В каждой работе можно найти элемент творчества, а в нашей его очень много и это тоже вдохновляет!😀

Ну и немного полезности:👍
Для собесов, как известно приходится решать тестовые и не всегда есть на компе установленная база данных с sql. Нашла, что оказывается есть онлайн версия sqlite
https://sqliteonline.com
Достаточной удобный сайт, с возможностью работать с разными СУБД, он умеет сохранять таблицы и запросы даже после закрытия.
  • 🔥 28
  • 👍 13
  • ❤ 3
Post #63 2.47K
🌐 Вокруг света на Python!

Как определить к какой стране относится номер телефона? Вот есть у вас база и там много номеров. Но даже по коду +7 есть номера не только России, но и Казахстана. Когда стран много, то все варианты кодов не перечислить. Ну или у вас слишком много свободного времени. Но есть решение! Тут должна быть реклама чудо средства. И это ..пам, пам, пам.. библиотека Python Phonenumbers.

Все что нужно импортировать:
import pandas as pd
from tqdm import tqdm
import numpy as np
import phonenumbers
from phonenumbers import geocoder

Как пример:
phonenumbers.parse('+79991456887') выдаст вот такую информацию: PhoneNumber(country_code=7, national_number=9991456887, extension=None, italian_leading_zero=None, number_of_leading_zeros=None, country_code_source=0, preferred_domestic_carrier_code=None)

🔥 Итак, есть у нас датафрейм с выкаченными номерами - df_phones. Номера в колонке phone_standart. У меня они без знака +, по стандарту. Добавляем плюсик к началу:
df_phones['phone_standart'] = '+' + df_phones['phone_standart'].astype('str')

Загоняем номера в лист number_lst = df_phones['phone_standart'].tolist()
Создаем пустой лист. true_number_lst =[]

Используем библиотеку tqdm, чтобы видеть, как идет процесс. Пока в цикле перебираются номера, у вас бежит бегунок и видно, что процесс идет.

for i in tqdm(number_lst):
try:
true_number_lst.append(phonenumbers.parse(i))
except:
true_number_lst.append(np.nan)

Теперь создаем список для кодов стран:
country_lst =[]
for j in tqdm(true_number_lst):
try:
country_lst.append(geocoder.region_code_for_number(j))
except:
country_lst.append(np.nan)
В результате список country_lst заполнился кодами стран.
Присвоим его колонке датафрейма:
df_phones['country_cod'] = country_lst

В результате получим то, что видите на картинке. Каждый номер, если он есть - идентифицирован. 🔥
  • 👍 18
  • 🔥 10
  • ❤ 1
Post #62 2.25K
🔥 Свежее тестовое с решением!
Это не мое, но меня попросили помочь.. 😀
А вообще по прогнозам Всемирного экономического форума, с 2020 до 2030 года количество вакансий для аналитика данных вырастет на 25%. Так что кто еще сомневается стоит ли идти в аналитики - дерзайте! Как писал Гюстав Флобер (французский писатель) "Самые восхитительные моменты вашей жизни — это не дни так называемого успеха, а, скорее, те времена, когда уныние и отчаяние порождают в вашей душе желание бросить вызов жизни, и предвкушение грядущих свершений."

1а.
SELECT *
FROM stream
WHERE stream_name LIKE '%Мой первый стрим на wasd.tv%'

1.b.
SELECT *
FROM stream
WHERE created_at = '2020-01-01'

2. SELECT COUNT(distinct stream_id)
FROM stream

3. SELECT EXTRACT(DAY FROM created_at) as day,
COUNT(distinct stream_id)
FROM stream
WHERE created_at > CURDATE() - INTERVAL 30 DAY
GROUP BY 1

4. SELECT EXTRACT(DAY FROM created_at) as day,
COUNT(distinct stream_id) as count_stream
FROM stream
GROUP BY 1
HAVING count_stream >=1000

5. SELECT *
FROM stream s
JOIN stream_status ss
ON s.id = ss.id
JOIN profile p
ON s.user_id = p.user_id
WHERE s.created_at = CURDATE()
AND ss.stream_status = 'RUNNING'
AND p.created_at < '2020-01-01'
  • 👍 19
  • 🔥 3
Post #61 2.16K
✔️ В понедельник не будем сильно напрягать мозг 👍, поэтому просто пробежимся по вопросам с собеседований по Python и Pandas: 🔝
1. Какой тип данных у переменной a?
a = 'Hello, world!'
print(type(a)) # <class 'str'>

2. Как можно разбить строку на подстроки?
s = 'one,two,three'
lst = s.split(',')
print(lst) #['one', 'two', 'three']

3. Как можно сгенерировать список чисел от 0 до 9 включительно?
lst = list(range(10))
print(lst) # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Это вариант - range(stop) генерирует целые числа от 0 до целого числа stop
Есть вариант range(start, stop) — генерирует целые числа от start до stop
И еще один range(start, stop, step) — генерирует целые числа от start до stop с интервалами step

4. Как создать уникальный список значений из двух списков?
lst1 = [1, 2, 3, 4]
lst2 = [3, 4, 5, 6]
uni = list(set(lst1 + lst2))
print(uni) # [1, 2, 3, 4, 5, 6]

5. В чем разница между списком и кортежем?
Список (list) можно изменить после создания. Он представляет собой упорядоченные последовательности объектов, как правило, одного и того же типа.
Кортеж (tuple) нельзя изменить после создания. И в каждом индексе могут сосуществовать различные типы данных.

6. Как работает умножение строк?
'test' * 3
#=> 'testtesttest'

7. Как работает умножение списка?
[1,2,3] * 2
#=> [1, 2, 3, 1, 2, 3]

8. Что такое DataFrame в библиотеке Pandas? Да, такое тоже спрашивают. DataFrame — основной тип данных в Pandas, вокруг которого строится вся работа. Его можно представить в виде обычной таблицы с любым количеством столбцов и строк. Внутри ячеек такой «таблицы» могут быть данные самого разного типа: числовые, булевы, строковые и так далее.
import pandas as pd
df = pd.DataFrame({'col1': [1, 2, 3], 'col2': ['a', 'b', 'c']}) - создаем какой-нибудь датасетик для примера.

9. Как выбрать строки в DataFrame с использованием условий?
df = pd.DataFrame({'col1': [1, 2, 3], 'col2': ['a', 'b', 'c']})
df_filtered = df[df['col1']>1]
или если несколько условий:
df_filtered = df[(df['col1']>1)&(df['col2']!='b')]

Продолжение ->
  • 👍 26
  • 🔥 4
  • ❤ 2
Post #60 2.3K
А что, так можно было?

Я зарегистрировалась в LinkedIn еще в 2013 году, но ничего о себе не заполняла и вскоре забросила. Мне всегда hh помогал с поиском работы.
Но недавно я решила его реанимировать. Я думала, что там только для тех, кто хочет уехать зарубеж, а я вроде как не планирую. У меня тут семья, родные. Но в последнее время стала замечать, что очень много вакансий с телеграмм каналов и с geekjob.ru ссылаются на Linkedin. И там конкретный человек (HR или тимлид) описывает вакансию и кого именно они ищут. У нас есть возможность пообщаться напрямую с тимлидом даже без эйчар! И эти компании русские! Там их полно, если не все.
А еще очень важно создавать свою сеть контактов или модное сейчас слово networking. Ведь человек после общения с вами может порекомендовать вас в компанию. Чем больше у вас контактов, тем больше людей сможет с вами связаться.

VPN я не ставила, а вот тор-браузер скачала (firefox) и захожу через него.
Еще есть вот такой вариант - через расширение:
https://chrome.google.com/webstore/detail/%D0%B4%D0%BE%D1%81%D1%82%D1%83%D0%BF-%D0%BA-linkedin/lfpfgkjmoclpggokhdacgidpeoedmhjh

Оставляйте в комментариях ссылки на свой linkedin! Давайте создадим большое полезное сообщество!

Вот мой Linkedin

P.S. картинку сгенерировала в midjourney (если нужно, то поделюсь как получить безграничное кол-во попыток)
  • 🥰 10
  • 👍 8
  • ❤ 7
Post #59 2.39K
Функция transform() в Python 🐍

👍 Подглядела эту функцию у коллеги. Не влюбиться в функцию просто не возможно! Она такая крутая! Короче, это метод, который применяет функцию к каждой группе данных и возвращает результат в том же порядке, что и исходные данные. Это очень удобный способ изменения исходных данных.

✏️ Синтаксис:
DataFrame.groupby('column_name').transform(function_name)

Создадим dataframe
data =
{'Name': ['Петров', 'Удалова', 'Ковалев', 'Сидоров', 'Ефремов', 'Титова'],
'Department': ['Sales', 'It', 'It', 'Sales', 'Other', 'Other'],
'Salary': [50000, 57000, 62000, 45000, 59000, 70000]}
df = pd.DataFrame(data)

Создаем новый столбец '%' – процент з/пл сотрудника к общей з/пл отдела. А почему бы и нет, что называется.
df['%'] =
df.groupby('Department')['Salary'].transform(lambda x: x/x.sum())
Этот код создаст новый столбец, который посчитает % зарплаты каждого работника к общей з/пл отдела. Функция transform() применяется к столбцу Salary каждой группы, сгруппированной по полю Department.

А еще можно сделать вот что
df['min'] =
df.groupby('Department')['Salary'].transform('min')
И напротив каждой строки будет указана минимальная сумма з/пл в отделе. Также можно посчитать максимальную з/пл, среднюю и общую сумму в отделе (max, mean и sum).

P.s. Хотите такого мультяшного персонажа? Заливаете свое фото и получаете через минуту 🔝
https://imagetocartoon.com Можете в комменты кидать своих персов, чтобы веселее было 🤩
  • 👍 20
  • 🔥 3
  • ❤ 1
Post #58 2.33K
Фантастический сumsum() ⭐️

Если нужно посчитать кол-во дней от момента регистрации клиента до первых 100 тыс. за месяц, то можно сделать это через волшебную, фантастическую функцию сumsum. 🐍
SQL выгрузкой вытаскиваем данные о номере клиента, дате его регистрации, дате оплаты, ну и сумму его выручки конечно. Отсортировано по order by account_id, payment_date. То есть сверху будут самые ранние даты выручки. Получаем вот такой df с колонками:
|account_id) | account_reg_date |payment_date|amount|

✏️ Группируем по аккаунту, создаем новую колонку с кумулятивной суммой, то есть которая накапливается (см.пример на скрине)
df['cumsum_amount'] = df.groupby(['account_id '])['amount'].cumsum()

✏️ Потом мы оставляем только те строки, где накопленная выручка больше или равна ста тысяч
df_100k = df[df.cumsum_amount >= 100000]
Продолжение ->
  • 👍 10
  • 🔥 3
  • 😍 1
Post #57 2.82K
Вопросы с собеседований по SQL

📍 В чем разница между сount(*) и count(колонка)?
count(*) считает все строки, в т.ч. с NULLs, а count(колонка) нет.
Как пример, привела скрины dbeawer из базы. Есть колонка first_payed_product_at с пропусками. В варианте count(*) считается все, а в варианте count(first_payed_product_at) только заполненные строки (820 значений).

📍 В чем разница между UNION и UNION ALL?
Основное различие между UNION и UNION ALL заключается в том, что операция UNION удаляет дублированные строки из результирующего набора, а UNION ALL не удаляет дубликаты.

📍 Что такое OVER()? Это предложение (clause) , которое превращает агрегатные функции в оконные.

📍 Перечислите основные команды SQL. Просто перечисляете Select, From, Where, Group by, Having, Order by, если еще и оконки назовете, то вообще класс!

📍 Задачка. ->
  • 🔥 24
  • 👍 7
  • ❤ 1
Post #56 2.19K

Forwarded from Аналитика данных / Data Study

Привет!

Готовлюсь к запуску 3-го потока курса "Бизнес-анализ в IT"

Старт обучения: 21 февраля

На курсы вы сможете:
✅ получить теорию и практику по сбору требований для разработки ПО
✅ научиться детализировать требования исходя из их типа (бизнес, пользовательские, функциональные, нефункциональные)
✅ познакомиться с тонкостями работы по Agile (Scrum, Kanban) и научиться работать с системами таск-трекинга и wiki для оформления требований
✅ получить готовые и отработанные шаблоны для оформления документации
✅ закрепить все полученные знания при решении бизнес-кейса по разработке системы и сбора требований

Больше информации о курсе, формате обучения, программы уроков вы можете найти на сайте https://datastudy.ru/2

P.S. На сайте указаны неправильные сроки старта обучения, до правок еще не добрался)))

По всем вопросам можете писать мне лично. Либо заполните форму предзаписи, я вам сам напишу 😉

Заполнить форму
datastudy.ru Бизнес-анализ в IT
  • ❤ 3
Post #55 1.73K
🎯 Еще один канал для всех кто увлекается аналитикой данных, data science, бизнес-анализом.
Post #54 1.93K
Отвал клиентов сиквел

Помните задачку по отвалу клиентов? https://t.me/analysts_world/51
Так вот теперь есть продолжение к той задаче. На этот раз нужно собрать ту же статистику, но по отвалу клиентов, админы которых входят в несколько определенных групп. ✅
Каждый свод код оставляйте с комментариями, чтобы потом вспомнить, что вы делали и если нужно накрутить на него еще дополнительный скрипт 😜

Сначала мы опять смотрим клиентов, кто покупал тарифы. Опять ищем sql запросом (датафрейм df_finish), все оплаты тарифов с января 2022 года.

Потом находим кто у них является админами df_admins. Ищем админов, которые входят в интересующие нас группы df_in_groups и мерджим с df_admins.
df_merge1 = pd.merge(df_admins,df_in_groups, on = ['user_id'], how = 'left').fillna(0)

Получаем такую табличку. В in_group будет 0 или 1, то есть админ входит в группу или нет
user_id | account_id | in_group

Теперь можем составить список аккаунтов, у которых кто-то из админов в группах.
accounts_list_groups = tuple(set(df_merge1[df_merge1['in_group'] == 1]['account_id']))

Оставляем клиентов из df_finish, которые входят в этот список с помощью isin
df_finish_in_groups = df_finish[df_finish['account_id'].isin(accounts_list_groups)]

Есть еще способ c query. К списку приписываем @ и тогда все срабатывает также
df_finish_in_groups=df_finish.query('account_id in
@accounts_list_groups')

А потом уже делаем все по клиентам как в прошлый раз, группируем и пр. 🍀
df_part1_in_group = df_finish_in_groups.groupby(['month'],as_index = False).agg({"account_id":"count"})
  • 👍 4
  • 🔥 1
Post #53 1.9K
Для бизнес аналитиков канал подъехал, берите на пользу!

Канал с материалами про процессы, проекты и управление.
Статьи, книги, блоги, стандарты, конференции, эксперты и практические наработки.
На канале есть база знаний, которая формировалась около 3-х лет о процессах, проектах, изменениях и управлении:
Канал: https://t.me/timethod
База знаний (карта): https://miro.com/app/board/uXjVPMeMjGI=/
Владелец канала: https://t.me/timethod1
Развиваю его потому, что в какое-то время мне надоело то, что у нас происходит в стране с процессным управлением и культурой руководства.
Цель канала - распространять знания, инструменты, подходы, технологии области процессного управления для стабильного, прибыльного, сконцентрированного развития организаций нашей страны. Бесплатно. Доступно. Качественно. Без надувания экспертных щёк)

Приходите, всем будем очень рады!
Telegram Процессы BPM, проекты PM, архитектура предприятий EA, стратегия ЧАТ - https://t.me/timethod2 Процессы, проекты, производство, архитектура, стратегия (EA; BA): шаблоны, статьи, книги, метод, практика, анализ рынка, опыт, эксперты, обзор выполненных проектов #BPM #BPMS #BPMN #PM #LEAN #KANBAN
  • 👍 9
  • 🔥 3
Post #52 1.83K
Хочется красиво..
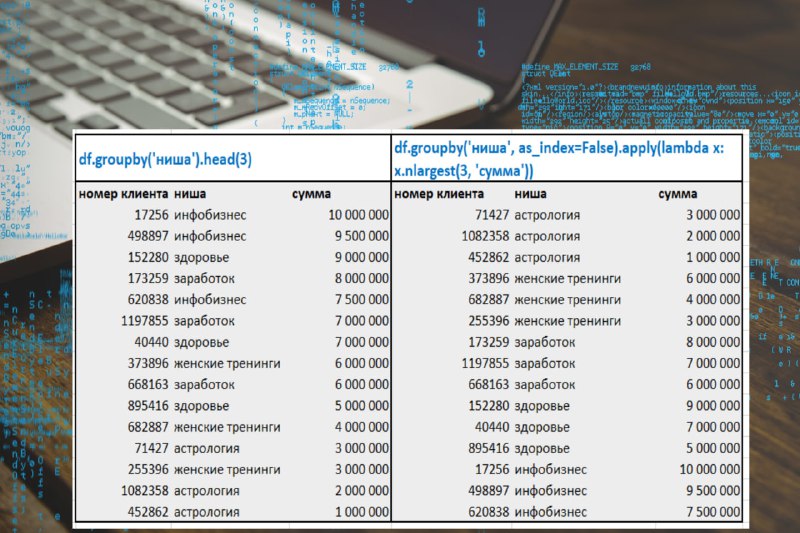
Задача была следующая – вытащить три топ клиента за год в каждой нише. Сначала – sql запросом (с сортировкой order by 3 desc по уменьшению) сформировала выгрузку всех клиентов с оборотом и с указанием ниши. Получилась такая табличка (df):
номер клиента | ниша | сумма
А вот потом задумалась, а как мне взять топ три клиента из каждой ниши. Просто head мне же даст первые три школы из всех, они могут быть из одной ниши. Не подойдет.
Я сделала быстро и надежно
df1 = df[df['ниша'] == 'инфобизнес'].head(3)
df2 = df[df['ниша'] == 'астрология'].head(3)
И так по каждой нише, а потом concat просто их все соединила.

Позже "потыкавшись", поняла, что все-таки groupby срабатывает и даже справляется быстрее. Особенно когда много категорий, то задолбаешься их соединять.
df.groupby('ниша').head(3) выдает трех клиентов в каждой нише в порядке убывания сумм по клиенту. На картинке слева.
А еще крутой способ потом обнаружила с помощью lambda и nlargest:
Продолжение->
  • 👍 22
  • ❤ 3
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →