TGViewer
Channel Public Channel
AI.Insaf

AI.Insaf

@ai_tablet

Личный канал Инсафа Ашрапова
Исполнительный директор по исследованию данных в банке (aka Lead DS) — @insafq
Здесь про AI, менеджмент, личные истории и многое другое
Subscribers
1.19K
Photos
194
Videos
0
Links
86

Showing posts older than #236 · Back to latest

Older Posts 20 shown
Post #235 674
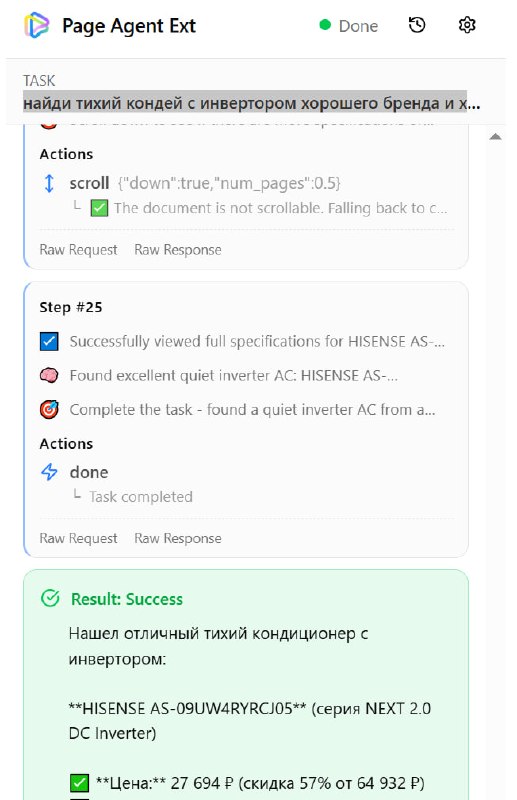
Потестировал новый PageAgent от Alibaba

Это open-source браузерный AI-агент, который умеет самостоятельно работать с сайтами: понимать интерфейс, двигать курсор, кликать по элементам, вводить текст и выполнять многошаговые сценарии. Для быстрого старта разработчики уже предоставляют доступ к Qwen, так что ключик к api не нужен

Запускается очень просто, но если использовать версию по ссылке, то PageAgent.js рассчитан только на текущую страницу (SPA - Single Page Application). Для переходов между страницами нужен Chrome Extension, и лучше сразу использовать его, иначе при навигации теряется JS-контекст и агент забывает состояние.

Работает неплохо: мышкой двигает, тексты пишет. Ради эксперимента попросил выбрать кондиционер на Яндекс.Маркете. Самое забавное - он выбрал ровно ту же модель, что рекомендует AI Алиса в Маркете (хотя на это ушло заметно больше времени, и сам я в итоге выбрал другую модель).

В целом интересная история для автоматизации через браузер, особенно если нет нативных интеграций с нужным сервисом или готовых инструментов (tools). Но это долго и дорого и нужна API к LLM
  • 👍 8
  • ❤ 6
  • 🤔 1
Post #234 688
AI-кофе с робо рукой: Чита - Москва 1:0 по внедрению ИИ 😎
  • 😁 10
  • 🥰 2
  • 🤔 1
Post #233 883
Corporate Bullshit Receptivity Scale (2026г)

Статья исследует, почему часть людей воспринимает бессодержательные корпоративные формулировки (где много разных buzzwords) как значимые и умные, и предлагает инструмент для измерения этой склонности. Как итог более высокая восприимчивость к корпоративному bullshit связана с более низкими показателями аналитического мышления и когнитивной рефлексии. Все выводы конечно получены на основе корреляций, а впрочем 😁
  • 😁 14
  • ❤ 3
  • 🤝 1
Post #232 1.27K
*это только документацию прочитал
  • 😁 11
  • 🫡 2
  • 🤪 1
Post #231 1.02K
AI.Insaf Я проиграл Волендеморту 🤩 В мае проходило соревнование от Avito "ML CUP 2026" по предсказанию наиболее релевантных объявлений, с которыми пользователь проконтактирует. Казалось бы, обычный рексис: за несколько вечеров выделил, построить несколько бейзлайнов.…
*Уроки промтинга от топ участников
  • 😁 8
  • 😎 2
  • 🤝 1
Post #230 866
Я проиграл Волендеморту 🤩

В мае проходило соревнование от Avito "ML CUP 2026" по предсказанию наиболее релевантных объявлений, с которыми пользователь проконтактирует. Казалось бы, обычный рексис: за несколько вечеров выделил, построить несколько бейзлайнов. Честно, не погружался сильно в задачу и метрику, которая оказалась хитрее, чем я думал. Там щедро залили данных на 40 гб, я попробовал базовые ALS (а надо было covisit + bm25, даже тут, aka item-to-item), эвристики, двухбашенные подходы и ранжирующие модельки (спойлер: работало все примерно одинаково и сильно отставало от топов).

Как рассказали победители, нужно было строить графовые (pixie и RP3Beta и упомянутые covisit) лидогенераторы, но да, ранжировать потом бустингом. Интересно, что полезно было для реранкера сделать поменьше кандидатов (с 10к до 5к). Про решения можно посмотреть тут

PS Причем тут Волендеморт, а он был в топе и я его не смог обойти 🫡
YouTube 30 мая — Data Fest 2026 / Соревновательный трек AvitoTech х Data Fest 2026, день 8: офлайн в Москве 30 мая В программе данной трансляции доклады: • ML & Education от сообщества ODS • соревновательный трек AvitoTech ML CUP 2026 и не только! Полное расписание: https://ods.ai/events/fest2026-avito-msc/schedule…
  • ❤ 4
  • 🔥 3
  • 👍 1
Post #229 667
NVIDIA DGX Spark vs Macbook

NVIDIA DGX Spark не прошло и года можно купить на wildberries, обойдётся в 500к+, например, тут (и его действительно привозят). Звучит неплохо, с учетом того, что там 128 ГБ объединенной памяти (unified memory), архитектура Blackwell и возможность запускать модели до 200B параметров локально.

Но за аналогичную стоимость можно взять MacBook Pro M4 Max (например, здесь), и памяти там будет столько же. Забавно только, что у Макбука скорость памяти в 2 раза выше (546 ГБ/с против 273 ГБ/с у NVIDIA) и по бенчам скорость тоже будет больше. Более того даже TDP у мака в два раза лучше (120W против 240W) 😁
  • 👍 7
  • 😁 6
  • 🗿 2
  • ❤ 1
  • 🔥 1
Post #228 845
Интересный проект для вайбкодинга https://freebuff.com/ с бесплатными лимитами и без ограничений по токенам, действительно работает. На деле - 5 сессий по часу каждый день. Доступны DeepSeek и MiniMax. Сам сервис говорит, что внутри ваш код не читает, но, как видно на скрине, живет за счет рекламы. Звучит интересно, но часовые сессии обрываются, и для чего-то долгого (например, обучения) им не воспользуешься.

Установка: npm install -g freebuff
Запуск: freebuff

Доступные модели (неплохие, но вы будете помогать их обучать):
- DeepSeek V4 Pro: smartest. Its API collects data for training.
- Kimi K2.6: balanced.
- DeepSeek V4 Flash: most efficient. Its API also collects data for training.
- MiniMax M2.7: fastest.


PS Написал письмо разработку с вопросом: Is it spyware or a trojan?
  • 👍 4
  • 😁 2
  • 🤝 1
Post #227 876
Займись ничем 😐: система долгосрочной продуктивности

Достойная книга про пользу прокрастинации. Внутри:

• Метаисследования когнитивной нагрузки: Автор ссылается на разные исследования, которые показывают: что непрерывный фокус перегружает префронтальную кору

• Активация Default Mode Network (DMN): Если не думаешь над чем-то активно, мозг переключается в пассивный режим. В этом состоянии обработка накопленных данных и структурирование опыта идут интенсивнее, чем в активной фазе, - легче поймать инсайты. Немного противоречит п. 1, но ок
  • 👍 9
  • 😁 2
  • ❤ 1
  • 🤔 1
Post #226 836
Интересное исследование от Стэнфорда

Найм сейчас проседает в первую очередь за счет джунов (entry-level позиций). Причем сильнее всего досталось разработке и клиентской поддержке, так как они проще всего поддаются автоматизации (похожие домены получаются 😁)
  • 👍 6
  • 😢 2
  • 👻 2
  • 🫡 1
Post #225 837
AI как coding agents, переписать письмо или помочь сделать аналитику или проверить какие то факты. А как насчет создания реальной добавленной стоимости 😅?

Последнее время использую chatgpt для готовки, начиная с 5й версии уже хорошо работает с граммовками и специями. Классно получился кимчи, или как додуматься пожарить редис и сделать radis sauté au beurre 👩‍🍳
  • ❤ 12
  • 🔥 8
  • 😁 1
Post #224 876
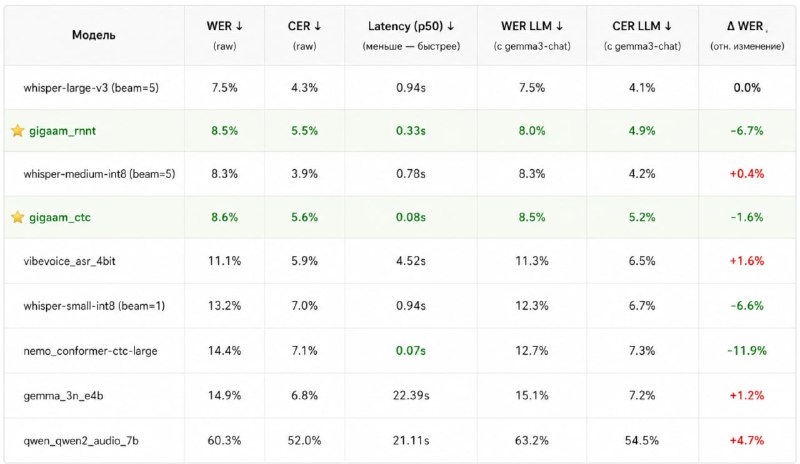
Russian Speech-To-Text

Cделал небольшой бенч как работают разные speech-to-text модели. Было интересно, придумали ли что-то лучше Whisper (он всё ещё хорош, и его легко развернуть). Но очень порадовали метрики и скорость работы GigaAM-RNNT и GigaAM-CTC (про них можно почитать тут). Но если тезисно CTC: Connectionist Temporal Classification - предсказывает один символ на каждый кадр аудио, потом жадный/beam search декодинг. А RNN-T: Recurrent Neural Network Transducer - авторегрессивная модель, генерирует токены последовательно с учетом контекста.

• GigaAM
модели получилсь на порядок быстрее Whisper при сопоставимых метриках.
• А вот мультимодальные модели работают долго, и качество у них проседает: возможно, нужно использовать более жирные версии, но это уже вне рамок данного исследования

• Использованная версия qwen не знала русского, метрики грустные получились

✍️ Как бонус применить llm для постпроцесинга улучшает качество на очевидных ошибках

(WER - word error rate, CER - character error rate)
  • 🔥 8
  • ❤ 3
  • 👍 3
Post #223 889
Коллеги по работе написали интересную штуку, которая оборачивает HTTP-трафик через SSH на серваке. Удобно, например, чтобы получить веб-доступ к запущенному Claude коду

Преимущества websh:
– Не блочится в корпоративной сети
– Держит сессию даже при закрытии вкладки
– Легковесный

код и как запускать https://github.com/dolonet/websh
GitHub GitHub - dolonet/websh: Powerful web-based SSH terminal. Zero dependencies, no build step. Powerful web-based SSH terminal. Zero dependencies, no build step. - dolonet/websh
  • 👍 9
  • 🔥 3
  • ✍ 2
  • 🤔 1
Post #222 989
Получил 100 триллионов токенов от Xiaomi (не одним пылесосом едины)

PS не все мне, но всё равно достойно 😐
  • 😁 14
  • 🔥 8
  • 👍 1
Post #221 1.11K
💀
  • 😁 18
  • 🤯 2
  • ❤ 1
  • 🤝 1
Post #220 1.92K
Сходил на конференцию AI Conf доклады хорошие, и все про агентов. Про классический ML уже и не рассказывают

1. Про публикации докладов индустрии на A конференциях*: удивительно, но среднее время публикации 9 месяцев. Тк можно несколько раз проходить ревью на разных конференциях и последовательно улучшать работу. Все давно используют LLM для кода, ревью, обзорных статей и т. д. - то, что еще в Q3 прошлого года не работало. Но вот придумать что-то новое у LLM пока не получается: пробовали оставлять их подумать на пару недель - дорого и неэффективно, но, думаю, это вопрос времени. Интересная гипотеза: в будущем к статье будет прилагаться zip-архив экспериментов, которые AI сможет детально проверить, и вся ценность будет заключаться в идее.

2. Сходил на два воркшопа. По построению search-агентов (ReAct с бесплатными API Groq + Tavily для поиска, который дает 1000 бесплатных запросов в месяц). И еще один как строить мониторинг с langfuse.

3. Если в прошлом году еще спорили, чем отличается LLM-решение от агентов, то теперь придумали Agent Harness (например, Deep Agents - там сразу и память, и скиллы вместо тулзов). Работает достойно, но создание скилла на основе готового минус 2 млн токенов, а один вызов еще минус 100к. Понятно, что надо смотреть по метрикам, но токенов кушает достойно. В качестве альтернативы Langfuse посмотрели Arize Phoenix - удобно, что он сам всё оборачивает и так же можно смотреть трейсы.

4. Интересный доклад про голосовых агентов, в том числе для телефонии. Voice-to-voice модели - это удобно, но для них пока нет туллинга и контекстом сложно управлять. Из-за этого всё еще работает связка Speech-to-Text -> LLM -> Text-to-Speech. Но приходится добавлять модели, которые определяют, когда человек перебивает бота. Из-за пауз моделька может начать анализировать ответ раньше времени, а значит, нужно сегментировать речь - а это еще дополнительные модели и рост latency. Плюс нужно нормализовать текст после Whisper, который, если слышит музыку, любит галлюцинировать (транскрибировано димон). Сложный домен. А если сервишь сам, то приходится выбирать между Ray Serve, vLLM и Triton Inference Server и что-то еще.

5. Создание контента. Был блогер с YouTube-канала, который отдал на откуп LLM почти всё: от обложки и сценария до самого контента. Оставил только человека в кадре, который читает текст. Теперь сразу понятно, какой контент был создан именно так (спойлер: там, где на обложке капс и слишком кричащий заголовок).

P.S. Еда по талонам, а там - котлетка с пюрешкой. Как так-то?
  • ❤ 7
  • 🔥 4
  • 👍 3
  • 😁 2
Post #219 718
Это первое приседание, где отсеял часть решений
  • 👍 5
  • ❤ 3
  • 🤔 1
Post #218 877
RAG SOTA benchmarks

RAG как инструмент подключения базы знаний и обогащения контекста для LLM - это база. Классический пайплайн обычно включает в себя Hybrid Retrieval с разными фильтрациями (BM25 + семантика + другие способы построения ретривала) и хитрым Context Engineering. Все это заправляется реранкером и сжатием контекста через суммаризацию. Еще можно поработать с самим запросом (Step-back prompting), чтобы помочь ретриверу. Можно также добавить агентности, если много времени (с планнингом, инструментами поиска данных и итеративным ретривером).

В твиттере активно продвигалась история с графовыми RAG и PageIndex как альтернатива векторным базам. Вот как раз lightRAG - хитрая история о том, как собрать базу знаний в граф.

Еще, если поискать, по RAG есть интересная статья - RAPTOR. Как некое развитие графовой истории, это про использование дерева с кластеризацией листьев и последующей суммаризацией самой LLM.

Давайте соберем все это вместе, назовем SEQUOIA (раз уж она про деревья) или Semantic-Evolved QUery-Optimized Iterative Abstraction, сделаем свой бенчмарк и посмотрим, как это выстрелит. Да, LLM будет локальная и немного слабоватая, но все равно на тесты я потратил в сумме более 20 часов работы своей машины.

Результаты ошеломляющие 💃: LlamaIndex и LightRAG работают слабо - получается прогрев, а вот наша SEQUOIA - SOTA.

Детали исследования тут https://github.com/Diyago/rag-benchmark/tree/main

Проверенные методы:

No-RAG — Direct LLM generation without retrieval (baseline)
Classical RAG — Dense retrieval (BGE-small + FAISS) -> LLM
Hybrid RAG — BM25 + Dense + RRF fusion + cross-encoder reranker -> LLM
LightRAG — Key-value extraction graph + dense retrieval hybrid
PageIndex — Two-stage hierarchical retrieval
GraphRAG — Entity graph + dense fallback
Agentic RAG — Multi-step reasoning pipeline
SEQUOIA — RAPTOR tree + step-back prompting
SEQUOIA Pro — Multi-query + rerank + compression
  • 🔥 10
  • ❤ 3
  • 🤯 1
Post #217 796
Внедряем 🙂
  • 😁 19
  • 💯 5
  • ❤ 3
  • 🫡 2
  • 😢 1
Post #216 766
Вот все уповали на китайские модели, а там подписки стоят ничуть не меньше. Вот z.ai с glm 5.1 подняли цены сразу в два раза до $160 за макс подписку (лучшие в опенсорсе)
  • ⚡ 5
  • 😢 4
  • 🫡 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →