TGViewer
Channel Public Channel
AI.Insaf

AI.Insaf

@ai_tablet

Личный канал Инсафа Ашрапова
Исполнительный директор по исследованию данных в банке (aka Lead DS) — @insafq
Здесь про AI, менеджмент, личные истории и многое другое
Subscribers
1.19K
Photos
194
Videos
0
Links
86
Recent Posts 20 shown
Post #255 277
Хороший друг Никита Зелинский со школой ml inside запускает курс по AI-агентам для продактов: https://ai4products.mlinside.ru

Там про применение AI-агентов в продуктовых задачах: исследование рынка, конкурентов, анализ данных и тд. Ребята сильные, уверен что курс хороший 📈
Telegram Дата канальи Данные / ML / AI / аналитика в корпорациях. Для связи @NikitaZelinskiy
  • 👍 8
  • 🔥 5
  • ❤ 3
Post #254 481
Agents Trust Tools Too Much (arxiv)

Почему-то агенты слишком доверяют вызовам тулов как единому источнику правды, даже если понимают, что это не бьется с предполагаемыми результатами. P1/P2/P3 просто разные уровни ложности возвращаемого тулом тезиса, но итоговый результат: принятие для условного DeepSeek Flash V4 до 50% (модели слабоватые, но результат показательный). Авторы попробовали разные решения: промптинг тула и его надежности работал плохо, общий промптинг, что агент проверял результат тула, в целом работает, но очень плохо для поиска. Fine-tuning с SFT/DPO (дорого и плохо). В итоге хорошая стратегия: просить указывать все противоречия

В общем, с доверчивостью LLM к ошибочным данным есть вопросики (см + прошлые посты)
  • 👍 5
  • 🔥 4
  • 🤔 3
Post #253 429
Measuring LLM Sycophancy under Sustained Multi-Turn Pressure (arxiv)

Сложное название для простой идеи: что, если достаточно долго LLM убеждать в какой-то мысли, она согласится, и обычно надо до 25 шагов диалога. И для этого нужна умная моделька, а не такая, которая после 10 сообщений обрезает контекст. Для этого использовали другую LLM, которая очень по-разному пыталась изменить свою позицию. Причем deepseek V4 pro согласие достигает 92% к 25му шагу, и даже gpt 5.6 будет уже через 10-15 шагов соглашаться с половиной ошибочных тезисов

Звучит как первый ответ самый честный, и не нужно переубеждать
  • 👍 6
  • 🔥 2
  • 🤔 2
Post #252

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 4
  • 🤔 2
  • 👍 1
Post #251 669
MemTrapBench: Benchmarking Cognitive Traps in LLM Memory Use (arxiv)

Забавная статья, в которой исследуют влияние памяти в LLM.

Обычно и часто проверяют точность, полноту и релевантность извлечения. Но нужно еще проверять общие бизнес-метрики. И о чудо: если память нерелевантная, например все кейсы были про output с XML, а сейчас простой базовый вопрос, то это роняет метрики.

Например, для Gemini 3.0 Flash без памяти средний score 85,2%, а с разными memory-подходами он падает до 54,7-71,2%.

Решение в проверке необходимости текущей памяти модели.
  • 🔥 4
  • 👍 2
  • 😁 2
Post #250 599
Feedback That Backfires arxiv

Контринтуитивный вывод в статье. Дефакто в harness-решениях в рамках react цикла при возникновении ошибок обычно ошибочный вызов кладут в контекст и говорят, что его нужно исправить. У авторов добавление такого контекста увеличивало вероятность повторной ошибки с 6% до 54% (эффект наблюдался на всех протестированных моделях, но это были небольшие модели, до 1,7B).

Причем в попытке выяснить почему оказалось, что сам факт видения похожей строки увеличивает вероятность ее повторения, а добавление информации о том, что она завершилась ошибкой, дает небольшой дополнительный эффект. Причем эффект наблюдается для всех исследованных типов ошибок.

Решение: нужно просто перефразировать ошибочное место. В больших моделях, предположительно, примерно с 38B эффект нивелируется, но это пока только их экстраполяция

Хотя в статье Outcome Monitors: Recovery Affordances for Silent Tool Failures предлагают в сообщение об ошибке добавлять информацию о том, как именно решить проблему через указание recovery tools. Тогда доля успешных решений растет с 10% до 28%.
  • 👍 6
  • 🔥 4
  • 🤔 3
  • ❤ 1
Post #249 491
AI.Insaf Через подписку Cursor получил доступ к Grok боту, эдакому аналогу OpenClaw. Казалось, что вряд ли он сможет удивить сильнее обычного чата. Но оказывается они дают под этого ассистента выделенную виртуалку: на ней 8 ядер, 16 ГБ RAM и еще 100 ГБ диска (можно…
это он мне выбирает новый стол на кухню 👍
забавно что это не просто логи
  • 🔥 4
  • 😁 2
Post #248 489
Через подписку Cursor получил доступ к Grok боту, эдакому аналогу OpenClaw.

Казалось, что вряд ли он сможет удивить сильнее обычного чата. Но оказывается они дают под этого ассистента выделенную виртуалку: на ней 8 ядер, 16 ГБ RAM и еще 100 ГБ диска (можно ли там что-то хостить?)

Очень интересно, но сложно придумать юзкейсы. Когда попросил его найти интересные статьи для канала, он нашел ту, которая ставит под сомнение human-in-the-loop: якобы такой подход заставляет LLM чаще соглашаться с человеком там, где этого делать не нужно. Это произошло еще 31 августа.

Сегодня, когда сел ее почитать, оказалось, что статью уже отозвали и она больше не подтверждается еще с 1го сентября. А ведь мог бы и перепроверить 😒

+ Удивил что бот в виртуалке бот прямо читал мой канал. Магия 🧙‍♀️
  • 😁 4
  • 👍 3
  • 🔥 3
Post #247 675
Хорошие курсы от самого LangChain, дошли руки пройти Deep Agents (лекции + лабы). Это их собственное решение по harness. Плюсы - гибкость и возможность самому управлять всеми частями. Интересные опции: injection в state нужной информации, от памяти до tool usage или todo plan. Или вместо того, чтобы промптить с user_id, сразу самому подставлять его в вызов tool как параметр. Внутри разные guardrails по количеству вызовов tools, циклов работы субагентов и тд

И в целом там остальные курсы тоже хорошие
  • 👍 11
  • ❤ 4
  • 🔥 1
  • 💅 1
Post #246 835
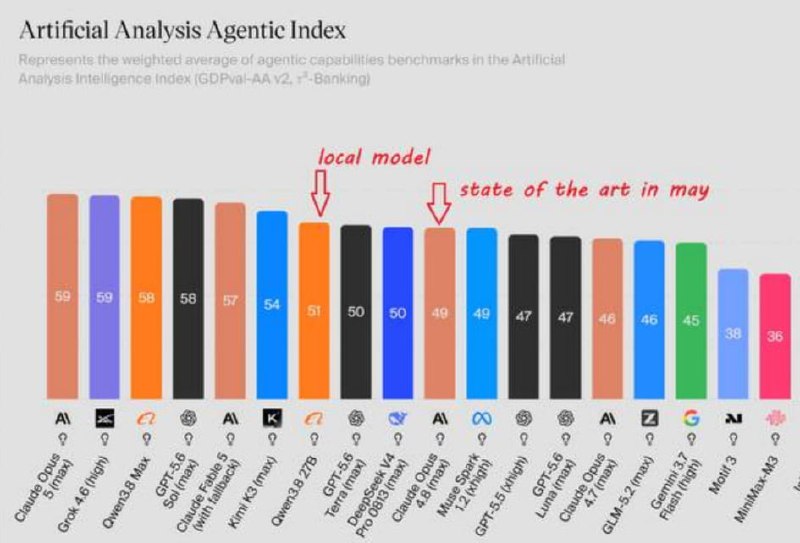
Хотел почеленджить ребят на работе, что развернуть модельки просто. А именно попробовав серверные истории SGLang, vLLM или Triton. А вот от llama.cpp отказался, тк больше про локальный инференс, хотя через lm studio было бы легко

Но везде оказались свои подводные камни. И как итог, Qwen3.8-9B-GGUF (Q4/Q5) вообще плохо поддерживается vLLM. Патч под Qwen 3.5 от некого чувака, который 24 часа делал его на Fable, тоже не помог. Плюс были проблемы с CUDA DLL и ZMQ.

При этом исходные оригинальные веса зачастую требуют слишком много памяти, а квантованные, которые собирают сторонние люди, уже поддерживаются заметно хуже.

Потом попробовал Gemma 4 E4B (safetensors и QAT самые разные версии), но vLLM и SGLang тоже не завелись из-за проблем с совместимостью compressed-tensors и мультимодальными особенностям, спасибо еще heterogeneous attention head dimensions

PS qwen 3.8 27b локально это прогрев
  • 🫡 4
  • 💅 2
  • 😁 1
Post #245 631
  • 😁 13
  • ❤ 4
  • 😍 1
Post #244 751

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 7
  • 😁 3
  • 👍 2
Post #243 942
Новая библиотека SIRIN для оценки и мониторинга contextual hallucinations в RAG и memory-based LLM системах (статья arxiv + github )

Идейно внутри три инструмента:
- probing по hidden states - легкий классификатор по hidden states генератора но нужно немного разметки
- LLM-as-a-judge. Есть response-level и span-level варианты, где модель пытается локализовать конкретные галлюцинированные фрагменты.
- uncertainty (entropy, perplexity, semantic uncertainty) - разные технические метрики как baseline, но обычно хуже чем LLM-as-a-judge

И два гейта:
1) до ответа: хватает ли контекста (Answerability gate)
2) после ответа: не наврал ли относительно контекста (Faithfulness gate)


- С учетом всего этого можно считать разные метрики качества. Еще у ребят неплохо получилось улучшить метрики на на memory-агенте повесив два гейта, и при непрохождения заставляя еще раз идти думать (метрики точности с 62.4% до 79.3%)
- Кастомный judge под задачу часто нужен все равно, но решение хороший baseline
  • 👍 11
  • 🔥 3
  • 🤔 2
  • ❤ 1
Post #242 697

Forwarded from AbstractDL

Ouroboros теперь SOTA на Terminal Bench, OSWorld и CL-bench

Мой любимый агентный луп на чистом питоне доэволюционорал до состояния лучшего харнесса для кодинга! На главных бенчмарках он теперь обходит Codex, Claude code, Cursor и Hermes.

Выходит, что в рисёрче, в computer use, в работе через терминал и в задачах на кодинг — уроборос сейчас является лучшим агентом. Так что с этого момента всю разработку и исследования я веду только через уробороса.

Для полной воспроизводимости результатов. Весь код, скрипты, трейсы я выложил в открытый доступ.

Напоминаю: лицензия MIT. Так что спокойно ломайте, форкайте, проверяйте трейсы, пишите что я где наврал. И кидайте issues и PR-ы! Все постараемся с уроборосом принять😋

P.S. Кошмар какие дорогие агентные бенчи. Прогнать весь набор стоит как квартиру купить (это не шутка!!)

GitHub, Хабр, установочники
  • ❤ 6
  • 🫡 6
  • 🔥 4
Post #241 679
Все еще сидите на codex и claude code. А как насчет уробороса 🤌🏻

ps человек отдал 50к $ чтобы прогнать все бенчи
  • 😁 9
  • 🤔 1
Post #240 985
Придумали еще скилл, который создает скилл по книгам (Book-to-Skill - 10k ⭐️). По сути, зумеры заново изобрели оглавление.

Собрал такой скилл по книге "Братья Карамазовы" и спросил: что будет с AI? Ответ со смыслом:
Не к сознанию, как у Ивана, и не к святости, как у Алёши, а к институту опеки с лицом чуда. Пока свобода не станет дороже комфорта и явным выбором

- если главный KPI — снятие тревоги и принятие решений за человека → Великий инквизитор;
- если KPI — усиление свободы и ответственности конкретного человека → старец в миру.

Но если книгу не читал, то ответ вызывает еще больше вопросов. А если читал - то зачем вообще нужен этот скилл? Заставляет задуматься
GitHub GitHub - virgiliojr94/book-to-skill: Turn any technical book PDF into a Claude Code skill — ready to study, reference, and use… Turn any technical book PDF into a Claude Code skill — ready to study, reference, and use while you work. - virgiliojr94/book-to-skill
  • 😁 5
  • ❤ 4
  • 🔥 1
  • 🫡 1
Post #239 888
Harness evaluation - deepeval

Кто-то, возможно, начинает разработку harness решений и скиллов для них. Стало интересно, какие инструменты можно использовать для тестирования качества.

Если для RAG многие использовали Ragas, то для LLM и агентов активно применяются решения для трейсинга, например Langfuse и Phoenix. Однако они больше про observability, хотя на их основе также можно прогонять выборки и анализировать качество. Но нужно что-то для harness и такое есть, DeepEval, спойлер с ним можно и все выше.

Но так или иначе все сводится к одному: прогнать набор тестовых сценариев, сравнить результат с эталоном или заданными критериями, проверить качество контекста и оценить корректность вызовов тулов

PS в итоге наверняка что-то кастомное 😅
Deepeval DeepEval - The LLM Evaluation Framework DeepEval is the open-source LLM evaluation framework for testing and benchmarking LLM applications.
  • ❤ 6
  • 👍 5
  • 🔥 1
  • 🤔 1
Post #238 884
Прикольно, что Cloudflare позволяет без регистрации за пару секунд поднять статический сайт - просто перекинув ZIP-архив.

А если зарегистрироваться, то уже можно бесплатно хостить небольшие проекты. Да, собственного домена не будет, но возможность управлять всем через API - мое уважение. Вот сделал инглишь реплику канала (но надо покупать доменное имя иначе сложности с dns)


Upd еще подсказывают что можно использовать для хостинга телеграмм ботов
Cloudflare Cloudflare Drop Drop a folder or zip. See your site live on Cloudflare's global network in seconds.
  • 👍 5
  • ❤ 2
  • 🤝 1
Post #237 700

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 😁 9
  • 🤯 7
  • 🗿 3
Post #236 872
AI.Insaf UPD: Когда под анонсом в канале Яндекса я поделился своими изысканиями, мне прислали ссылку на открытый бенчмарк TabArena (см 2я картинка). Выводы там в целом аналогичны моим: метрики LightGBM статистически значимо не отличаются от TabM. Но, к удивлению,…
TabFM - придумали foundation-модель для табличных данных (что? 😅), и она SOTA на TabArena. Не прошло и года, новый лидер

В отличие от привычных LightGBM, CatBoost или TabM, она работает в zero-shot режиме: для нового датасета не требуется обучение или подбор гиперпараметров, достаточно передать обучающие строки в качестве контекста. TabFM рассматривает задачу табличного ML как in-context learning. Вместо обучения под конкретный датасет обучающие строки передаются модели как контекст. Веса модели не обновляются - достаточно одного forward pass. Архитектура сочетает идеи TabPFN и TabICL: row/column attention, компрессию строк и transformer для in-context learning. Модель обучали на сотнях миллионов синтетических таблиц, ибо открытых данных мало. Из минусов - лицензия только для некоммерческого использования

Удивительно, но это действительно работает. Во всех моих экспериментах TabFM показал качество выше, чем бустинги, даже без какого-либо обучения под датасет. Причем на самом большом датасете контекст пришлось сократить из-за нехватки памяти, но TabFM все равно показала лучший результат.

Ниже - сравнение качества и времени работы. Время указано для GPU, без которого TabFM работал бы еще на пару порядков медленнее
  • 👍 13
  • ❤ 3
  • 🤯 2
Older posts →

About this channel

How can I read @ai_tablet without a Telegram account?
TGViewer shows the public web preview Telegram publishes for AI.Insaf: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does AI.Insaf have?
AI.Insaf (@ai_tablet) has 1.19K subscribers on Telegram, refreshed roughly every 30 minutes.
Does AI.Insaf know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →