TGViewer
Channel Public Channel
AI.Insaf

AI.Insaf

@ai_tablet

Личный канал Инсафа Ашрапова
Исполнительный директор по исследованию данных в банке (aka Lead DS) — @insafq
Здесь про AI, менеджмент, личные истории и многое другое
Subscribers
1.19K
Photos
194
Videos
0
Links
86

Showing posts older than #216 · Back to latest

Older Posts 20 shown
Post #215 839
В начале недели многие писали про проект Colleague Skill https://github.com/titanwings/colleague-skill - систему для оцифровки живого сотрудника в ai агента, которая зафорсилась в Китае. Люди даже придумали, как защититься от создания такого двойника

Так вот я его запустил - это по сути стилистический промт под человека, который подключается как skill в Claude и собирается на основе мета-информации и переписок. На выходе человек описывается тремя файлами: стиль общения, как решает задачи, стек и т.д. (см скрин)

Красивая история. Но Claude как кодинг-агент as is уже и так уже хорош
  • 👍 4
  • 😁 3
  • 🤔 1
Post #214 956
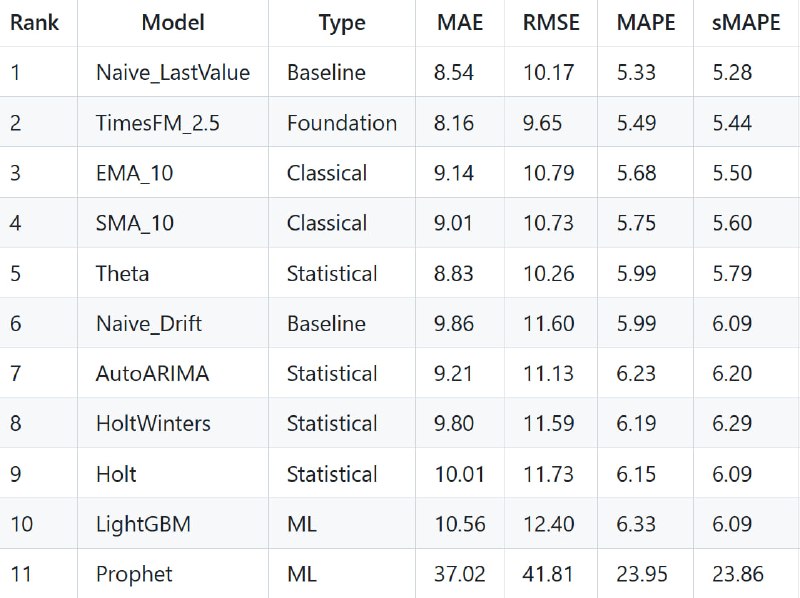
AI.Insaf Time series foundation-модели В задачах time series еще строят foundation-модели. За счет претрейна на сотнях миллиардов точек модель из коробки понимает тренды и сложную сезонность - не нужно придумывать самому признаки. Текущая SOTA от Google — TimesFM…
Получившиеся метрики
  • 🤔 7
  • ❤ 2
  • 👍 2
  • 💯 1
Post #213 1.05K
AI.Insaf Dive into Time-Series Anomaly Detection: A Decade Review (link) 📌 Обзорная статья, которая собрала ключевые наработки в области поиска аномалий за последние 10 лет. Так как по работе пришлось плотнее заняться временными рядами, думаю написать несколько постов…
Time series foundation-модели

В задачах time series еще строят foundation-модели. За счет претрейна на сотнях миллиардов точек модель из коробки понимает тренды и сложную сезонность - не нужно придумывать самому признаки.

Текущая SOTA от Google — TimesFM-2.5 (2025 год). Архитектурно это декодерная модель, в которой временной ряд бьется на патчи: это позволяет смотреть не на отдельные точки, а на динамику. Обучали ее на реальных данных и синтетике. Как итог, ко второй версии получилась достаточно легкая модель на 200M параметров.

Я решил проверить, как это работает на реальных данных (выбор пал на акции). Временные ряды - это сложно: от выбора лосса и метрик результаты меняются сильно. Удивительно TimesFM-2.5 неплоха, правда, наивное предсказание не хуже (real sota 😐), но тут делаем поблажку на домен. На картинке пример как все отработало на одном из рядов

https://github.com/Diyago/timeseries-research
  • ❤ 4
  • 👍 4
  • 🔥 2
Post #212 731
Таки поднял Clawbot (или moltbot или умный ии ассистент) - это было сложнее чем я думал. На одном из локальных VPS (там еще пришлось создавать тикеты, чтобы включили консоль 🫡). В предустановленной версии clawbot оказалась старая версия библиотеки: пришлось обновить, чтобы заработал OpenRouter. Еще история с сертами. После подключения выяснилось, что бесплатные модели в OpenRouter не такие уж и бесплатные, так что API-ключ быстро отвалился.

Потом поднял локальный Qwen (а он, на минуточку, обещал поддержку tool use). Ручками добавил скиллы с почтой и поиском (для поиска очень хотел использовать DuckDuckGo, но и это решение быстро упало по лимитам).

В какой-то момент Qwen словил амнезию, ругаясь, что не может открыть md-файлы: оказалось, tool calling падал из-за использования абсолютных путей вместо относительных. Решением был бы переход на модельку посильнее, но там проблемы с памятью и работает всё медленно, а без контекста в 200k оно тоже радостно падает. В целом, всё падает от любого поворота не туда.

Было очень весело, но пока кажется, что рано (ну или готовьтесь отстегнуть за токены): лучше использовать коробочные решения (вот у Kimi есть свои, есть GLM), но нужна подписка. Хотя, конечно, создается ощущение, что все это умнее любых чат-ботов на рандомных сайтах
  • 👍 6
  • 😁 5
  • 🔥 3
Post #211 694
20 апреля в Москве пройдет AiConf 2026

Думаю сходить сам: это конференция по Data Science с прикладной программой (мастер-классы, воркшопы).

Будут обсуждать:
• Мультиагентные системы и RAG - как их собирают и выкатывают в прод
• Работа с LLM: как добиваться стабильных и предсказуемых результатов
• Как обосновывать технологические решения бизнесу
• Экономика AI: расчет и оптимизация инфраструктуры

Должно быть достойно. Ожидается 400+ участников и спикеры из Сбера, Яндекса, VK и других команд
  • 🔥 6
  • 👍 5
  • 🙏 2
  • 🗿 1
Post #210 1.04K
Обзор что еще придумали в Open Source LLM за последние два месяца: внутри статьи хорошее сравнение архитектур и то, как авторы вдохновляются идеями друг друга

1. Почти у всех переход на Sliding Window Attention. Контекстные окна существенно растут, при этом размеры самих моделей почти не увеличиваются. Но в MiniMax M2.5 остались Grouped-Query Attention (GQA) - и выехали чисто на данных в кодинг задачах

2. Использование QK-Norm как некоего аналога RMSNorm (еще со времен Gemini 3).

3. Многие начинают строить мультимодальные модели. Например, в Kimi k2.5 претрейн на изображениях на ранних стадиях обучения оказался особенно полезен

4. Текущий опенсорс - GLM-5 от Z.ai (и это не дипсик): на момент выхода по метрикам модель была на уровне GPT-5.2/Opus 4.5 и Gemini 3 Pro. Удивительно, что внутри там доработанный DeepSeek-V2, но с измененными параметрами, особенно в части количества активных экспертов.

5. Step 3.5 Flash (внутри модель на 196B): Качество сопоставимо с DeepSeek (по бенчмаркам даже лучше, хотя на LMSYS Chatbot Arena ситуация иная), при этом модель в три раза эффективнее по скорости. Архитектурно это почти тот же DeepSeek с MoE, но с меньшим числом параметров и более продвинутым Multi-Token Prediction (генерирует 3 дополнительных токена вместо одного). Он кстати топ2 на openrouter по потреблению токенов
  • 👍 7
  • 🔥 4
  • ❤ 1
Post #209 831
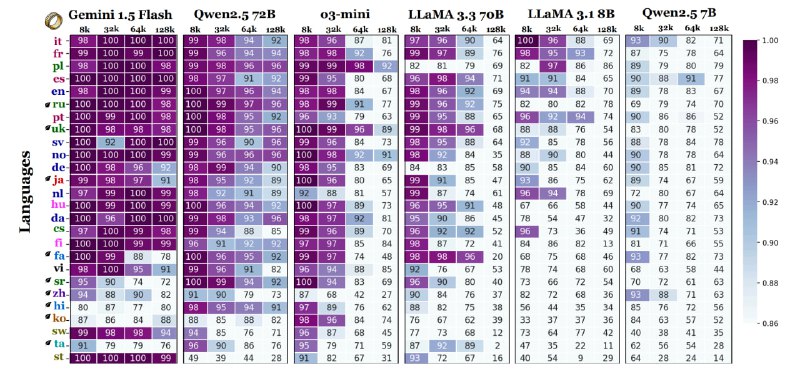
One ruler to measure them all: Benchmarking multilingual long-context language models (arxiv 2025)

В статье исследуется, как язык влияет на качество моделей. Обычно, помимо очевидных факторов, связанных с самой моделью и промптингом, влияние оказывает токенизатор. Из-за него, например, русский текст при том же объеме информации будет занимать больше токенов , чем английский. Кто-то даже из-за этого старается писать на английском.

Тем интереснее итог - лучшие результаты показал польский язык (88%), русский на 5м месте (84%), а английский 83.9%. И разница более значимая на задачах с длинным контекстом. Но не все так однозначно: тк тестировали слабые модели Gemini-1.5-Flash, Qwen 2.5 72B и тд
  • 👍 4
  • 😁 2
  • 🤔 2
Post #208 936
publish_python.17.01 .pdf1.1 MB
Выступил на локальном python митапе (было 100+ человек и обещали футболку 🤨) про публикацию решений в open source - всё сильно легче, чем кажется
  • 👍 8
  • 🔥 6
  • 🙏 2
Post #207 1.19K
Парадокс Джевонса технологический прогресс (см vibecoding), который увеличивает эффективность использования какого-либо ресурса, увеличивает объём потребления ресурса => пока живем

На графике статистика с indeed.com (кол-ва вакансий на разработчиков vs в целом вакансий)
  • ❤ 8
  • 🙏 3
  • 👍 2
Post #206 960
AI – это прогрев

Он должен был облегчить работу, но вместо этого делает её более интенсивной. В статье Harvard Business Review (от 9 февраля 2026г) как раз исследовали почему так получилось. Сотрудники берут больше задач (в том числе из-за взятия вне своего скоупа), а неявные ошибки при этом могут передаваться дальше по цепочке, мультипромтинг, использование в перерывах и тд.

Так что необходимо развивать guardrails и как то лучше оптимизировать
Harvard Business Review AI Doesn’t Reduce Work—It Intensifies It One of the promises of AI is that it can reduce workloads so employees can focus more on higher-value and more engaging tasks. But according to new research, AI tools don’t reduce work, they consistently intensify it: In the study, employees worked at a faster…
  • 💯 6
  • ❤ 5
  • 🫡 5
  • 👍 1
  • 🔥 1
Post #205 1.02K
Anthropic обвинили китайские ИИ в том, что они делали слишком много запросов (16+ млн) к их сетке через фейковые аккаунты, тем самым нарушая условия пользования, все чтобы улучшить свои модели. Но если спросить Claude ты кто на китайском, он ответит, что DeepSeek.

Главное при расследовании не выйти на самих себя 😒
  • 😁 23
  • 🤝 5
  • 🥰 2
Post #204 819
AI.Insaf Самый сложный домен в ML - это RecSys - цитата лида, который работает с рекомендациями. Какое-то время назад пришлось изучить что нового придумали в рекомендациях: • Для изучения базы и основных историй можно пройти курс от МТС, он достаточно емкий • Используемые…
LLM в RecSys только начинают использовать. В полноценных рекомендательных системах это пока выглядит слишком дорого. Так или иначе, всю базу айтемов в контекст не положить, а значит, их нужно предварительно ранжировать, что возвращает нас к классическим методам.

• OneRec / MiniOneRec (Kuaishou, 2025): Интересное решение и в open-source. Авторы первыми объединили все стадии RecSys в единую генеративную нейросеть. Проблема миллиардов ID решается через Semantic IDs (документ кодируется короткой последовательностью из 3-4 токенов с помощью RQ-VAE). Работает на 25% трафика в системе с 400 млн DAU.

• PLUM (YouTube / Google, 2025): Адаптация предобученных LLM для видеорекомендаций. Элементы кодируются как Semantic IDs, затем проводится дообучение (CPT - continued pre-training) на доменных данных. Как итог - получение более качественных эмбеддингов на огромных датасетах.

• RecAI / InteRecAgent (Microsoft, 2025-2026) и RecGPT / RecGPT-V2 (Taobao, 2025): Использование LLM в качестве оркестратора классических моделей. Решение от Taobao выглядит среди всех наиболее интересным и реализуемым: там применяется мета-промптинг, дообучение с помощью модели LLM-as-a-reward, а также LLM-as-a-judge для проверки качества тегов. В целом, это наиболее приближенное к реальности решение, которое вполне можно внедрять по частям

• PinRec (Pinterest, 2025) и LinkedIn Retrieval (2025): LLM выступает как dual-encoder для юзеров и контента. Сюда же можно отнести UniRec (2026), добавляющую мультимодальность.

• Опасности и уязвимости - RoLLMRec (2026): Продавцы могут внедрять промпт-инъекции в описания товаров и, как следствие, ломать выдачу LLM-рекомендаций. В статье рассматривается защита через RAG-валидацию и модули фильтрации


PS На картинке как раз решение от taobao
  • 👍 8
  • 🔥 4
  • 🤔 2
Post #203 789
RAG.pdf3.6 MB
Оказывается, люди уже приносят сгенерированные слайды по рабочим проектам (пока думаю еще рано так делать). Посмотрел, что можно попробовать (ChatGPT, Gemini, Perplexity) - они генерят слайды с текстом в пару предложений. А вот что нагенерил Kimi.com по способам RAG (во вложении) - достойно. Правда, лимиты там жесткие. Еще какие варианты?
  • 🔥 9
  • 👍 4
  • 😁 1
  • 👻 1
Post #202 1.02K
Взаимный Agentic Looping 😎
  • 😁 18
  • 🫡 3
  • 🗿 1
Post #201 790
Хорошая статья про computer-use агентов на базе LLM от @wrapper228 тут

• Формально LLM уже можно использовать как инструмент управления компьютером — не просто как чат, а для выполнения задач end-to-end: открыть браузер, найти данные, изменить файл и т.д. (это уже не просто генератор текста)
• Как итог - guardrails и ограничения среды становятся критичнее, чем очередное дообучение моделей. Из-за сложности задачи, наверное, снова проявляется забытый reward hacking - агент может формально выполнить цель

Очень интересно, но ждем что смогут сделать в будущем: пока дорого и не дорабатывает
wrapper228.github.io Плохое влияние computer-use окружения на адекватность LLM Исследование поведения computer-use агентов на моделях Sonnet 4.5 и Opus 4.6
  • 👍 6
  • 🔥 3
  • 🙏 1
Post #200 939
Протестировал высокозведные opensource решения для обучения: KnowNote и DeepTutor (локальные аналоги NotebookLM)

• KnowNote не заработало в полную силу (кроме режима чата), так как у выбранного эмбеддера нельзя было настроить размерность, и, соответственно, RAG там не функционировал.

• DeepTutor (с 10к ⭐️) пришлось немного помучиться с зависимостями, так как проект построен на больших библиотеках (например, LightRAG и RAGAnything), которые тянут за собой длинный хвост сторонних пакетов. При запуске через Ollama выяснилось, что POST-запросы к ней реализованы некорректно. Эту проблему я решил с помощью LM Studio (оба сервиса позволяют запускать LLM локально). Но режим генерации вопросов почему-то не работал. А функция Problem Solving иногда могла выдать неплохие ответы по загруженной PDF-ке, но чаще всего падала из-за переполнения контекста (после 36!! API-вызовов)

• Но порадовал прогресс LM Studio - есть возможность частичного инференса на GPU, если не хватает памяти
  • 👍 4
  • 🥰 2
  • 😁 2
  • 😢 2
  • ❤ 1
Post #199 875
Бесплатный API

Для тестирования агентов нужен API и токены к LLM, но это стоит денег. Оказывается, можно мимикрировать и использовать существующие подписки, не тратя токены. Например, через vibeproxy, (аналог для винды easyCli но не тестировал) причём через Continue можно даже поднять coding agent на бесплатном Qwen. Проверил - стейты в агенте тоже работают. Из минусов Perplexity не нашёл, подписка ChatGPT Go не подходит - нужна минимум Plus

ps осталось поднять clawdbot
  • 🔥 6
  • 👍 3
  • 😁 1
  • 🤝 1
Post #198 2.76K
🚀 Ищу senior DS: AI агенты + классика в HR-блок, чтобы сделать путь сотрудника лучше и технологичнее:

Middle+/Senior Data Scientist [Сбер, Блок “Люди и Культура”]

📍Москва (офис/гибрид)

Стек: Python, SQL, GigaChat, LangChain/LangGraph, numpy, pandas, pytorch, LightGBM

Чем предстоит заниматься: разрабатывать ИИ-агентов (например, ИИ-рекрутер) с использованием GigaChat; ранжировать резюме и вакансии; RecSys для обучающего контента; прогнозировать отток и внутренние перемещения сотрудников; автоматизировать HR-процессы; +прямое влияние на продукт

Откликаться на hh https://hh.ru/vacancy/129762695
hh.ru Вакансия Senior Data Scientist в Москве, работа в компании Сбер для экспертов (вакансия в архиве c 4 марта 2026) Зарплата: не указана. Москва. Требуемый опыт: 3–6 лет. Занятость: полная. Дата публикации: 05.02.2026.
  • 🔥 10
  • 👍 7
  • ❤ 4
Post #197 1.15K
В Financial Times вышла статья How to AI-proof your job про критические навыки в карьере (она, к сожалению, под paywall), но по картинке можно найти источник статьи THE GROWING IMPORTANCE OF SOCIAL SKILLS IN THE LABOR MARKET. Выводы: вклад в зарплату в большей степени за счет софтов, а не тех-скилов. В целом получается, что на одной технике и математике далеко не уедешь, и с 2010-х и раньше наметился сильный тренд на смену спроса. Например, в IT, где бы требовались только тех-скилы, спрос даже падает, так как становится важным погружение в продукт и работа в команде, т.е. больший выигрыш с софтами и тех скиллами

• Тип занятости определялся по классификатору должностей O*NET за 1998 г. Да, там нет многих современных вакансий, но это не мешает определить, в каком квадрате находится позиция: «High/Low social» × «High/Low math» (выше или ниже медианы в части необходимых навыков). При этом social определялся как проницательность, координация, убеждение, ведение переговоров (social perceptiveness, coordination, persuasion, negotiation). А math — как mathematical reasoning ability, mathematics knowledge, mathematics skill.

• Wages на графике — это рост медианных реальных зарплат относительно 1980-х в логарифмической шкале. Избавлялись от выбросов как могли.

PS кажется графики лучше перемножить, хочется верить в большую важность тех навыков
  • 🤔 8
  • 👍 4
  • 🔥 3
  • ❤ 1
Post #196 1.07K
Не зря оперативка дорожает. Или конечно мое почтение актеру (с)
  • 🤣 40
  • 😁 4
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →