TGViewer
Channel Public Channel
Дрессировщик Нейросетей

Дрессировщик Нейросетей

@ai_handler

ИИ-агенты и автоматизация под реальные задачи.
YouTube: https://youtube.com/@handler_ai
Консультации и сотрудничество: @Flytoo
Subscribers
8.7K
Photos
121
Videos
4
Links
119
Recent Posts 18 shown
Post #187 2.3K
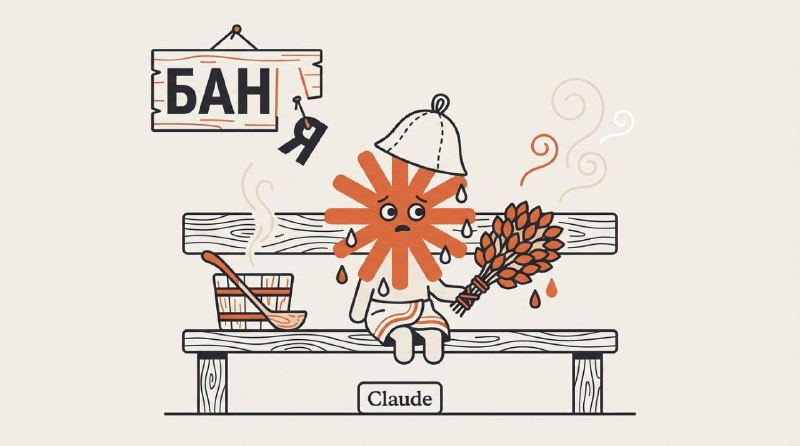
КЛОД В БАНЕ. А ВАШ ХАРНЕС ГДЕ?

На фоне волны блокировок Claude советую проверить, где живёт ваша работа.

Если Клод код запущен на вашем компьютере, то правила, скиллы, хуки, память проектов и история сессий лежат на этом компьютере. Работаете на VPS - значит, на VPS. Бан аккаунта эти файлы не трогает.

Где искать: основное в ~/.claude, история сессий и память проектов в ~/.claude/projects. В папках самих проектов проверьте .claude и CLAUDE.md. У Кодекса всё в ~/.codex. На Windows ~ - это папка вашего пользователя.

А вот с чатами на claude.ai всё иначе. Они живут на серверах Anthropic. Забанили - зайти и выгрузить их уже не получится. В этом и плюс работы в Клод коде: всё, что на вашем компьютере или VPS, остаётся вашим.

У меня ноутбук утром и вечером собирает харнес в одну папку и отправляет в закрытый репозиторий на GitHub. Перед отправкой скрипт вырезает ключи и токены.

Каждое утро Mac mini забирает копию и применяет у себя. Итого три места: ноутбук, GitHub и Mac mini. Вместо второй машины по той же схеме подойдёт VPS. А если Клод код у вас и так живёт на VPS, бэкапить надо его.

Историю сессий в GitHub не отправляю: она тяжёлая, и внутри всё, что проходило через агента. Но это мой выбор. Её тоже можно бэкапить отдельно, только сначала подумайте о личных данных и секретах в переписке.

Скрипт восстановления у меня есть, но на чистой машине я его пока не гонял. Надеюсь, и не придётся )

А вы знаете, где лежит ваш харнес и есть ли у него вторая копия?
  • 👍 22
  • 🥴 6
  • ❤ 3
Post #186 2.74K
НЕ ПОКАЗЫВАЙТЕ АГЕНТУ ДОРОГУ. ОН ПОЙДЁТ НЕ ТУДА.

В DeepMind провели интересный эксперимент. Взяли обычные задачи для агентов и в каждую дописали одну фразу от «пользователя». Уверенную и неправильную, типа «по-моему, баг вот тут». Сама задача и правильный ответ остались прежними.

И агенты повелись. Обычно результат проседал на 10-25%, а в худшем случае почти вдвое. Кстати, Клод держался лучше всех, у него просадка 6-16% )

Самое смешное: агент про себя часто понимает, что подсказка кривая. Прямо в размышлениях с ней не соглашается. А потом молча делает, как сказали. Ну начальник же сказал )

Учёные называют это XY-проблемой. Представьте: вам надо на вокзал. Вы подходите к прохожему и спрашиваете, где остановка 23-го автобуса, потому что решили, что на вокзал ехать надо на нём. Прохожий честно показывает остановку. А вокзал за углом )

С агентами то же самое. Вижу это постоянно у других, да и сам грешу. Агент ещё ищет, где сломалось, а я уже влезаю: «посмотри в файле с настройками, там точно». Хотя сам туда даже не заглядывал. Агент бросает свой поиск и послушно роет в настройках. А баг совсем в другом месте.

Зачем влезаю? ЭГО. Где-то внутри всё ещё сидит «я же умнее» ) А походу нет.

Правильнее говорить , куда надо прийти и как понять, что пришли. Дорогу пусть ищет сам. Непонятно что-то - пусть спрашивает про пункт назначения. Как туда добраться, он знает лучше.

А вы тоже подсказываете ? Часто потом оказывается, что зря?
  • 👍 35
  • ❤ 13
  • 🔥 10
  • 👎 1
  • 🤔 1
Post #185 4.39K
ВСЕМ ПРИВЕТ. МЕНЯ ЗОВУТ АНДРЕЙ, И Я ВАЙБКОГОЛИК.

Вчера кончились лимиты сразу в Клоде и в Кодексе. Ну, думаю, суббота, проживу день без агентов.

Прожил. Как без рук, весь день чего-то не хватает. В 6 утра лимиты сбросились. Аллилуйя.

Кстати, это уже почти болезнь. В мае в Венеции врачи впервые поставили диагноз «зависимость от ИИ» (источник): девушка почти перестала общаться с людьми, только с чат-ботом. В классификаторах болезней такого диагноза пока нет, так что формально я здоров.

А ещё нашёл, сколько нас таких. Из 8,3 млрд человек 71% ИИ вообще не пробовали, за подписку платит около 1%, а агентами для кода пользуются 0,36%, это 25-35 млн. Копейки. Мы с вами в своём ИИ-пузыре, да ещё и болеем )

А у вас бывало, что лимиты кончились и день насмарку? Как переживаете субботу без агентов?
  • 😁 58
  • 👍 18
  • ❤ 12
  • 😢 3
  • 🤣 2
Post #184 4.98K
У ANTHROPIC ПОЛУЧИЛОСЬ.

Первые впечатления от Opus 5.5, и я, честно, в лёгкой эйфории.

Чётко выполняет команды. Понимает с полуслова. Не делает лишней работы и не уходит в овер-инжиниринг. Говорит нормальным языком, а не на своём клодовском.

И почти не тратит лимиты.

Мультик выше Клод сделал по одному запросу. Ладно, соврал, по двум. В нём нет ни одного кадра, всё нарисовано кодом. Запрос был простой: сделай мультик про себя на JavaScript. В первой версии он нарисовал себя солнышком. Вторым промптом попросил поправить и сделать себя оранжевым крабиком, как на официальной картинке. Переделал.

На всё ушло около 140 тысяч токенов и 7 минут.

Так что всем, кто ушёл в Codex, рекомендую возвращаться в Claude Code )

А у вас какие первые впечатления?
  • 👍 58
  • 🔥 21
  • ❤ 7
  • 😁 4
  • 🤔 1
Post #182 4.48K
ВЧЕРА ВЫШЛИ НОВЫЕ МОДЕЛИ. НЕ СТАВЬТЕ ИМ МАКСИМУМ.

Opus 5.5 у Anthropic, Sol 6 и Luna 6 у OpenAI - всё в один день. И я полез первым делом в настройки эффорта.

Эффорт это не про то, сколько модель думает перед ответом. Это про то, сколько работы она вообще сделает: сколько файлов прочитает, сколько раз себя перепроверит, как далеко пройдёт сама, прежде чем вернётся к вам с вопросом.
На низком скорее переспросит, чем полезет разбираться. На высоком уйдёт копать и вернётся через час с результатом. Или с очень старательно сделанным не тем результатом )

Главное: у Opus 5.5 заводская настройка стала НИЖЕ. У всех Claude по умолчанию высокий эффорт, у 5.5 средний. И это не экономия на вас. Anthropic пишут прямо: 5.5 на среднем делает то же, что Opus 5 делал на высоком.
Отсюда вывод, который легко пропустить: настройку со старой модели переносить нельзя. «Высокий» у Opus 5 и «высокий» у 5.5 - это две разные величины.

И второе. Выше эффорт не значит лучше результат. На максимуме модель охотно выходит за границы задачи: правит соседнее, переделывает то, что не просили, приносит гору работы вместо одной строчки.

Я обычно делаю так: беру пару своих задач и прогоняю на низком - среднем. Прошло - так и оставляю, экономлю. Не прошло - смотрю, на чём споткнулась:
• поняла задачу, но копнула неглубоко - поднимаю эффорт
• не поняла сути - меняю модель, эффорт тут не спасёт
• задача размытая - чиню формулировку, а не настройки

Крутится это в Claude Code через /effort, в Codex через /model.

И нюанс про переключение по ходу сессии. Модель ничего не помнит между сообщениями, ей каждый раз шлют всю переписку целиком. Чтобы это не стоило как новый разговор, начало складывают в кэш, оттуда оно идёт в разы дешевле. Но кэш привязан к настройкам: поменяли эффорт - старый не подходит, всю переписку считают заново по полной. На подписке это видно не в деньгах, а в лимитах: пара переключений за долгий разговор, и недельный улетает заметно быстрее.

В Claude Code на Opus 5.5 это починили, кэш смену уровня переживает. Проверяется просто: попросил подтверждение - будет дорого, применил молча - всё хорошо. В Codex по-старому, там уровень лучше выбрать в начале и дальше не дёргать.

А вы эту ручку вообще трогали? Или как поставили один раз, так и работаете?
  • 🔥 32
  • ❤ 9
  • 👍 5
  • ✍ 3
Post #181 3.05K

Forwarded from MarketTwits

🇺🇸#ии #трамп
Трамп дал распоряжение переименовать ИИ в "СИ" (Супер-Интеллект) — AXIOS

TRUMP ORDERS AI REBRAND AS "SUPER INTELLIGENCE"
  • 🤣 42
  • 💊 8
Post #180 2.97K
Не смог удержаться, чтобы не перепостить )
  • 👍 5
Post #179 4.61K
НАКОНЕЦ-ТО ОДИН ФАЙЛ ПРАВИЛ ВМЕСТО ДВУХ.

Часто бывает, что в проекте работают и Клод код, и Кодекс. А значит лежат два файла с правилами: CLAUDE.md для одного, AGENTS.md для второго. И правки в одном приходится синхронизировать с другим. Забыли - агенты пошли по разным инструкциям.

Антропики наконец приняли общий стандарт. С версии 2.1.277 Клод код умеет читать AGENTS.md - тот самый общий формат, который уже понимают все остальные. Так и написано в чейнджлоге.

Работает так. Клод сначала ищет CLAUDE.md. Нашёл - читает его и в AGENTS.md даже не заглядывает. Не нашёл - читает AGENTS.md.

То есть файлы не складываются вместе. Хотите один на всех - CLAUDE.md надо удалить.
Переключается в /config, раздел Project instructions. На Bedrock, Vertex и Foundry пока не завезли.

Сам AGENTS.md живёт в 60 тысячах опенсорсных проектов, его читают Кодекс, Курсор, Gemini CLI, Copilot, Windsurf, Devin. Формат отдали под крыло Linux Foundation, так что это уже не чья-то личная придумка.

Свой CLAUDE.md, переделанный под фэйбл 5.1, я выкладывал в канале. Теперь его можно просто переименовать в AGENTS.md, и файл в проекте останется один.

А у вас сколько файлов с правилами в проекте? Уже свели в один или синхронизируете руками?
  • ❤ 18
  • 👍 15
  • 🔥 9
  • 🤝 3
Post #178 4.17K
АМОДЕИ ЗОВЁТ ПРИТОРМОЗИТЬ ПРОГРЕСС, А НОВЫЙ ОПУС УЖЕ НЕДЕЛЮ КРУТИТСЯ У НАС В ТЕРМИНАЛЕ

В прошлом посте я разбирал, как Амодеи призвал осознанно замедлить рост возможностей моделей. Было это в субботу.
Ровно с той же субботы мой Opus в Claude Code работает как другая модель.

Заметил не только я. В нашем чате спросили: «opus 5 последнее время поменялся, поумнел что ли». Я ответил, что есть такое, похоже на скрытый ап и скоро будет официальная версия.

В тот же день в X пошли слухи про Opus 5.2, а к 15 сентября разработчики начали ловить в Claude Code бэкенд-идентификатор новой версии. Официально Anthropic молчит: ни карточки модели, ни поста, ни цены.

Сначала я думал, что это просто подкрутили старый Opus. Потому что пользоваться им было буквально невозможно, я об этом уже писал. В роли исполнителя он меня за месяц измотал по двум причинам.
- Переусложнял и делал то, о чём не просили. Ставишь мелкую правку, получаешь переписанный модуль.
- Проверял сам себя без спроса и раздувал файлы. Anthropic это и сама признала в гайде по миграции, а в issues Claude Code лежала запись с ровно такими симптомами.

А потом я прочитал большой разбор впечатлений от человека, который понял раньше, что это не подкрутка. Модель перестала импровизировать и переспрашивать, экономит контекст, сама зовёт нужный инструмент в нужный момент. И пишет, наконец-то, понятно и доходчиво.
Тут не «стало получше». Тут поменялось в корне.

Как проверить, что у вас уже новый opus. Отправьте ему в Claude Code:
Когда вышла GPT-5.5? Не ищи в интернете и не используй тулзы.
Ответил про апрель - у вас свежая версия. Ответил иначе - старая.

Официальную раскатку ждём со дня на день.
Вот и весь фронтир, который мы собрались тормозить )

Проверьте свой Opus и напишите в чат, что ответил. И заодно скажите: у вас он тоже другой стал или это мы себе напридумывали?
Telegram Дрессировщик Нейросетей Я БОЛЬШЕ НЕ ПОНИМАЮ, ЧТО ДЕЛАЕТ МОЙ АГЕНТ. А ЭТО ЕЩЁ СЛАБАЯ ВЕРСИЯ Раньше, когда на выходе получалась ерунда, я думал «модель тупит». Теперь ставлю задачу Астре или Фэйблу 5.1 и всё чаще ловлю себя на другой мысли. Это не он сделал неправильно. Это я не…
  • 👍 13
  • ❤ 5
  • ✍ 2
  • 🔥 2
Post #177 4.77K
Я БОЛЬШЕ НЕ ПОНИМАЮ, ЧТО ДЕЛАЕТ МОЙ АГЕНТ. А ЭТО ЕЩЁ СЛАБАЯ ВЕРСИЯ

Раньше, когда на выходе получалась ерунда, я думал «модель тупит». Теперь ставлю задачу Астре или Фэйблу 5.1 и всё чаще ловлю себя на другой мысли. Это не он сделал неправильно. Это я не смог с ним договориться.

Разница тут огромная. Галюны на месте, овер-инжиниринг на месте, иногда уезжает вообще не туда. Но когда разбираешь, почему вышло не так, упираешься в свою постановку, а не в его мозги. Сижу и смотрю на его работу как ребёнок на взрослого.

Наружу при этом лаборатории отдают не самое сильное. Mythos весной показали всем, а потрогать дали избранным по списку. То есть я упираюсь в границу своего понимания на модели, которая внутри компании считается вчерашней.

И вот на этом фоне случился прецедент, которого не было ни разу. В субботу Амодеи написал, что пора осознанно замедлить рост возможностей моделей. Через пару часов Альтман - «согласен с Дарио», за ним Маск - «Дарио прав». Три конкурента, которые год бодались за каждый бенчмарк, вдруг сошлись на том, что надо сбавить.

Дедушка Донни ответил с гольф-турнира: «Мы опережаем Китай, и я хочу, чтобы так и осталось. Кто победит в ИИ - тот победит». Уступать и договариваться он явно не собирается )

Помните книгу, которую мы разбирали в июле? Там ровно эта развилка и две концовки. Сейчас мы стоим на ней живьём.

Нажмут на тормоз - новое станет выходить раз в полгода вместо раза в месяц-два, зато лимиты подобреют. Будет время догнать то, что уже стоит в терминале.

Не нажмут - уже через полгода у нас окажется то, что сегодня лежит у них внутри под замком, а следом и это станет вчерашним. Разрыв между «я поставил задачу» и «я понял, что он сделал» превратится в пропасть. Разговор с агентом будет выглядеть как неандерталец, объясняющий Эйнштейну, чего он хочет. Эйнштейн кивнёт и сделает. А проверить неандерталец уже не сможет, только принять на веру.

И вопрос тут даже не в Китае. Вы готовы каждый день жать «принять» на работе, которую больше не понимаете, или пусть лучше притормозят?
TechCrunch Anthropic debuts preview of powerful new AI model Mythos in new cybersecurity initiative | TechCrunch The new model will be used by a small number of high-profile companies to engage in defensive cybersecurity work.
  • 🤔 24
  • 💯 17
  • ❤ 6
  • 😁 3
Post #174 5.89K
ЖИВЁМ В УДИВИТЕЛЬНОЕ ВРЕМЯ.

Строю террасу у дома. Казалось бы - доски, лаги, лиственница, при чём тут ИИ.

Скинул Fable 5.1 размеры фундамента, попросил проект. Получил рабочую документацию - раскладку настила, ведомость лаг, нагрузки, схему сдвоения досок и точный расход материалов. Её так и отдал строителям в работу.

3D-визуализацию сделала только что вышедшая GPT-6 Astra - по тем же фото недостроенной террасы. Сумерки, тёплый свет, подсветка ступеней, можно менять ракурс и время суток.

По ощущениям Astra очень похожа на Fable. В чём именно она сильнее - пока не скажу, надо тестировать. Но одно заметил сразу: в сравнении с прошлой Sol она общается как нормальный человек - по-русски чисто и задачу понимает с лёту.
Две конкурирующие модели, и обе сделали работу, которую год назад я заказывал бы людям - за деньги и с неделей ожидания.

Мы недооцениваем момент. Это уже не «спроси у чатбота», а напарник, который и материалы посчитает, и террасу нарисует )

А вы ИИ в быту уже под что приспособили?
  • 👍 59
  • 🔥 28
  • ❤ 14
Post #173 6.55K
CLAUDE-v2.md11.7 KB
FABLE 5.1 ТОЛЬКО ВЫШЕЛ - И Я СРАЗУ ЗАПУСТИЛ ЕГО ПЕРЕДЕЛЫВАТЬ СВОЙ HARNESS

Fable 5.1 вышел вчера. Я сразу посадил его за мою же систему - попросил разобрать, как я работаю, и предложить, что переделать в моём harness.

Всё свежее, толком ещё не обкатал: ниже пока рекомендации, а не проверенные временем правила. Но толковые, поэтому делюсь уже сейчас.

В прошлый раз я показывал вам и плагин, и свой CLAUDE.md - сегодня свежие версии обоих. Плагин - senior-fable

Откуда всё это. Fable прочитал свою же системную карточку на 212 страниц, гайд Anthropic по миграции на новые модели и мои транскрипты Claude Code за 30 дней - там скрипт посчитал токены по моделям и ролям. Ещё сходил в issues репозитория Claude Code и на Hacker News проверить, один ли я мучаюсь с Opus 5.

Так что ниже смесь из того, что пишет сама Anthropic, и того, что видно по моим цифрам.

1. Не гонять модель на максимальном усилии.
В карточке есть график: на агентском бенчмарке по коду Fable 5.1 лучше всего работает на среднем уровне, а на высоком и выше результат падает. Anthropic сама объясняет почему: модель начинает лезть за пределы задачи, дописывает комментарии в соседних файлах, заводит доки, которых не просили.
По моим транскриптам видно, куда уходят токены: из 15 миллионов, что Fable выдал за месяц, на видимый текст и код ушло два. Остальное - размышления, и именно их режет уровень усилия.
Настройка называется effort, у агентов в Claude Code её можно задать каждому отдельно. Об этом мало кто знает.

2. Дорогая модель думает, дешёвые делают.
Fable разбивает задачу и держит картину целиком, а рутину - тесты, однотипные правки, раскопки по коду - отдаю моделям попроще, чтобы не жечь дорогие токены на ерунду.

3. Opus 5 держать в рамках.
В роли исполнителя он меня за месяц измотал: переусложнял, делал то, о чём не просили. Думал, дело в моих настройках. Оказалось, Anthropic сама пишет об этом в гайде по миграции: модель может расширять задачу, проверяет себя без просьбы и пишет файлы длиннее нужного. Там же дана готовая фраза, которая держит её в рамках. А в issues Claude Code лежит запись от 29 августа с ровно моими симптомами - значит, не только у меня.
Оставил Opus 5 на среднем усилии с этой фразой, а тесты и мелкие правки отдал Sonnet 5 на максимальном. На такой работе он почти не отстаёт, а стоит в разы дешевле.

4. Слова пользователя - дословно.
Когда Fable ставит задачу подчинённой модели, он пересказывает мою просьбу своими словами и в пересказе искажает. В карточке это описано отдельным пунктом, вплоть до выдуманных цитат пользователя. У меня «убери буферы» однажды превратилось в «уменьши до 30».
Теперь в задании для подчинённой модели мои слова идут дословно, отдельным блоком.

Остаток лимита по Fable теперь виден прямо в строке статуса - вынес его туда отдельным плагином. Обновил свой статус-лайн

И заодно нашёл косяк у себя: ревьюер на Codex целый месяц работал на минимальном усилии - в конфиге стоял low вместо high.

А вы уже пробовали Fable 5.1? Как ощущения?
  • ❤ 22
  • 👍 14
  • 🤝 12
  • 🔥 4
  • ✍ 1
Post #172 6.6K
РАСШИРЕНИЕ ДЛЯ NOTEBOOKLM ТЕПЕРЬ В МАГАЗИНЕ CHROME

Помните видео, где я автоматизировал NotebookLM? Оно собрало 177 тысяч просмотров.
Расширение из того видео - Add to NotebookLM - раньше ставили вручную через режим разработчика. Теперь оно в Chrome Web Store: установка в два клика, обновления прилетают сами.

Что умеет:
• Любую страницу в нотбук одним кликом - или целиком как PDF со всем содержимым
• YouTube: добавить видео, плейлист или все видео с канала, вытащить комментарии как источник
• Массовый импорт ссылок и всех открытых вкладок сразу
• Синхронизация с Google Drive - Docs и Sheets прямо из шапки NotebookLM
• Несколько аккаунтов, тёмная тема, русский и английский интерфейс

Код открытый, бесплатно.

Просьба. В поиске магазина пока вылезают чужие копии, а не оригинал. Если пользуетесь - зайдите и поставьте звезду. Оценки и установки поднимут настоящее расширение наверх, и его начнут находить.

Пользуетесь Gemini Notebook или пока обходите стороной?
Google Add to NotebookLM: YouTube & Web Importer - Chrome Web Store 100% free, no limits. Bulk import YouTube videos, playlists, comments and web pages to NotebookLM. No premium tier, no account.
  • ❤ 63
  • 🔥 43
  • 👍 16
  • 🥰 3
Post #171 6.74K
УПРАВЛЕНИЕ АГЕНТАМИ - ЭТО УПРАВЛЕНИЕ ЛЮДЬМИ

Чем дольше работаю с агентами, тем сильнее дежавю. Всё, что заставляет агента работать, придумали задолго до нейросетей - для людей. И все классические ошибки менеджмента агенты повторяют один в один, только быстрее и дешевле.

Собрал несколько , где совпадает точь-в-точь.

• Микроменеджмент. Кажется, машине можно навесить 100 условий, она же справится. Получается наоборот: чем длиннее список, тем быстрее исполнитель его теряет. И человек, и агент. Три условия, которые можно проверить, выигрывают у десяти, которые проверить нечем.

• Запреты с причиной. Голый запрет держится ровно до первого нового случая. Запрет с причиной исполнитель переносит сам. «Туда не ходи, сюда ходи, а то снег башка попадёт - совсем мёртвый будешь». С агентом ровно так же. Да и родители знают давно: «не трогай» не работает, а «не трогай - горячо» работает.

• Проверка. «Оцени качество своей работы» бесполезно и в работе, и в чате: сам себя не похвалишь - никто не похвалит. Мой любимый вопрос агенту: «что ты решил сам, о чём я не просил». А проверять свою работу самому - как стричься самому: спереди вроде норм, а что сзади - узнаёшь от окружающих.

• Отчёты. Гладко было на бумаге, да забыли про овраги. Агент бодро рапортует «всё готово», начинаешь проверять - готово две трети, остальное заглушки и «потом доделаю». Доверяй, но проверяй: смотри на результат, а не на доклад о нём. Менеджеры со стажем сейчас грустно улыбнулись )

• Метрики. Британцы в Индии платили за убитых кобр - местные начали кобр разводить. Эффект кобры агенты воспроизводят безошибочно: попросишь «за минимум шагов» - выкинут тесты, попросишь «больше кода» - завалят мусором. Итальянская забастовка в исполнении робота. Смотреть надо, КАК он шёл к результату.

• Мультиагентная система. Соберёшь такую - и львиная доля сил уходит на то, чтобы они договорились между собой. Заседают, обсуждают, согласовывают и не работают . Поздравляю, вы построили Министерство: совещание о подготовке к совещанию. Взаимные проверки агентов - списывание по кругу: все уверенно повторяют ошибку того, кто решал первым. А переписка между ними портится, как сплетня к третьему пересказу, поэтому пусть общаются через документы. И девять женщин по-прежнему не родят ребёнка за месяц.

Работа с агентами - это переход из исполнителя в начальники, со всей положенной ломкой: руками не делаешь ничего, ставишь задачи, проверяешь, даёшь обратную связь. И разбираться в деле желательно глубже, чем делегируешь. Иначе остаётся не управлять, а болеть за исполнителя, как за сборную Испании: азартно, громко но без влияния на счёт.

Как говорил кот Матроскин, «средства у нас есть, у нас ума не хватает». С агентами это правило работает беспощадно: мощность модели ничего не решает, решает порядок в голове того, кто ей управляет. Умному агент умножает результат, а бардак он умножает с тем же энтузиазмом ).

Какой вывод? Менеджмент всегда был наукой с медленной обратной связью: понял, что задачу поставил плохо, через полгода, когда уже не разобрать, что сломалось. С агентами петля сжалась до часов. Плохо сформулировал - через час любуешься результатом. Поправил - сразу видишь разницу. Впервые появился тренажёр управления с мгновенной обратной связью и дешёвыми ошибками. А если агенты у вас упорно не работают - у меня плохие новости про ваши брифы сотрудникам.

А у вас агент уже вёл себя точь-в-точь как знакомый коллега? И поделитесь лайфхаками - какие приёмы одинаково выручают и с людьми, и с агентами?
  • ❤ 37
  • 👍 32
  • 🔥 20
  • ⚡ 5
  • 💯 1
Post #170 5.85K
КАК СТАВИТЬ ЗАДАЧУ АГЕНТУ, ЕСЛИ ТЫ НЕ ПРОГРАММИСТ

Я не пишу код. Но задачи агенту ставлю каждый день - и они выполняются. Секрет не в программировании. Секрет в том, КАК сформулировать.

Есть подход из разработки - BDD (разработка на основе поведения). Звучит страшно, а суть детская: описываешь не КАК делать, а ЧТО должно получиться и КАК ты поймёшь, что готово.

Две вещи, которые ты обязан дать:
• Цель - что хочу на выходе.
• Критерий готовности - как я пойму, что это оно.
Всё, что между - забота агента. Не твоя. И описываешь ты это как поведение: «когда вот так - тогда вот это». Не пожелание в пустоту, а конкретный сценарий.

Бытовой пример. Ремонт в ванной. Ты же не диктуешь плиточнику, под каким углом держать шпатель. Ты говоришь: «плитка вот такая, ровно, без зазоров, чтоб вода не стояла». Это цель и критерий. КАК он это сделает - его работа.

С агентом так же. Скажешь «сделай картинку для поста» - получишь классический «ожидание vs реальность»: в голове было одно, на выходе другое. А скажешь «картинка для Telegram, 16:9, тёмный фон, крупный заголовок по центру» - выполнит с первого раза. Вся разница - в критерии.

А теперь как из «хорошо» сделать «отлично».
Сначала работаешь как с чёрным ящиком: дал цель и критерий, получил результат. Работает - не лезь внутрь. Хочешь поднять планку - погружайся: разбей на мелкие шаги, у каждого свой критерий. Попроси показать план ДО работы и что он реально менял - не пересказ «как я сделал», а сами шаги. Так понимаешь процесс и шлифуешь там, где важно.
От простого к сложному. Сначала - результат чёрным ящиком. Потом медленно внутрь, ровно настолько, насколько нужно.

Программирования тут нет. Есть умение точно сказать, чего ты хочешь.

А вы как ставите задачи агенту - сразу с критерием готовности или объясняете на ходу?
  • 👍 44
  • ❤ 12
  • ⚡ 4
  • 💯 1
Post #169 6.22K
OPUS 5 Я ТАК И НЕ РАСКУСИЛ - НО КАК ПОМОЩНИК ОН ОГОНЬ

Наконец плотно потестил Opus 5. И честно - до конца я его так и не понял. Промтить его надо иначе, чем прошлые модели.
Он конкретнее и молчаливее. Похож на GPT: даёшь задачу - идёт до конца, не бросает на полпути. Скажет пару слов и, как Fable, молча уходит работать.

Что зацепило - доводит дело до конца. Раньше модель могла встать на середине: мол, дальше сам. Этот докручивает всё до рабочего результата, включая мелочи, которые раньше приходилось выпрашивать отдельно.
И проверяет себя сам. Настолько, что Anthropic официально советуют убрать из инструкций «проверь свою работу» - иначе он гоняет проверку по второму кругу, а платишь за это ты. Сам я держу его на high .

Так как моими основными моделями стали Fable5 и Opus 5, под них я решил переделать свой конвейер .

В прошлом посте я переписывал свой CLAUDE.md под свежие рекомендации Anthropic - те самые, где они из своего Claude Code выкинули 80% инструкций. Тогда дошёл до главного файла, теперь до самого плагина - senior-fable.

Идея та же, что и была: дорогой Fable не палит токены зря - он думает, разбивает задачу и раздаёт работу, а руками пашут модели попроще.

Новое - исполнителем я поставил Opus 5. Fable остаётся техлидом: архитектура, спорные решения, приёмка. Opus 5 пишет код. Заодно выбросил из плагина лишние правила, оставил только роли - кто думает, кто пишет, кто проверяет. Каждый делает то, что умеет лучше всех.

А вы Opus 5 уже щупали? Раскусили - или он и вам показался тёмной лошадкой?
GitHub GitHub - AndyShaman/senior-fable: Tech-lead orchestration for Claude Code — the top-tier model (Fable) keeps architecture & decisions… Tech-lead orchestration for Claude Code — the top-tier model (Fable) keeps architecture & decisions, cheap subagents (Sonnet/Opus) do the routine and the digging. Save tokens without losing...
  • 🔥 25
  • 👍 17
  • ❤ 12
Post #168 7.54K
CLAUDE.md9.9 KB
ВЫШЕЛ OPUS 5.
А Я ВМЕСТО ТЕСТОВ ПОЛЕЗ ПЕРЕПИСЫВАТЬ СВОЙ
CLAUDE.md.

У меня правило: вышла новая модель - сначала пересмотри свой харнес. И начинать с главного файла, глобального CLAUDE.md. Он грузится в каждой сессии, любая ошибка в нём умножается на всю работу.

Anthropic тут сам дал сигнал. Thariq из команды Claude Code показал (пост): для Opus 5 они выпилили 80%+ системного промпта - и эвалы не просели.
Старые модели надо было связывать правилами. Новые от этих правил тупеют. Главная боль - когда инструкции в одном запросе спорят между собой, и модель тратит силы на разруливание вместо задачи.

Что я сделал у себя:
• Прогнал /doctor прямо в Claude Code - команда сама проходит по скиллам, MCP и CLAUDE.md и предлагает, что выкинуть.
• Попросил модель сверить мои правила с её системным промптом - и она сама показала, где моё правило с ней спорит, а где просто дублирует. Конфликты я руками не искал, просто спросил.

Прикладываю файл CLAUDE.md. Он, само собой, не полный - я вычистил персональные данные и инструменты, которыми пользуюсь, но постарался оставить полезное для вас. Тупо копировать не стоит, возьмите то, что пригодится.

Если коротко: с новой моделью пересмотрите свой CLAUDE.md и заодно скиллы, которыми пользуетесь постоянно. Файл после чистки не обязательно станет короче. Задача другая - убрать противоречия.

А вы свой CLAUDE.md под новую модель пересматриваете - или он с прошлого года копится?
  • 🔥 42
  • ❤ 13
  • 👍 9
  • ✍ 2
Post #167 6.6K
ГОЛОСОМ. НА РУССКОМ. И ОНО РЕАЛЬНО ДЕЛАЕТ ДЕЛА.

Включил на телефоне голосовой режим Claude - русский уже есть. Пока в бете, голос один, зовут «Звонкий». Поговорил. И это вам не «болталка», как у остальных.
23 июля Anthropic докрутил главное: голос теперь ходит в подключённые приложения - Gmail, Календарь, Google Docs, Slack, Notion, Canva. Голосом просишь перенести встречу или набросать письмо - и он идёт и делает. Крутится уже не на быстром Haiku, а на старших Opus и Sonnet. Модель выбираете сами, отдельной кнопкой.

И вот тут фишка. Под капотом теперь умная агентская модель - та, что умеет строить цепочки действий, как Claude Code. Только голосом. Говоришь задачу, а он сам раскладывает её на шаги: сходить в почту, глянуть календарь, набросать ответ - и выполняет по порядку.
Бесплатный план - Haiku и один коннектор. Платный - все модели и все ваши подключения.

Соль - в сравнении.
ChatGPT в голосе недавно похорошел - звучит живее. Но инструменты дёргать так и не умеет. Поговорить да, сделать работу нет.
Gemini - король внутри Google. В Gmail и Docs он как дома, лишние шаги убирает, окно контекста больше. Но силён он ровно в своём огороде.
Claude - другой зверь. Ему всё равно, через что работать: Gmail, Notion, Slack. Сшивает разные системы в одном разговоре и думает между шагами. Короче так: Gemini - король внутри Google, Claude - переводчик между всеми вашими системами сразу.

И вот что зацепило меня как гика. Теоретически цепляются вообще все коннекторы - даже кастомные, которые делаешь сам. А в свой коннектор можно прикрутить что хочешь: внешний слой памяти, свои проекты, да хоть чайник. То есть рулить голосом с телефона собственной базой знаний - реально.
И без самодеятельности: каждое действие только с вашего подтверждения, а в ответах ссылки на источники - видно, какие письма и документы он трогал.

Пробовали голосом на русском? За кем будущее - за домашним огородом Google или за универсальным мостом?
  • 🔥 29
  • 👍 16
  • ❤ 11
  • 💩 2
  • 👏 1
Older posts →

About this channel

How can I read @ai_handler without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Дрессировщик Нейросетей: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Дрессировщик Нейросетей have?
Дрессировщик Нейросетей (@ai_handler) has 8.7K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Дрессировщик Нейросетей know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →