TGViewer
Channel Public Channel
DS & ML | YeaHub

DS & ML | YeaHub

@yeahub_data_science

Теория, подготовка к интервью и курсы для Data Science специалистов

YeaHub — это платформа для IT-специалистов, объединяющая обучение, карьерный рост, развитие и сообщество единомышленников.

Платформа: https://yeahub.ru

Для связи: @ruslan_kuyanets
Subscribers
483
Photos
312
Videos
67
Links
543

Showing posts older than #121 · Back to latest

Older Posts 17 shown
Post #120 160
#видео
🤓 Если вы только начинаете заниматься ML/DL и переживаете, что придётся потратить недели на подтягивание математики, поверьте — этого видео вам достаточно.

Это видео длится 5 часов, и этого вполне достаточно, чтобы начать.
📱 Смотреть видео

👉Новости 👉База вопросов
Post #119 113
#полезное
👨‍💻 PyTorch выпустил mm: 3D визуализатор матричных умножений

Matrix Multiplication (matmul) — основа современных нейросетей. И теперь вы можете наглядно увидеть, как это работает.

Инструмент от PyTorch называется mm — это визуализатор, который показывает, как матрицы взаимодействуют во время перемножения. Отличный способ понять внутреннюю механику операций, лежащих в основе ИИ.

Особенности
🟠 Работает прямо в браузере
🟠 Показывает процесс перемножения пошагово
🟠 Подходит для обучения, презентаций и просто ради любопытства
Ссылка на проект

👉Новости 👉База вопросов
  • ❤ 1
Post #118 76
#Собес #TensorFlow
🤔 Что такое тензоры в TensorFlow и как они используются в моделях глубокого обучения?

Тензоры в TensorFlow - это многомерные массивы данных, которые используются для представления входных данных, выходных данных и промежуточных значений между слоями. Тензоры бывают разных размерностей (OD, 1D, 2D и т.д.) и позволяют эффективно выполнять вычисления и градиентные расчеты при обучении моделей.

👉Новости 👉База вопросов
Post #117 80
#полезное
👍 Google представил Agent2Agent (A2A)

Протокол для общения ИИ-агентов между собой, независимо от платформы или фреймворка. Использует технологии HTTP, SSE и JSON-RPC. Подробнее тут

Agent2Agent Protocol vs. Model Context Protocol, четкое объяснение (с визуализацией):

🟠 Протокол Agent2Agent позволяет AI-агентам подключаться к другим агентам.

🟠 Протокол Model Context позволяет AI-агентам подключаться к инструментам и API.

Оба протокола являются open-source и не конкурируют друг с другом

👉Новости 👉База вопросов
Post #116 79
#полезное
😊 Отличное приложение на основе ИИ начинается с выбора подходящего типа эмбеддингов

Вот 6 типов эмбеддингов и случаи, когда стоит их использовать:

🟠 Sparse embeddings: https://weaviate.io/developers/weaviate/search/bm25
🟠 Dense embeddings: https://weaviate.io/developers/weaviate/search/similarity
🟠 Quantized embeddings: https://weaviate.io/developers/weaviate/concepts/vector-quantization
🟠 Binary embeddings: https://weaviate.io/developers/weaviate/concepts/vector-quantization#binary-quantization
🟠 Variable dimensions: https://weaviate.io/blog/openais-matryoshka-embeddings-in-weaviate
🟠 Multi-vector embeddings: https://weaviate.io/developers/weaviate/tutorials/multi-vector-embeddings

👉Новости 👉База вопросов
Post #115 90
#видео
😎 Плейлист из 30 видео на YouTube для изучения основ машинного обучения с нуля

Если вы не знаете, с чего начать изучение машинного обучения, этот список под названием «Machine Learning: Teach by Doing» — отличный выбор, чтобы освоить как теорию, так и практическое программирование.

1. Введение в машинное обучение — Teach by Doing:
https://lnkd.in/gqN2PMX5

2. Что такое машинное обучение? История машинного обучения:
https://lnkd.in/gvpNSAKh

3. Типы моделей машинного обучения:
https://lnkd.in/gSy2mChM

4. 6 этапов любого ML-проекта:
https://lnkd.in/ggCGchPQ

5. Установка Python и VSCode, запуск первого кода:
https://lnkd.in/gyic7J7b

6. Линейные классификаторы. Часть 1:
https://lnkd.in/gYdfD97D

7. Линейные классификаторы. Часть 2:
https://lnkd.in/gac_z-G8

8. Jupyter Notebook, Numpy и Scikit-Learn:
https://lnkd.in/gWRaC_tB

9. Запуск алгоритма случайного линейного классификатора на Python:
https://lnkd.in/g5HacbFC

10. Самая первая ML-модель — перцептрон:
https://lnkd.in/gpce6uFt

11. Реализация перцептрона на Python:
https://lnkd.in/gmz-XjNK

12. Теорема сходимости перцептрона:
https://lnkd.in/gmz-XjNK

13. Магия признаков в машинном обучении:
https://lnkd.in/gCeDRb3g

14. One-hot encoding (одноразрядное кодирование):
https://lnkd.in/g3WfRQGQ

15. Логистическая регрессия. Часть 1:
https://lnkd.in/gTgZAAZn

16. Функция потерь — кросс-энтропия:
https://lnkd.in/g3Ywg_2p

17. Как работает градиентный спуск:
https://lnkd.in/gKBAsazF

18. Логистическая регрессия с нуля на Python:
https://lnkd.in/g8iZh27P

19. Введение в регуляризацию:
https://lnkd.in/gjM9pVw2

20. Реализация регуляризации на Python:
https://lnkd.in/gRnSK4v4

21. Введение в линейную регрессию:
https://lnkd.in/gPYtSPJ9

22. Пошаговая реализация метода наименьших квадратов (OLS):
https://lnkd.in/gnWQdgNy

23. Основы и интуиция гребневой регрессии (Ridge Regression):
https://lnkd.in/gE5M-CSM

24. Резюме по регрессии для собеседований:
https://lnkd.in/gNBWzzWv

25. Архитектура нейронной сети за 30 минут:
https://lnkd.in/g7qSrkxG

26. Интуиция обратного распространения ошибки (Backpropagation):
https://lnkd.in/gAmBARHm

27. Функции активации в нейронных сетях:
https://lnkd.in/gqrC3zDP

28. Моментум в градиентном спуске:
https://lnkd.in/g3M4qhbP

29. Практическое обучение нейросети на Python:
https://lnkd.in/gz-fTBxs

30. Введение в сверточные нейронные сети (CNN):
https://lnkd.in/gpmuBm3j


👉Новости 👉База вопросов
Post #114 72
#Собес #TensorFlow
🤔 Что такое сериализация данных и как TensorFlow обрабатывает это с помощью TFRecords?

Сериализация данных - это процесс преобразования структуры данных в формат, удобный для хранения и передачи. TensorFlow использует формат TFRecord, который позволяет эффективно хранить и читать данные, разбивая их на бинарные строки и поддерживая различные типы данных.

👉Новости 👉База вопросов
Post #111 70
#полезное
🤓 Docling

Это мощный инструмент для обработки документов, который позволяет легко экспортировать их в форматы, такие как HTML, Markdown и JSON, поддерживая при этом множество популярных файловых форматов на вход (например, PDF, DOCX, PPTX).

Он предлагает глубокое понимание структуры PDF-документов и обеспечивает единый подход к представлению информации.

Инструмент интегрируется с LlamaIndex и LangChain, поддерживает OCR для сканированных документов, а также предоставляет простой интерфейс командной строки.
Гитхаб

👉Новости 👉База вопросов
Post #109 87
#Собес #TensorFlow
🤔 Как TensorFlow Lite позволяет выполнять машинное обучение на мобильных устройствах?

TensorFlow Lite оптимизирует обученные модели для использования на мобильных устройствах, снижая размер модели и увеличивая скорость выполнения. Он использует конвертер для преобразования моделей и поддерживает аппаратное ускорение, чтобы обеспечить низкую задержку и эффективное использование ресурсов.

👉Новости 👉База вопросов
Post #108 77
#видео
😬 Известный когнитивист и Computer Scientist Йоша Бах рассуждает, сознательны ли LLM, и говорит, что мозг как таковой тоже не обладает сознанием

Сознанием обладает человек, а мозг просто имитирует поведение наблюдателя, подавая сигналы, как если бы это он наблюдал окружающий мир.

С нейросетями ситуация аналогичная: они имитируют наблюдение мира, создавая в нем свою проекцию. Вопрос лишь в том, насколько такая симуляция далека от нашей.
📱 Смотреть в источнике

👉Новости 👉База вопросов
Post #107 73
#полезное
🥺 ИИ не отнимает работу у инженеров — он трансформирует её

По свежему отчёту WEF, к 2030 году произойдёт глобальная перекройка рынка труда:
✅ 22% текущих профессий изменятся
✅ +170 млн новых рабочих мест
✅ -92 млн уйдут в прошлое

И ключевой драйвер этих изменений — ИИ и автоматизация.

Что это значит для DS-инженеров?

Вместо стандартного «data scientist»/«ML engineer» сейчас появляются:
🟠 AI/ML продуктовые инженеры
🟠 Специалисты по data pipelines для LLM и мультимодальных моделей
🟠 Инженеры по интерпретируемости моделей (XAI)
🟠 Мастера feature engineering под foundation models
🟠 MLOps с уклоном в этику, безопасность и оценку рисков
🟠 Prompt/agent engineers (внезапно, уже инженерная роль)

Интересно, что многие из этих ролей не существовали 3-5 лет назад. И это не предел: растёт спрос на специалистов, которые могут работать на стыке ИИ и бизнеса, ИИ и UX, ИИ и governance.

Поэтому ключевая компетенция 2025+ — уметь мыслить с ИИ: не просто строить пайплайн, а понимать, как ИИ влияет на продукт, решение, пользователя.

👉Новости 👉База вопросов
Post #104 69
#полезное
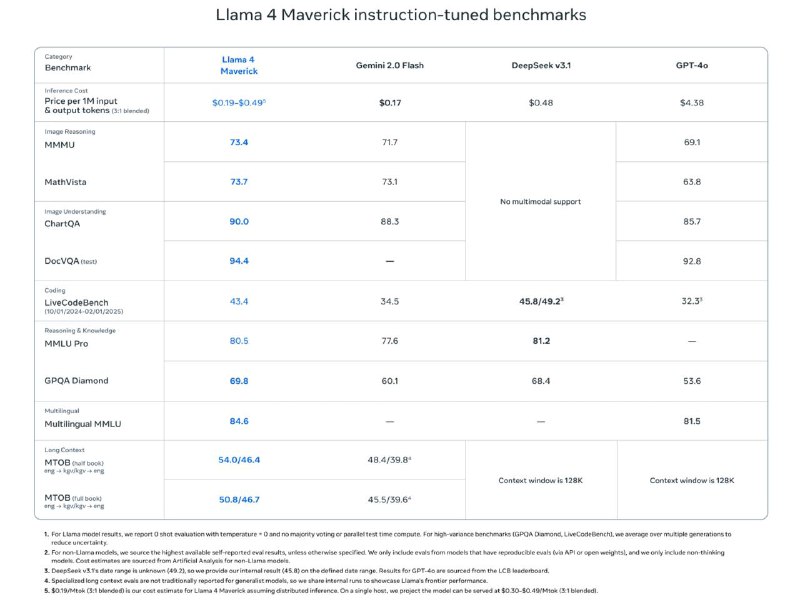
🥺 Вышла Llama-4 с огромным контекстом

Релизнули в трех весах: Llama 4 Scout на 109B, Llama 4 Maverick на 400B и Llama 4 Behemoth на 2T (да-да, в триллионах).

– Llama 4 Scout. Контекст 10M токенов (вау!), MoE на 16 экспертов, 17B активных параметров. Запускается на одной GPU. Уровень Gemini 2.0 Flash Lite.

– Llama 4 Maverick. Контекст поменьше, 1M. 128 экспертов по 17B активных параметров. Примерно на уровне GPT-4o. На арене модель сейчас на 2 месте с рейтингом 1417.

Обе модели выше мультимодальные (на вход принимают до 5 изображений) и поддерживают много языков. Знания – по август 2024. Веса

– Llama 4 Behemoth. Модель невероятных размеров, которая использовалась в качестве учителя для Scout и Maverick. 16 экспертов по 288B активных параметров. Уровень GPT-4.5 и Claude Sonnet 3.7. Весов пока нет, модель в превью и все еще обучается.

👉Новости 👉База вопросов
Post #103 70
#Собес #TensorFlow
🤔 Что такое TensorFlow Estimator и какие его преимущества по сравнению с API tf.Session()?

TensorFlow Estimator - это высокоуровневый АРІ, который упрощает создание и обучение моделей в TensorFlow. Он автоматизирует такие задачи, как управление сессиями, сохранение контрольных точек и обработку ошибок. Преимущества по сравнению с tf.Session() включают меньшее количество кода для создания сложных моделей, поддержку распределенных вычислений, автоматическое сохранение контрольных точек и возможность упрощенной обработки данных.

👉Новости 👉База вопросов
Post #102 63
#полезное
🤓 Фишка инструмента: SHAP — интерпретируемость ML-моделей

SHAP (SHapley Additive exPlanations) — это мощный инструмент для объяснения предсказаний моделей машинного обучения. Он основан на значениях Шепли из теории игр и позволяет разобрать вклад каждого признака в итоговый результат модели.

Что делает SHAP:
➖ Объясняет любой ML-модели, от XGBoost и LightGBM до нейросетей и трансформеров
➖ Выявляет ключевые признаки, влияющие на предсказания
➖ Создаёт наглядные визуализации, такие как водопадные графики, force plots, scatter plots и beeswarm-графики
➖ Работает с деревьями решений, нейросетями и линейными моделями

Ключевые приёмы
➖ Waterfall plot — детальный разбор влияния признаков
➖ Beeswarm plot — топ-важных признаков по всей выборке
➖ Dependence plot — анализ взаимодействий признаков

Пример использования

1⃣ Установка:
pip install shap


2⃣ Простая демонстрация для XGBoost:
import xgboost
import shap

# Обучаем модель
X, y = shap.datasets.california()
model = xgboost.XGBRegressor().fit(X, y)

# Создаём объяснитель SHAP
explainer = shap.Explainer(model)
shap_values = explainer(X)

# Визуализируем вклад признаков в предсказание
shap.plots.waterfall(shap_values[0])
shap.plots.beeswarm(shap_values)


Подробнее в репозитории: SHAP на GitHub

👉Новости 👉База вопросов
Post #101 49
#полезное
😐 How to: как «на самом деле» работает Dropout

Если вы думаете, что Dropout просто обнуляет часть нейронов, это лишь половина правды. Есть ещё один важный шаг, который делает обучение стабильным.

🟠 Разберёмся на примере:
— Представьте, что у нас есть 100 нейронов в предыдущем слое, все с активацией 1.
— Все веса соединений с нейроном A в следующем слое равны 1.
— Dropout = 50% — половина нейронов отключается во время обучения.

🟠 Что происходит:
— Во время обучения: половина нейронов выключена, так что вход нейрона A ≈ 50.
— Во время inference: Dropout не применяется, вход A = 100.

🟠 Проблема:
Во время обучения нейрон получает меньший вход, чем во время inference. Это создаёт дисбаланс и может ухудшить обобщающую способность сети.

🟠 Секретный шаг Dropout:
Чтобы это исправить, Dropout масштабирует оставшиеся активации во время обучения на коэффициент 1/(1-p), где p — доля отключённых нейронов.

— Dropout = 50% (p = 0.5).
— Вход 50 масштабируется: 50 / (1 - 0.5) = 100.

Теперь во время обучения вход нейрона A примерно соответствует тому, что он получит при inference. Это делает поведение сети стабильным.

🟠 Проверим на практике:
import torch
import torch.nn as nn

dropout = nn.Dropout(p=0.5)
tensor = torch.ones(100)

# Обучение (train mode)
print(dropout(tensor).sum()) # ~100 (масштабировано)

# Вывод (eval mode)
dropout.eval()
print(dropout(tensor).sum()) # 100 (без Dropout)


В режиме обучения оставшиеся значения увеличиваются, в режиме inference — нет.

🟠 Вывод:
Dropout не просто отключает нейроны — он ещё масштабирует оставшиеся активации, чтобы модель обучалась корректно.

👉Новости 👉База вопросов
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →