TGViewer
Channel Public Channel
DS & ML | YeaHub

DS & ML | YeaHub

@yeahub_data_science

Теория, подготовка к интервью и курсы для Data Science специалистов

YeaHub — это платформа для IT-специалистов, объединяющая обучение, карьерный рост, развитие и сообщество единомышленников.

Платформа: https://yeahub.ru

Для связи: @ruslan_kuyanets
Subscribers
483
Photos
312
Videos
67
Links
543

Showing posts older than #101 · Back to latest

Older Posts 20 shown
Post #100 51
#полезное
😊 Шпаргалки по Transformers и LLMs для курса Stanford CME-295

Охватывают токенизацию, механизм самовнимания, prompting, дообучение, LLM-as-a-judge, RAG, AI-агентов и модели рассуждений.

Полностью бесплатные и с открытым исходным кодом. Забираем здесь

👉Новости 👉База вопросов
  • 👍 1
Post #99 49
#полезное
😇 Как снижение размерности влияет на One-vs-Rest и One-vs-One

🟠One-vs-Rest (OVR):
— Чувствителен к выбору признаков, так как каждый классификатор выделяет один класс против всех остальных.
— Если убрать важные признаки, отличающие класс, модель может ухудшить предсказания.
— Глобальное снижение размерности (например, PCA) может потерять информацию, важную для отдельных классов.

🟠 One-vs-One (OVO):
— Каждый классификатор фокусируется только на двух классах, поэтому локальный отбор признаков может дать лучшее разделение.
— Разные классификаторы могут использовать разные наборы признаков, что требует сложного управления.
— При большом числе классов возможно переобучение из-за небольших выборок для каждой пары.

Итог:
При OVR полезно использовать глобальное снижение размерности, но с осторожностью. При OVO можно применять локальный отбор признаков, но важно избегать переобучения.

👉Новости 👉База вопросов
  • ❤ 1
  • 👍 1
  • 🔥 1
Post #98 56
#полезное
🤯 Визуальные вычисления в Power BI: прокачиваем условное форматирование

Теперь настраивать условное форматирование в Power BI можно без сложных DAX-формул!

Разбираем, как новые визуальные вычисления помогают создавать динамичные, адаптивные и стильные отчеты, которые мгновенно реагируют на изменения данных.
Ссылка на статью

👉Новости 👉База вопросов
  • ❤ 1
  • 👍 1
Post #97 66
#Собес #TensorFlow
🤔 Чем PyTorch отличается от других фреймворков глубокого обучения, таких как TensorFlow?

PyTorch и TensorFlow отличаются архитектурой вычислений: PyTorch использует динамическую вычислительную графику, что позволяет изменять граф во время выполнения, в то время как TensorFlow использует статичный граф, который требует предварительного определения. Это делает PyTorch более интуитивным и удобным для отладки, но TensorFlow может обеспечивать лучшую производительность благодаря оптимизации вычислений. Также PyTorch более дружелюбен к Python-разработчикам, поскольку поддерживает структуру управления Python, в то время как TensorFlow абстрагирует многие детали.

👉Новости 👉База вопросов
  • 👍 2
Post #96 73
#полезное
😇 Чем ближе к вокзалу, тем хуже кебаб — научный прорыв века

На французском Reddit появилась гипотеза: чем ближе к вокзалу, тем хуже кебаб. Это утверждение потребовало проверки, и один энтузиаст решил разобраться, вооружившись свободным временем и шутливым настроением. Нобелевка и job-офферы, конечно, уже на горизонте!

Методология
Для анализа выбрали Париж: гипотеза родом оттуда, вокзалов и кебабных там полно, а пешеходные маршруты идеально подходят для «научных» прогулок.
Подробности исследования

👉Новости 👉База вопросов
  • ❤ 2
Post #95 83
#Собес
🤔 Как Scikit-Learn обрабатывает сохранение моделей и их сериализацию?

Scikit-Learn использует встроенную в Python модель сериализации рісе для сохранения и загрузки моделей машинного обучения. Однако, из-за проблем с
безопасностью и совместимостью версий Python, рекомендуется использовать joblib, который более эффективен для работы с большими данными, например, массивами numpy. Для сохранения модели используется функция joblib.dump() , а для загрузки - joblib. load()

👉Новости 👉База вопросов
YeaHub YeaHub — тренажер собеседований по IT 5000+ вопросов для подготовки к интервью. Фильтры, квизы, статистика!
Post #94 65
#полезное
🛞 Это увлекательный интерактивный гайд, объясняющий интуицию, лежащую в основе гауссовых процессов.

Гауссовские процессы позволяют построить распределение функций с непрерывной областью определения.
Гайд

👉Новости 👉База вопросов
Post #93 57
#полезное
😊 Шпаргалка: как генерировать текст с LLM

Генерация текста — это не просто предсказание следующего токена! LLM оценивает вероятность появления каждого слова, но как выбрать, какие слова вставлять в текст?

Давайте разберём основные методы:

🟠 Жадный поиск (Greedy Search) — выбираем слово с наивысшей вероятностью и продолжаем. Проблема: тексты становятся предсказуемыми и повторяются.

🟠 Случайный отбор (Sampling) — выбираем слова случайно с учётом вероятностей. Регулируется параметром temperature:
👍 Высокая температура → креативный, но хаотичный текст.
😱 Низкая температура → логичный, но скучный текст.

🟠 Лучевой поиск (Beam Search) — выбираем k лучших вариантов, продолжаем развивать их и выбираем последовательность с наибольшей вероятностью. Это баланс между качеством и скоростью.

🟠 Контрастный поиск (Contrastive Search) — улучшенный вариант, который оценивает гладкость и разнообразие текста. Слова с высокой вероятностью, но слишком похожие на предыдущие, могут быть наказаны и заменены более разнообразными.

Какой метод лучше?
✅ Если нужен фактологичный ответ — лучше beam search
✅Для творческих текстов — sampling
✅ Для баланса между качеством и разнообразием — contrastive search

👉Новости 👉База вопросов
Post #92 39
#полезное
😊 Как избежать чрезмерной оптимизации гиперпараметров (hyperparameter tuning)

Часто на этапе настройки гиперпараметров (например, с помощью Grid Search или Random Search) можно столкнуться с перенастройкой модели, что приведет к плохой её обобщающей способности на новых данных.

Как избежать переоптимизации гиперпараметров?
✅ Использовать кросс-валидацию для оценки производительности модели на разных поднаборах данных.

✅ Применять рандомизированный поиск вместо полного перебора всех вариантов гиперпараметров, чтобы ускорить процесс.

✅ Настроить ограничения на количество итераций или время оптимизации.

👉Новости 👉База вопросов
Post #91 38
#Собес
🤔 Как реализовать ансамблевый метод в Scikit- Learn и объяснить его преимущества?

Ансамблевые методы, такие как Random Forest, используют несколько моделей для улучшения точности предсказаний, уменьшая переобучение. Они работают путем агрегирования результатов нескольких моделей, что позволяет уменьшить вариативность и смещение.

👉Новости 👉База вопросов
YeaHub YeaHub — тренажер собеседований по IT 5000+ вопросов для подготовки к интервью. Фильтры, квизы, статистика!
Post #90 40
#полезное
🤓 Colab + GitHub: мгновенное открытие ноутбуков

Открывать Jupyter Notebook из GitHub в Colab без скачиваний, возни и лишних кликов? Лови лайфхак

Просто вставляешь "tocolab" в URL после "github" – и ноутбук сразу открывается в Colab

👉Новости 👉База вопросов
Post #89 38
#полезное
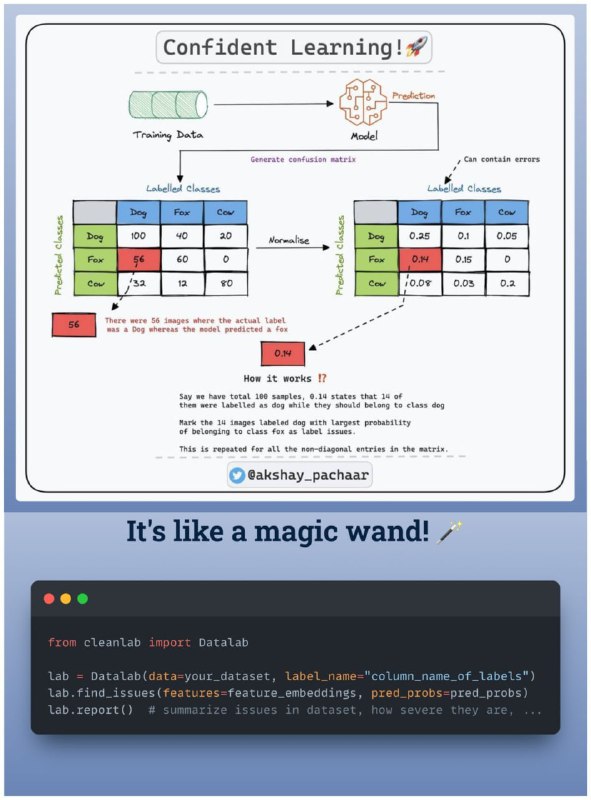
😐 Всего три строки кода — и эта библиотека Python очистит любой ML-дataset: выявит выбросы, найдет ошибки в метках, выполнит активное обучение и многое другое.
Гитхаб

👉Новости 👉База вопросов
Post #88 35
#статьи
😐 Как выбрать стратегию кэширования: разбор 7 популярных алгоритмов

Кешировать нужно с умом. И нет, LRU — не серебряная пуля.

В статье вас ждёт разбор алгоритмов: LRU, LFU, FIFO и другие
– Примеры, где каждый работает лучше
– Плюсы и минусы подходов
– Практические советы по выбору стратегии

Если проектируете систему с большими нагрузками или оптимизируете производительность — материал будет как раз.
Читать статью

👉Новости 👉База вопросов
Post #87 38
#Собес
🤔 Какую роль Scikit-Learn играет в инженерии признаков и предварительной обработке данных для машинного обучения?

Scikit-Learn играет ключевую роль в предварительной обработке данных, предоставляя инструменты для масштабирования признаков, кодирования категориальных переменных, обработки пропущенных значений и генерации полиномиальных признаков. Он также поддерживает методы для уменьшения
размерности, такие как РСА, и строит пайплайны для последовательного применения нескольких этапов обработки.

👉Новости 👉Платформа
Post #86 34
#полезное
🛞 STUMPY: умный анализ временных рядов

STUMPY — это мощная и масштабируемая библиотека Python для работы с временными рядами. Она эффективно вычисляет матричный профиль, который помогает находить ближайшие соседи для каждого подотрезка временного ряда.

С его помощью можно решать задачи:

✅ Поиск повторяющихся паттернов.
✅ Обнаружение аномалий.
✅ Выделение ключевых подотрезков (shapelets).
✅ Семантическая сегментация.
✅ Анализ потоковых данных.
✅ Быстрое приближённое вычисление матричных профилей.
✅ Построение временных цепочек.
✅ Краткое представление длинных временных рядов.
Подробнее — в документации.

👉Новости 👉База вопросов
Post #85 35
#полезное
😇 Иногда нужно быстро скормить LLM весь репозиторий

Просто меняешь одну букву в URL (github.com → uithub.com), и вуаля — получаешь весь репозиторий в виде чистого текста со структурой

Плюс есть фильтрация по расширениям, настройка максимального количества токенов и поддержка разных форматов вроде YAML

👉Новости 👉База вопросов
Post #84 34
#полезное
😊 Python-библиотека для тонкой настройки Gemma 3

Gemma — это минимальная библиотека для использования и тонкой настройки Gemma. Включает документацию по тонкой настройке, шардингу, LoRA, PEFT, мультимодальности и токенизации в больших языковых моделях (LLMs).

👉Новости 👉База вопросов
Post #83 34
#Собес
🤔 Можете ли вы описать сценарий, где вы бы использовали Random Forest вместо линейной регрессии и почему?

Random Forest стоит использовать вместо линейной регрессии, когда данные имеют сложные взаимосвязи и нелинейные зависимости, например, в задачах классификации заболеваний на основе множества параметров здоровья. Линейная регрессия предполагает линейную зависимость между признаками и результатом, что может не подходить для таких ситуаций. Random Forest может эффективно
работать с такими данными, создавая несколько деревьев решений и комбинируя их результаты.

👉Новости 👉Платформа
Post #82 36
#полезное
👍 NocoDB

Это база данных без кода (no-code database) с открытым исходным кодом, превращающая любую реляционную базу данных (MySQL, PostgreSQL, SQLite, MSSQL и др.) в гибкую таблицу, аналогичную Airtable!

🚩 Она позволяет пользователям управлять данными с помощью удобного веб-интерфейса, создавать REST API, настраивать представления (таблицы, календари, канбан-доски) и интегрироваться с внешними сервисами.
Гитхаб

👉Новости 👉База вопросов
Post #81 38
#полезное
😇 HF: Spark-TTS, модель преобразования текста в речь на базе LLM, которая выполняет клонирование голоса с нуля и создание голоса с высокой детализацией — все в одном потоке!

✔️ Сделана на Qwen2.5
✔️ Управляйте частотой тона, скоростью и стилем диктора непосредственно из текста.

Попробовать можно здесь: https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
Paper: https://arxiv.org/pdf/2503.01710
Code: https://github.com/SparkAudio/Spark-TTS
Demo: https://sparkaudio.github.io/spark-tts/

👉Новости 👉База вопросов
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →