TGViewer
Channel Public Channel
DS & ML | YeaHub

DS & ML | YeaHub

@yeahub_data_science

Теория, подготовка к интервью и курсы для Data Science специалистов

YeaHub — это платформа для IT-специалистов, объединяющая обучение, карьерный рост, развитие и сообщество единомышленников.

Платформа: https://yeahub.ru

Для связи: @ruslan_kuyanets
Subscribers
483
Photos
312
Videos
67
Links
543

Showing posts older than #81 · Back to latest

Older Posts 18 shown
Post #80 40
#полезное
😊 Coq-of-Rust — это инструмент для формальной верификации кода на Rust. Он преобразует подмножество Rust в спецификации на языке Coq, позволяя доказывать корректность программ математическими методами.

Проект разработан для повышения надежности критических систем (например, блокчейнов, embedded-решений), где ошибки недопустимы.

Основные функции
Трансляция Rust → Coq:
Конвертирует структуры, перечисления (enum), трейты (trait), методы и выражения в эквивалентный код на Coq.

Поддержка системы владения:
Учитывает правила заимствования и времени жизни (lifetimes), сохраняя семантику Rust на уровне спецификаций.

Генерация теорем:
Автоматически создает условия для доказательства свойств (например, отсутствие паник, корректность алгоритмов).

Coq-of-Rust — это шаг к математически верифицируемому Rust. Если вы разрабатываете системы, где цена ошибки высока, этот инструмент поможет превратить код в набор теорем, которые можно строго доказать.

Совет: Начните с примеров из репозитория, чтобы понять, как транслируются типичные Rust-конструкции.
Гитхаб

👉Новости 👉База вопросов
Post #79 28
#Собес
🤔 Как реализовать анализ главных компонент (РСА) с использованием Scikit-Learn?

Для реализации РСА с использованием Scikit-Learn нужно сначала нормализовать данные, а затем применить класс РСА из модуля sklearn.decomposition . Указывая количество компонент, которые нужно оставить, можно уменьшить размерность данных, сохраняя как можно больше информации. Результатом является набор данных с меньшим числом признаков.

👉Новости 👉Платформа
Post #78 27
#полезное
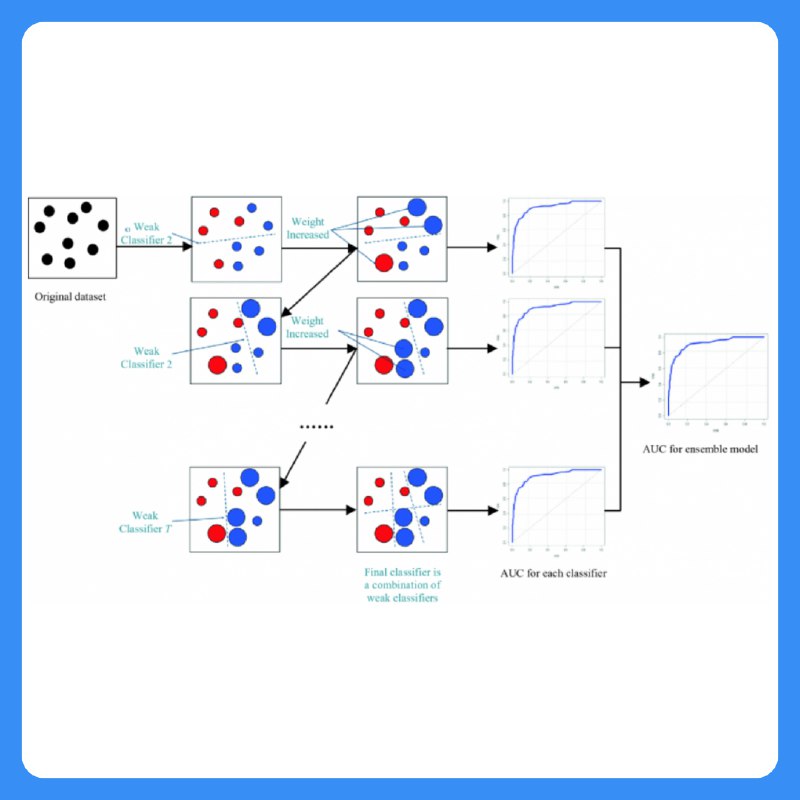
🥺 Градиентный бустинг: почему слишком много деревьев ухудшает модель

🟠 Переобучение (overfitting) — каждое новое дерево минимизирует ошибку, но если деревьев слишком много, модель начинает подстраиваться под шум данных, теряя обобщающую способность.

🟠 Снижение прироста качества — на первых итерациях каждое дерево значительно улучшает предсказания. Однако после определенного количества итераций добавление новых деревьев практически не влияет на качество.

🟠 Рост вычислительной сложности — больше деревьев → выше время инференса и потребление памяти.

👉Новости 👉База вопросов
Post #77 31
#полезное
🤯 Вычисление важности признаков: когда она вводит в заблуждение

Вычисление важности признаков (Permutation Feature Importance) — популярный метод оценки вклада признаков в модель. Однако при наличии коррелированных признаков он может давать искаженные результаты.

🟠 Разделение важности: если два признака (A и B) сильно коррелируют, перестановка одного из них не снизит качество модели, так как второй содержит ту же информацию. Итог — заниженная важность.

🟠 Ложная высокая важность: малозначимый, но коррелированный с важным признак может получить высокий вклад просто из-за связи с важным признаком.

Что делать?
✔️ Использовать SHAP, который корректно распределяет вклад.
✔️ Применять PCA или регуляризацию (Lasso) для снижения корреляции.
✔️ Проверять важность через drop-column importance.

👉Новости 👉База вопросов
Post #76 33
#полезное
📞 Шпаргалка: как выбрать AI-модель в 2025 году

🟠 ChatGPT — лучший для диалогов, генерации текста и объяснений.
🟠 Claude — глубоко анализирует длинные тексты.
🟠 Perplexity — идеально подходит для поиска и структурирования данных.
🟠 Gemini — интеграция с Google для актуальных сведений.
🟠 Grok — фокус на аналитике и технических задачах.
Полное сравнение моделей

👉Новости 👉База вопросов
Post #75 31
#Собес
🤔 Какие ключевые шаги включает в себя выполнение grid search в Scikit-Learn?

Для выполнения grid search необходимо определить сетку параметров, создать объект GridSearchCV , передать модель и параметры, а затем выполнить подгонку. По завершении можно получить наилучшие параметры через атрибут best_params_.

👉Новости 👉Платформа
Post #72 37
#статьи
😊 PyTorch: новые инструменты для для экономии памяти при обучении моделей.

PyTorch представил усовершенствованные методы Activation Checkpointing (AC), цель которых - снижение потребления памяти при обучении.

Традиционный подход в eager mode сохраняет промежуточные активации для обратного прохода, что зачастую приводит к значительному расходу ресурсов. AC позволяет не сохранять эти тензоры, а вычислять их заново при необходимости, тем самым жертвуя вычислительным временем ради экономии памяти.

Новая техника – Selective Activation Checkpoint (SAC). В отличие от обычного AC, который затрагивает всю выбранную область, SAC дает гранулярный контроль над тем, какие операции следует пересчитывать, а какие – сохранять. Это достигается за счет использования policy_fn, определяющей, нужно ли сохранять результаты конкретной операции. SAC будет полезен для избегания перевычисления ресурсоемких операций, например, матричных умножений.

Для torch.compile стала доступна Memory Budget API. Эта функция автоматически применяет SAC с оптимальной политикой, исходя из заданного пользователем бюджета памяти (от 0 до 1). Бюджет 0 соответствует обычному AC, а 1 – поведению torch.compile по умолчанию.
Читать подробнее

👉Новости 👉База вопросов
Post #71 37
#полезное
🛞 Ускоряем t-SNE с помощью GPU

Одна из главных проблем t-SNE — его время выполнения квадратично зависит от числа точек данных.

🟠 Если у вас 20k+ точек, стандартная реализация sklearn становится очень медленной.

🟠 tSNE-CUDA — оптимизированная версия t-SNE на GPU, которая в разы ускоряет вычисления.

👉Новости 👉База вопросов
Post #70 37
#Собес
🤔 Как обрабатывать несбалансированные классы в наборе данных с помощью Scikit-Learn?

Для обработки несбалансированных классов в Scikit-Learn можно использовать ресэмплинг (undersampling или oversampling), а также классические веса для алгоритмов, поддерживающих этот метод, например, для SVM или Random Forest. Это помогает модели лучше распознавать редкие классы.

👉Новости 👉Платформа
Post #68 45
#полезное
😇 Vaex — быстрая альтернатива Pandas для работы с большими данными

Vaex — это библиотека DataFrame, специально созданная для работы с огромными наборами данных (миллионы или даже миллиарды строк) без перегрузки памяти и падения производительности.

Импорт:
import vaex

df = vaex.open("big_data.csv")
print(df.shape)


Фильтрация данных:
filtered_df = df[df.age > 30]


Вычисление среднего значения:
mean_salary = df.salary.mean()
print(mean_salary)


Группировка данных:
df.groupby("job_title", agg=vaex.agg.mean("salary"))

Ссылка на библиотеку

👉Новости 👉База вопросов
Post #67 48
#полезное
🤯 Умножение матриц

Без умножения матриц ИИ просто не смог бы существовать.

🟠 Нейронные сети: Фото, текст, звук — всё представляется в виде матриц. Их умножение позволяет ИИ понимать и распознавать образы.

🟠 Компьютерное зрение: Фильтры сканируют изображения, выделяя контуры, формы, объекты — так ИИ "видит" мир.

🟠 NLP (Обработка текста): В ChatGPT внимание распределяется с помощью матриц, определяя, какие слова важнее.

🟠 Рекомендации: Netflix анализирует, какие фильмы вы смотрите, умножая матрицы предпочтений. Именно так он предсказывает ваш следующий любимый сериал!

🟠 Обучение с подкреплением: Как ИИ обыгрывает чемпионов по шахматам? Он умножает матрицы состояний и действий, просчитывая лучший ход.

👉Новости 👉База вопросов
  • 👍 1
Post #66 35
#полезное
👍 Замените describe на Skimpy

Если вы до сих пор используете метод describe в Pandas, есть отличная альтернатива, о которой стоит узнать! Skimpy — open-source инструмент, который дает гораздо более полное представление о ваших данных.

Skimpy не просто выводит статистику, но и показывает:
✅ форму данных;
✅ типы данных в колонках;
✅ распределение данных в графическом виде

👉Новости 👉База вопросов
Post #65 36
#Собес
🤔 Как оптимизировать гиперпараметры в модели Scikit-Learn?

Для оптимизации гиперпараметров в Scikit-Learn используют GridSearchCV или RandomizedSearchCV. GridSearchcv пробует все возможные комбинации
параметров, в то время как RandomizedSearchCV выбирает случайные комбинации, что ускоряет процесс. Оба метода возвращают наилучшие параметры для модели.

👉Новости 👉Платформа
Post #62 36
#полезное
🤯 Впечатляющая оптимизация скорости

Большие DataFrame в Pandas могут потреблять огромное количество памяти.

✅ Обработка данных небольшими частями помогает избежать переполнения памяти и ускоряет доступ к данным!

👉Новости 👉База вопросов
Post #61 37
#полезное
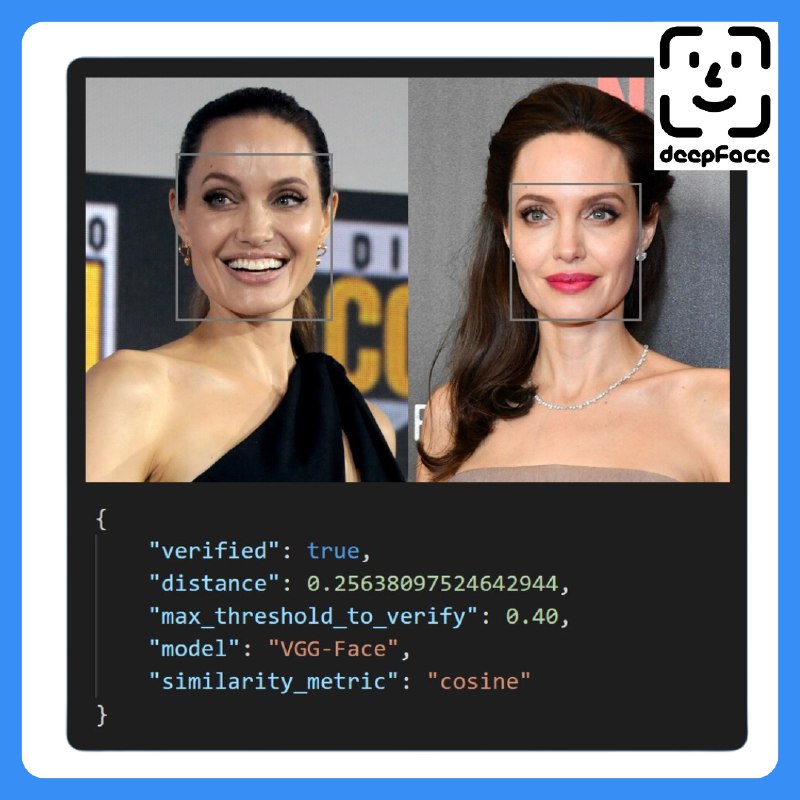
🤓 DeepFace — инструмент для распознавания лиц в Python

DeepFace — это лёгкий фреймворк для анализа лиц и их характеристик (возраст, пол, эмоции, раса). Он объединяет передовые модели, такие как VGG-Face, FaceNet, OpenFace, DeepID, ArcFace и другие.
Гитхаб

👉Новости 👉База вопросов
Post #60 33
#полезное
😊 Логистическая регрессия vs. Многослойный персептрон

На изображении сравниваются два метода классификации данных: логистическая регрессия (слева) и многослойный персептрон (MLP, справа) после 25 эпох обучения.

✅ Результаты показывают, что MLP лучше справляется с нелинейно разделимыми данными, в отличие от логистической регрессии, которая проводит лишь простую линейную границу.

👉Новости 👉База вопросов
Post #59 33
#Собес
🤔 Как реализована кросс-валидация в Scikit-Learn и почему это важная техника?

B Scikit-Learn кросс-валидация реализована через модуль model_selection, c функциями, такими как cross_val_score И cross_validate . Эти функции делят
данные на несколько "слоёв" (folds), обучают модель на k-1 из них и тестируют на оставшемся. Этот процесс повторяется к раз с каждым слоем в роли тестового. Кросс- валидация помогает снизить переобучение и даёт более объективную оценку работы модели.

👉Новости 👉Платформа
YeaHub YeaHub — тренажер собеседований по IT 5000+ вопросов для подготовки к интервью. Фильтры, квизы, статистика!
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →