TGViewer
Channel Public Channel
Андруша пишет код

Андруша пишет код

@xavescor_code

Subscribers
1.33K
Photos
162
Videos
2
Links
243
Recent Posts 13 shown
Post #383 605
Тут в моём казахстанском пузыре происходит прикольная вещь.

Ща, в пятницу, в кз обьявлен траур на уровне всей страны и я вижу какой-то странный флешмоб.
https://tengrinews.kz/
https://hcbarys.kz/
https://egov.kz/kk

Тупо весь казнет посерел. Причём это касается как частников, так и госушные ресурсы. Не знаю спущено ли это сверху(сомневаюсь, потому что, к примеру FC Astana и Air Astana не посерели, хотя это тоже весьма крупные и значимые компании в Астане), но выглядит прикольно. И я считаю что это надо зафиксировать, потому что когда был прошлый траур(где-то полгода-год назад года 3 назад) такого не наблюдалось.
Причём это коснулось и телеграм каналов.

Такая фигня, малята.
  • 💩 9
  • 👍 6
  • ❤ 1
  • 🤡 1
Post #382 1K
Чуть чуть проснусь от спячки по важному поводу. Мы походу пришли к AGI в ЛЛМках.

Ну, точнее, к ситуации, когда провайдеры моделей не могут ничего выдать архибольшого в качестве и поэтому приходится воевать ценой.

Сегодня опенаи представили свои модели Luna и Sol, у которых из изменений, которые реально интересны кому-то - это очень сильное снижение цены. Примерно в 2 раза.

Luna: 0.2/1.2 -> 0.1/0.5 за 1М токенов
Sol: 4/20 -> 2/10 за 1М токенов.

У Антопика такая же петрушка. Они сегодня представили новый опус, основной смысл которого - это скинуть прайс на 20%

5/25 -> 4/20

Так что поздравляю, кмк, гонка перфа окончилась. Теперь идёт гонка по ценам. Скоро будем купаться в дешевых токенах
  • 👍 16
  • 💩 8
  • ❤ 2
  • 🔥 1
  • 🤡 1
Post #381 2.07K

Forwarded from Stanislav Belyaev

Уже почти месяц прошел после взлома моделями OpenAI – HuggingFace. Спустя это время каждая уважающая себя лаборатория сказали, что они тоже могут взламывать! Антропик, Кими, и Цукерберг недавно

Но, после спора с @XaveScor в чате про то, где была память, как хранились данные, я покопался в деталях всех отчетов, чтобы ответить на эти вопросы.

А также, на заголовки, которые пишут – модели стали думать, модели живые и т.д!

Ответы тут
https://mysummit.school/blog/ai-agent-vzlom-hugging-face/

А спойлеры:
• Модели не сами решили пойти взламывать мир. Им сказали это делать инженеры, как и @XaveScor утверждал
• Модель не столь умна, сколь упорна. За 4 дня были сделаны тысячи различных попыток, чтобы осуществить атаку. И только меньше 100 действий оказались успешными (0.3%)

Описал простым языком, без технических деталей
mysummit.school ИИ-агент взломал Hugging Face: 17 600 попыток и один успех | mysummit.school - Практический блог об ИИ в менеджменте Автономный ИИ-агент взломал Hugging Face: 17 600 попыток, одна удачная цепочка и ноль команд от человека. Разбор без фантастики – и выводы для менеджера.
  • 🔥 12
  • ❤ 2
  • 👍 2
  • 💩 2
  • 🤡 2
Post #380 1.73K
https://t.me/denissexy/11581

Знаете, меня очень сильно удивляет вопрос: какого чёрта подобные новости описывают всякую фигню по типу "ой, модель проэксплуатировала уязвимость, потом повысила права ..." и прочую фигню полнейшую.

Ну уязвимость и уязвимость. А вот главное: то что атака длилась 3 дня - просто мимоходом пишут. МОДЕЛЬ РАБОТАЛА 3 ДНЯ. Т.е. где-то хранился процесс, где-то была память. Деталей об этом 0.

Но зато 100500 мегабайт шизы о том как там привелегии повышались.
Ещё 10 мегабайт как в интернет ходила
Ещё мегабайт о том как заметала следы.

Я уверен что она ещё и мимоходом онлифанс создала, чтобы денег заработать и арендовать телефонную линию и заскамить людей по телефону в северной Корее.

Но как она работала 3 дня и сохраняла память? Да кому это интересно? Вон, мы сняли тикток об этой истории. Ещё и Майкла Бея наняли, чтобы всё взрывалось и пердело радугой
Telegram Denis Sexy IT 🤖 Вот пересказ этой истории по версии Hugging Face, много тех-терминов – но без них не перескахать Если коротко – агент OpenAI на новой модели не стал решать тест по кибербезопасности, а решил просто украсть ответы и украл 🗿 Таймлайн: 📔 9 июля – агент проходит…
  • 😁 16
  • 👍 8
  • 💩 5
  • 🤡 3
  • 💯 2
Post #379 1.3K
Антропик: китайцы дистилируют наши модели, надо забанить их
Опенаи: китайцы дистилируют наши модели, но не баньте их
Гугл: https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/tuning/distillation

UPD: ой, страница куда-то делась. Теперь тута https://web.archive.org/web/20260728173925/https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/tuning/distillation
  • 🤡 8
  • 💩 3
  • 😁 2
  • ❤ 1
Post #378 1.34K
При разработке сервисов, кмк, стоит думать не только о том как офигенно можно всё сделать, но и об юнит экономике. Потому что когда ты даёшь пользователям безлимитный доступ за какую-то ограниченную фиксированную денюжку, к примеру, 20$ в месяц, то надо делать так, чтобы пользователь не потратил эти 20$ на работу сервиса.

Вчера я выкатил контекстуальный перевод субтитров в @eyespoken. Единственный способ сделать это нормально - это через ЛЛМ, так как мне нужно иметь немного особый формат перевода. Пример на скриншоте(Внутрь английского текста запихиваем фразу на русском).

И тут вопрос по поводу того какую модель использовать. Я решил попробовать пойти во все тяжкие и заэкономить по-максимуму: взять deepseek-v4-flash без ризонинга. И это получается вполне дешево(около 0.005 доллара за запрос) и быстро(1-1.5с).

Однако я довольно большая скряга, поэтому решил побыть ещё и немного мудаком. Есть такой сервис: opencode go(рефссылка для получения бонусов: https://opencode.ai/go?ref=BW9KJ8V3JK). По их документации они дают х6 по деньгам по части моделей. Т.е. подписка стоит 10 баксов, а ты можешь потратить 60 долларов по API ценам.

Я прогонял дипсик весь прошлый месяц по подписке за 5$ и, судя по биллингу, потратил 26.3 доллара в эквиваленте АПИ. Так что если вам нужны китайцы для каких-то периодических задач, то ходить к ним напрямую или через опенроутер тупо финансово глупо: берите аккаунты опенкода и утилизируйте их. Получится куда дешевле.

Но важно: там есть 5 часовые, недельные и месячные лимиты. Так что если не укладываетесь, то просто возьмите 2+ аккаунтов.

А если хотите попробовать изучать английский на интересном вам контенте: велком https://t.me/eyespoken/2
  • 👍 10
  • 💩 9
  • 🤡 4
  • 🔥 2
  • 🍓 1
Post #377 1.14K
Хроники @eyespoken продолжаются.

Что может быть проще чем сделать перевод текста с одного сверхпопулярного человеческого языка на другой?(с английского на русский)
Закинул в буквально любую ЛЛМку(даже в gpt oss 20b) и получил перевод. Вроде всё просто.

Но когда я внедрил перевод к себе(кликнул на слово - увидел +- умный перевод) - оказалось, что не всё так просто:
1. Модели жудко медленные. Если будет 60-70t/s в среднем - это уже хорошо
2. Модели думают ОООООООООООчень много. Даже 300 токенов ризонинга при скорости в 80t/s - это около 4 секунд ожидания ТОЛЬКО на ризонинге.
3. Многие модели в принципе не дают отключать ризонинг(антропик, кими, опенаи, гпт привет). А low(там где он есть) - это минимум 1000(ТЫСЯЧЯ!!) токенов на ризонинг.
4. И в такой ситуации даже церебрас с их 500t/s не спасает, так как 1000 токенов(low у gpt oss 120b) - это всё равно 2 секунды.

Славься дипсик, который позволяет в принципе отключать ризонинг, но у них другая проблема. Они не умеют в structured output. И в итоге получается, что реатайма, де факто, в мире ЛЛМ не существует. Нужно прямо очень поприседать, чтобы модель предсказуемо и быстро отвечала.

Пока я вижу только 1 выход:
- пользоваться моделями у которых можно тупо отключить ризонинг
- самому через structured output(https://developers.openai.com/api/docs/guides/structured-outputs) или tool_calls(https://api-docs.deepseek.com/guides/tool_calls) задать то куда думать модели, чтобы повышать качество в тестах.

А так - пока хз куда копать для реалтайма
OpenAI Developers Structured model outputs | OpenAI API Understand how to ensure model responses follow specific JSON Schema you define.
  • 🤡 7
  • ❤ 4
  • 💩 3
  • 🔥 2
Post #376 1.11K
Я никогда не понимал на кой чёрт нужны все эти тесты в стиле "смотри, новая гопота смогла сделать земной шар, а кими не может". Потому что это настолько оторванно от реальности, что я даже хз что это показывает.

Но сегодня я проникся:
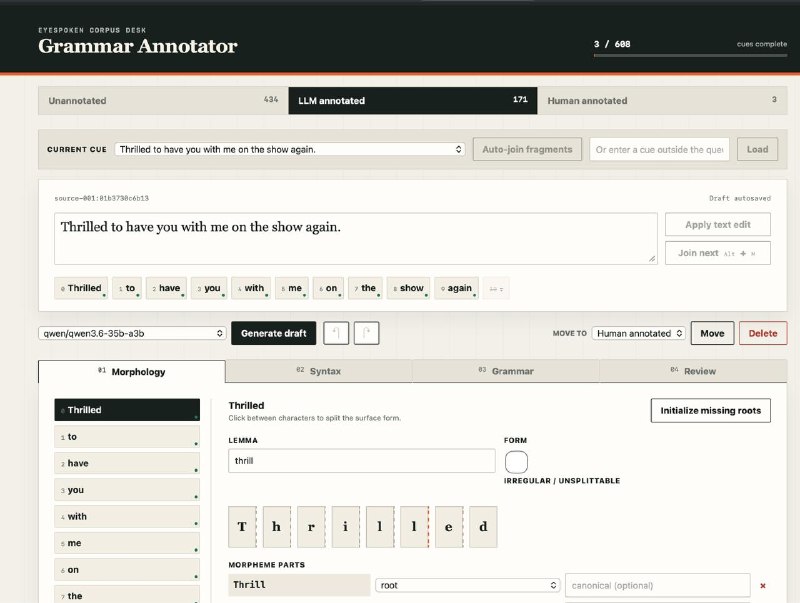
Я делаю сервис по изучению иностранных языков @eyespoken и, увы, пришёл к тому, что мне надо обучать свою модель, так как всё что есть в опенсорсе, увы, не справляется с разметкой субтитров.
И тут, увы, я столкнулся с тем, что просто не существует на рынке нормальной тулзы для разметки текста. Причём в формате, который мне нужен. Потому что читать json'ы глазами, даже форматированные, в случае разметки тупо невозможно. Нужен интерфейс.

И тут гопота 5.6 Sol(mid) зашла как по маслу. Промпт был бквально такой "мне нужен интерфейс, чтобы руками размечать данные для моей модели". И через 25% недельного лимита(на подписке за 100$) был сделан весьма приятный, а главное рабочий, интерфейс. А что там внутри него - как-то пофигу. Главное что я могу экспортировать оттуда данные.

Так шо, внезапно, даже самая шиза иногда бывает полезной. И не стесняйтесь генерить себе всякие одноразовые инструменты. Оно уже работает
  • 🔥 11
  • 💩 6
  • 🤡 4
  • ❤ 2
Post #375 1.47K
Телеграм редко когда добавляет что-то полезное, в отличии от новых кончающих баклажанов, последние пару лет, но текущая фича походу вполне норм.

Создавайте сообщества и в списке чатов смотрите на стрелки вниз. За ними может оказаться достаточное количество материалов от интересных для вас личностей

P.S. Если создали сообщество, то первым делом идите в его настройки и отключите разрешение добавлять в сообщество чаты неадминам. А то вам быстро туда фигни накидают
  • 💩 9
  • 🤡 7
  • ❤ 4
  • 😁 2
  • 🌭 2
Post #372 1.61K
Хочу чутка похвастаться/порекламировать сервис, который я сейчас разрабатываю.

Очень кратко тут в тексте, подробно же в прикреплённом видео.

ТЛДР: сервис изучения иностранных языков с помощью нейросетей(надо же инвестиции поднимать(нет))

1. у нас есть ютуб с отличной рекомендательной системой и контентом на любой вкус и возраст
2. нейронки позволили очень быстро размечать текст(субтитры) на якорьки в виде грамматики, переводов и прочей фигни, которая позволяет запоминать языковые конструкции.
Даже если ты не запомнишь сразу, то ты будешь видеть один и тот же якорёк 5, 10, 20 и более раз. И даже если ты такой как Андруша, то ты всё равно запомнишь эту конструкцию и будешь понимать как её применять тупо из своей практики(интересных тебе видосиков с ютуба)
3. Чтобы ты не читерил и не читал сабы 24/7, то мы тебе их показывать не будем. Если ты понимаешь, что не понимаешь что говорится в текущем сегменте видео, то нажимаешь клавишу "a/ф"(пофигу на расскладку) и мы тебе показываем караоке в 5 секундах до(чтобы ты понял контекст) и 2s после(чтобы ты точно расслышал слово), после чего субтитры скрываются
4. Если ты даже с сабами на понимаешь смысл слова, то не беда, кликай на него и увидишь якорёк, который поможет тебе разобраться

И вот таким макаром, аутируя на ютубе 100500 часов, ты +- сможешь подучить язык, потому что твой мозг вынужден работать. А самый простой способ не работать - выучить язык.

За остальным в видео.

=====

Так как ревью в магазинах расширений не мгновенное(а гугл ещё владеет и ютубом и очень не любит, когда ютуб меняют под себя), то пока что у меня на руках есть только сборки плагинов. Ищите их в комментариях

=====

Ну и вступайте в чатег, если интересна эта тема @eyespoken

=====

Спасибо Firefox. Опубликование было достаточно быстрым.

https://addons.mozilla.org/en-US/firefox/addon/eyespoken/

Открывайте интересное вам видео, жамкайте "a/ф" в непонятные моменты и обучайтесь.
Пока поддерживается только английский язык
  • ❤ 23
  • 🔥 7
  • 💩 7
  • 🤡 4
  • 👍 3
Post #369 1.49K
Тут очень громкой новостью за последний месяц было переписывание достаточно крупного проекта с Zig на Rust в 90%-автоматизированном режиме.

https://bun.com/blog/bun-in-rust
ТЛДР: старый код был плохой, Zig не подходил, а вот с переписыванием на раст стало всё лучше, быстрее, бинарь меньше и вообще все красавчики. И ваабще я всё сделал сам, гоняя 64 клод кода параллельно, потратив 200к баксов в токенах
Однако есть нюанс: с момента переписывания до релиза прошёл примерно месяц(релиз на дату опубликования поста всё ещё не произошёл).
Тихой сапой чот кодовую базу лечили руками и ногами

Так же есть ответка как это видят со стороны Zig'а:
https://andrewkelley.me/post/my-thoughts-bun-rust-rewrite.html
ТЛДР: да там вапще говнокодеры, делают фигак-фигак и в продакшен и вообще спасибо что теперь не давите на нас своим авторитетом, скатертью дорога.

Без шуток советую прочитать оба текста. Они весьма полезны, кмк.
Как минимум мы имеем на практике подтверждение, что агенты могут с высокой долей автономности делать критические задачи. Да говнокод, да капец, но работает.

Плюс рекомендую посмотреть в ишаки и пуллики бана: там очень автоматизированно всё делается через бота robobun, который автоматом пытается воспроизвести ишью, и закинуть PR
https://github.com/oven-sh/bun/pulls

Правда с такой степенью автономности в репозитории ровно 0 линтеров на основе агентов. Простой пример того что есть у меня:
- я поверх опенкода и глм5.2 написал простой скрипт: проанализируй кодовую базу. Во всех местах где есть MutationObserver убедись что он нужен. Возможно, его можно заменить с помощью современного css(браузеры такие то в проекте) или же через window.matchMedia.
И гоняю я подобные скрипты внутри PR'ов. И сразу позволяю поправить код внутри них, чтобы в мастер уже попадала красотулька, а не кусок слопа, который у меня вышел по результатам решения задачи.

Так шо мотайте на ус, заменяйте себя там где заменяется, автоматизируйте очевидные рефакторинги и будет вам счастье. Современные дешевые модели уже достаточны для того, чтобы вычищать говнокод тоннами из репозиториев. Осталось только вычищалку написать
  • 💩 10
  • 🤡 6
  • 👍 5
  • 🤮 2
  • ❤‍🔥 1
Post #367 1.9K
Не задумывались для кого делаются все эти мелкие локальные модели размерами 4b-70b, которые вы типа можете запускать на своих машинках?
Тип, если запустить модельку у себя, подключить в какой-то CLine и попробовать написать код, то получится полная шляпа. А если учесть цену на подписку на решения от openai, антропика или дипсика, то окажется, что локальные решения ещё и экономически неоправданы.

Но всё меняется в тот момент, когда ты делаешь какой-нибудь сервис по обработке текста. К примеру, поисковую систему по решениям судов. Да, можно пользоваться большими моделями, но учитывая их ценник, ты скорее обанкротишься, чем найдёшь людей, которые готовы будут тебе платить.

Если вы глянете в спецификацию openai протокола, то увидите любопытное поле text_format. Или же так называемый structured output. Он сейчас есть буквально у всех провайдеров https://developers.openai.com/api/docs/guides/structured-outputs?lang=python&example=structured-data.
Эта штука позволяет буквально управлять тем что модель генерирует на выход.
Простой пример: вы задаёте что контент должен быть формата

type Output = {
foo: string,
}

И обработчик ответа будет отбрасывать все токены в аутпуте, пока модель не сгенерирует в ответе именно "foo": "<и тут дальше строка>.

И тут уже пригождаются маленькие модели. Потому что они, да, тупые, но мы можем делегировать программисту самую главную задачу: думать.
Мы можем форматом ответа тупо задавать то в какую сторону может думать модель(см. картинки 1 и 2)

К примеру, я сейчас использую gpt oss 20b для своего сервиса переводов для сериалов и ютуба и её вполне достаточно. Надо просто сделать почти всю работу за модель:
- достать из словарей возможные значения слов
- описать контекст сцены
- подсветить всякие нюансы по типу "эти слова в языках слишком похожи(ложные друзья переводчика), поэтому давай переводить по-другому"
- задать пайплайн рассуждений через structured output
И, внезапно, модель, которая на церебрасе стоит $0.4/$0.4 за 1М токенов и скоростью 500 t/s начинает иметь смысл.

А вот для работы с человеком брать что-то меньше чем всякие попусы и гопоты 5.5 смысла нет, это правда. Слабые модели только для всяких узеньких и конкретных задач

Ссылки:
- https://developers.openai.com/api/docs/guides/structured-outputs?lang=python&example=structured-data
- https://abdullin.com/schema-guided-reasoning/
  • 👍 13
  • 💩 3
  • 🤡 2
  • ❤ 1
  • 👎 1
  • 🔥 1
Older posts →

About this channel

How can I read @xavescor_code without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Андруша пишет код: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Андруша пишет код have?
Андруша пишет код (@xavescor_code) has 1.33K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Андруша пишет код know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →