TGViewer
Channel Public Channel
Душный NLP

Душный NLP

@stuffynlp

Разборы свежих статей от NLP-специалистов Яндекса. Подробно, полезно, с душ(нот)ой.

Вопросы и предложения > @yandex_ml_brand
Subscribers
6.69K
Photos
282
Videos
2
Links
152

Showing posts older than #241 · Back to latest

Older Posts 12 shown
Post #240 3.26K
NVIDIA Nemotron 3: Efficient and Open Intelligence

Сегодня разберём статью о пополнении в семействе Nemotron — новом поколении гибридных моделей с Mamba2 от NVIDIA.
В Nemotron 3 входят три модели. Уже доступна Nano 30B-3A на более чем 3B параметров. Super и Ultra ещё не релизили, обещают 100B и 460B соответственно.

Модели обучены в FP4. Авторы утверждают, что Nano поддерживает контекст до 1 млн токенов, в паритете с GPT-OSS-20B-4B и превосходит Qwen3-30B-A3B по бенчмаркам, а на инференсе работает в 3 раза быстрее.

Инфраструктурно в Nano нет ничего нового. Пропорции архитектуры тоже вполне стандартные — 23 слоя Mamba-2 к 6 аттеншнам. Интересен порядок чередования обычных и линейных аттеншнов. Рассмотреть его можно на схеме: обратите внимание, что в конце не аттеншн.

Ещё одна любопытная деталь — использование Shared Expert: кто-то, как Qwen, избегает этого элемента в своих моделях. Другие, среди которых DeepSeek, наоборот, добавляют.

Активацию реализовали с помощью ReLu². Для гейтинга вместо softmax выбрали сигмоидную функцию. Возможно, в следующих релизах будут более новые вариации. GQA — 2KV-головы, RoPE нет даже в полном аттеншне.

Также интересен LatentMOE. Он похож на MLA для MOE в DeepSeek, который позволяет сжать токены и считать Shared Expert на гораздо меньших тензорах. Главное отличие — возможность выбрать в несколько раз меньшее пространство для токенов и активировать пропорционально больше экспертов. Это не даёт выигрыша в компьюте, но улучшает результаты по бенчмаркам относительно обычного MOE.

Познакомиться поближе с Nemotron 3 Nano и данными, на которых её обучали, можно на сайте семейства.

Душный NLP
  • ❤ 15
  • 👍 9
  • 🔥 7
  • 🌚 1
Post #239 4.25K
Qwen3-Next, или Как RNN эволюционировали в гибридные linear attention

В эпоху агентов, ризонинга и мультимодальности длинные контексты начинают играть всё более значимую роль. Привычный нам softmax attention из-за своей квадратичной зависимости от длины контекста сильнее влияет на эффективность обучения и инференса.

Для решения проблемы квадратичности попробовали обратиться к RNN. Так появился новый класс аттеншнов — linear attention. Как следует из названия, они зависят от длины контекста линейно, что делает их в разы эффективнее на больших контекстах. Но модели, которые используют только linear attention, плохо справляются с retrieval-задачами (ещё вернёмся к этому вопросу в посте).

Объединив лучшее из двух подходов, ML-разработчики получили гибриды. Сегодня разберём, как они устроены, на примере одной из самых хайповых современных моделей — Qwen3-Next.

Вспомним, что представляют из себя современные линейные аттеншны. По сути, это RNN, только вместо векторного состояния — матричное, побольше. Ещё в линейных аттеншнах есть механизмы забывания — гейты. Вместо того, чтобы как полный аттеншн хранить весь прошлый контекст в KV-cache (который растёт с увеличением длины последовательности), линейные аттеншны учатся сжимать весь контекст в стейт фиксированного размера. А гейты помогают лучше регулировать, что запомнить и забыть.

Но бесплатный сыр бывает только в мышеловке: из-за сжатия контекста в стейт фиксированного размера в линейных аттеншнах нет доступа ко всей исходной последовательности. То есть, точно скопировать рандомный токен не получится. Поэтому-то и страдают задачи retrieval и копирования. Но чтобы справиться с этим, достаточно нескольких слоёв с полным атеншеном.

Вернёмся к Qwen3-Next. Рассмотреть её архитектуру можно на схеме. Три четверти слоёв — линейный атеншен в лице Gated DeltaNet. 3/4 — довольно распространенная пропорция. Также в этой архитектуре проапгрейдили обычный полный аттеншн с помощью swiglu-like-гейтинга. Это улучшило качество и решило проблему с attention sink.

Partial Rope, как следует из названия, «крутит» только часть хидденов головы. В Qwen3-Next только четверть хидденов головы получает информацию о позиции в последовательности. По словам авторов, это позволяет лучше экстраполироваться при увеличении контекста.

Zero-Centered RMSNorm математически эквивалентен обычному RMSNorm. Единственное отличие — веса инициализируются нулями, а не единицами, и потом на форварде к весу прибавляется 1. Формально это одно и то же, но из-за того, что веса теперь у нуля, где выше гранулярность float’ов, численная стабильность улучшается. Ещё более важно, что это позволяет использовать WD для весов в RMSNorm: некоторые веса становились слишком большими, добавление WD улучшило стабильность обучения.

Sparsity очень высокая — 1/50. Для масштаба, у DeepSeek она составляет 1/32, у Qwen235B — 1/16. Из 80B параметров активны только 3B.

Познакомиться с Qwen3-Next поближе можно на HuggingFace. А ещё недавно вышла новая линейка моделей, основанная на той же архитектуре — Qwen3.5. В текущем опенсорсе это SoTA.

Разбор подготовил ❣ Даниил Сухой

Душный NLP
  • 🔥 19
  • ❤ 12
  • 👍 1
Post #238 3.94K
Quartet II — обучение в NVFP4 с точными несмещёнными градиентами

В последние годы наблюдается тренд на снижение точности, в которой обучают модели. Если ещё недавно использовали преимущественно BF16, то в 2024-м, например в DeepSeek-V3 — уже FP8, а в 2025-м переходят и на FP4. Снижение точности, однако, требует применения трюков. Сегодня разберём статью, в которой описывается новый метод обучения в NVFP4.

Прошлым летом мы придумали Quartet — первый метод обучения в FP4. Он использовал формат данных MXFP4, который поддерживается на уровне железа в GPU, вроде NVIDIA Blackwell. Quartet использовал случайные вращения тензоров для борьбы с аутлаерами и показал, что FP4 обучение даёт выигрыш при фиксированном бюджете относительно FP8.

Но есть и другой формат, основанный на FP4, — NVFP4, который NVIDIA создала специально для LLM. Он использует более точные FP8-скейлы. На его основе прошлой осенью NVIDIA предложила собственный, более точный рецепт обучения в FP4. Одной из его фишек было использование стохастического округления (stochastic rounding, SR) на backward pass — методики, которая делает оценки градиентов несмещёнными ценой более высокого уровня их шума. Мы задались вопросом: есть ли способ достичь несмещённых оценок без шумного SR в FP4?

Оказывается, вращения, которые помогали нам с аутлаерами, могут помочь и с несмещённостью. Квантизуя случайно повёрнутый тензор, мы усредняем ошибку по всем возможным направлениям, и получившаяся оценка будет коллинеарена оригинальному тензору. Отнормировав квантизованный тензор, коллинеарность можно превратить в несмещённость. Но FP8-скейлы не позволят просто так отнормировать квантизованный тензор — они слишком грубые, чтобы впитать точную перенормировку порядка 0,94~1,06.

Какой выход? Вшить эти скейлы в FP8 с помощью SR. Обратите внимание, что делается это не на каждый FP4-элемент, как в случае с методом NVIDIA, а только в FP8-скейлы, что даёт ошибку в сто раз меньше. В итоге, полная ошибка получается вдвое меньше, чем у простого SR. Мы объединили метод с более точной квантизацией на forward pass и получили Quartet II — SOTA обучения в NVFP4.

Таким образом, случайные вращения не просто борются с аутлаерами, а служат важным источником несмещённости в оценке градиентов, который уменьшает ошибку и ускоряет сходимость FP4-обучения. К статье прилагаются кернелы для 5090 и B200, чтобы можно было попробовать NVFP4 на своих моделях и задачах.

Разбор подготовил Андрей Панфёров, автор канала black_samorez

Душный NLP
  • 🔥 18
  • ❤ 12
  • ❤‍🔥 6
Post #237 3.43K
Bridging the Gap Between Promise and Performance for Microscaling FP4 Quantization

Новые 4-битные форматы с плавающей точкой для хранения весов и активаций, которые на уровне железа поддерживают графические процессоры NVIDIA и AMD, обещают заметное ускорение времени инференса LLM без существенной просадки качества.

Сегодня разберём первое всестороннее исследование FP4-квантизации — работу, которую инженеры Yandex Research выполнили совместно с коллегами из Institute of Science and Technology Austria, Red Hat AI и ETH Zürich.

Квантизация — это способ сократить объём памяти, необходимый для хранения массива данных. Например, выбором весов активации из ограниченной сетки значений.

Выбор сетки зависит от того, насколько равномерно распределены ваши данные. Например, у integer сетка между всеми значениями равномерная, а у floating point — более густая около нуля, но чем дальше от него, тем разреженнее. То есть, в теории для равномерного распределения отлично подойдёт integer, а для распределения Стьюдента и других распределений с тяжёлыми хвостами лучше выбрать квантование с плавающей запятой.

На практике анализ показал, что современные методы чаще всего не справляются с FP4 по двум причинам:

— Малый размер групп одновременно квантизуемых весов в формате NVFP4, видимо, делает неэффективными традиционные методы уменьшения выбросов.

— Квантизация скейлов (мультипликативных факторов) MXFP4 к степеням двойки сильно снижает точность представления весов и активаций.

В работе предлагается улучшенная версия алгоритма квантования GPTQ — MR-GPTQ, адаптированную для форматов FP4:

1. Определяем сетку квантования, эффективную для MSE: попеременно оптимизируем сетку в масштабах каждого блока и тензора. Это позволило добиться значительных улучшений для NVFP4 без вращений. А для MXFP4 с Адамаровыми вращениями некий фиксированный масштаб сетки универсален для всех моделей.

2. Изменяем порядок квантизации весов. Алгоритм GPTQ перед квантизацией переупорядочивает колонки квантизуемого тензора в соответствии с величиной диагонали матрицы Гессе (колонки соответствующие большим диагональным элементами идут первыми). Перестановка повышает точность, но во время инференса приходится ещё раз переупорядочивать каналы в тензоре активаций, что приводит к замедлению на 10-20%.

Вместо этого предлагаем определять порядок колонок статически, предпосчитывая статистики групп заранее. Так удаётся достичь почти того же качества, что и при динамической перестановке, но без замедления

3. Вращаем активации во время инференса с помощью блочно-диагональных Адамаровых поворотов. Они, с одной стороны, позволяют уменьшить ошибку кватнизации, с другой — не замедляют время прямого прогона нейронной сети.

Эти три модификации помогают учесть особенности форматов FP4 и значительно повышают точность квантования по сравнению с предыдущими подходами.

Разбор подготовил ❣ Денис Кузнеделев

Душный NLP
  • ❤ 14
  • 🔥 7
  • 👍 4
Post #235 4.06K
Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models

Сегодня разбираем статью от DeepSeek на тему модификации трансформер-архитектуры.

Мотивация

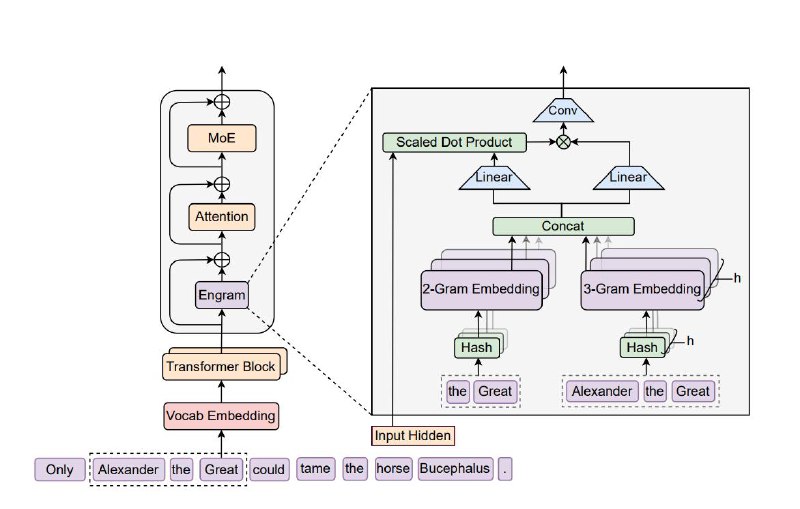
У трансформеров нет native primitive для knowledge lookup, поэтому ретривал им приходится симулировать вычислениями. Идея статьи — добавить в архитектуру явный inductive bias на ретривал через Engram-модуль и улучшить метрики.

Архитектура

Engram добавляют внутрь блока трансформера, но не во все слои, а максимум в два. Выход модуля добавляется к residual stream. В аблейшенах показали, что лучше всего вставлять Engram-модуль во 2-й слой, а комбинация 2-го и 6-го слоёв даёт более низкий validation loss.

Технически Engram-модуль представляет обучаемые словари nn.Embedding, на вход которых подаются отдельные hash'ы для 2- и 3-грамм. Также в модуле обучаются параметры: context-aware gating (вдохновленный аттеншном), свёртка по seq_len и RMSNorm'ы.

Проверяют модуль в MoE-моделях. В них есть параметры, которые не активны на forward. Allocation ratio (ρ) — это доля неактивных параметров, которая содержится в блоках экспертов; в MoE ρ=1. Параметры для Engram берут, уменьшая количество неактивных экспертов, поэтому становится ρ<1. Чтобы понять, какую долю параметров экспертов оптимально перенаправить в модуль, делают grid search, — запускают несколько претрейнов и меняют только ρ.

Как работает Engram

Работа модуля начинается с обработки входных токенов. Делают tokenizer compression: применяют детерминированные преобразования, чтобы привести токены к canonical ID. Это как стемминг или лемматизация, но для токенов.

Из последовательности токенов строят 2- и 3-граммы. Напрямую индексировать n-граммы нельзя (их слишком много), поэтому используют Hash Embeddings-подход для уменьшения коллизий в рамках небольшого словаря. Для каждой n-граммы получают хеш (вариация multiplicative-XOR), т.е. одно число. Используется несколько голов, поэтому на выходе получается несколько хешей-чисел. Это буквально индексы, по которым получают вектора из nn.Embedding, где у каждой головы и n-граммы независимые вектора — и дальше их конкатенируют.

Дальше — context-aware gating. Берут механизм сродни dot product attention: входной hidden state слоя используется как query, а к эмбеддингам применяют линейные преобразования, аналогичные W_K и W_V. В отличие от аттеншна здесь нет софтмакса, вместо него используется сигмоида, а полученные скоры поэлементно перемножаются с V.

Обучение и инференс

На обучении lookup table шардируют между девайсами, для пересылки нужных эмбеддингов используют all-to-all.

На инференсе таблицу можно вынести в RAM+disk, потому что её не нужно обновлять, только читать. Чтобы не проседал throughput, подсчёты Engram накладывают на основной forward pass: на вход модуля идут токены, значит часть эмбеддингов можно заранее преподсчитывать. В итоге для lookup table на 100B параметров потери по throughput < 3%.

Дополнительной памяти на Engram-модуль не требуется, так как параметры для него берут у неактивных экспертов MoE.

Эксперименты

Минимальный лосс получается, когда четверть неактивных параметров уходит в Engram. Это протестировали на двух бюджетах FLOPs.

На большой Engram-27B-модели метрики растут не только на knowledge-intensive-задачах, но иногда ещё сильнее на reasoning, math и code. На бенчмарках с длинным контекстом тоже получаются лучшие метрики.

Также проводят sensitivity-анализ, зануляя выход Engram-модуля, и видят, что сильнее всего это бьёт по задачам, требующих factual knowledge.

Так получается, потому что у модели увеличивается effective depth: ранним слоям не нужно заниматься knowledge lookup (имитировать его), и больше слоёв теперь могут «думать».

Самыми важными компонентами Engram-модуля оказываются branch-specific fusion (свой W_K для каждой ветки в mHC-архитектуре), context-aware gating и tokenizer compression. Меньше влияют свёртка и добавление 4-граммы (при условии, что будут делить общий бюджет параметров с 2- и 3-граммами).

Разбор подготовил Никита Курдюков из Т-Банка ❣ специально для @YSDA_YR_2019

Душный NLP
  • ❤ 14
  • 🔥 8
  • 🙏 3
  • 👍 1
  • 👎 1
  • 🤝 1
Post #232 4.53K
Mercury — диффузионная модель для написания кода

Сегодня разберём статью о диффузионной модели Mercury. На Copilot Arena она занимала второе место по качеству и первое — по скорости.

Диффузионные модели уже зарекомендовали себя в сфере генерации изображений. Авторы сегодняшней работы, в свою очередь, предлагают модель, ориентированную на решение задач программирования. Это объяснимо: диффузионные модели не очень хорошо подходят для генерации свободных коротких текстов, а код структурирован, в нём как правило много токенов.

Существует две версии Mercury Coder — Mini и Small. Подробности о них в публикации не раскрываются: мы не знаем их параметры и размеры. Заявлено, что Mini способна обрабатывать более 1100 токенов в секунду, а Small — 700. На претрейне использовали датасет объёмом в триллионы токенов, состоящий из интернет-данных, а также реальных и синтетических данных из проприетарных источников.

Что касается архитектуры, то, по сути — это трасформер, но с иным подходом к генерации. Модель стартует с зашумлённой версии ответа и на каждом шаге параллельно поправляет много позиций, постепенно «денойзя» последовательность. Длинны контекста модели — 32 тысячи токенов с расширением до 128 тысяч.

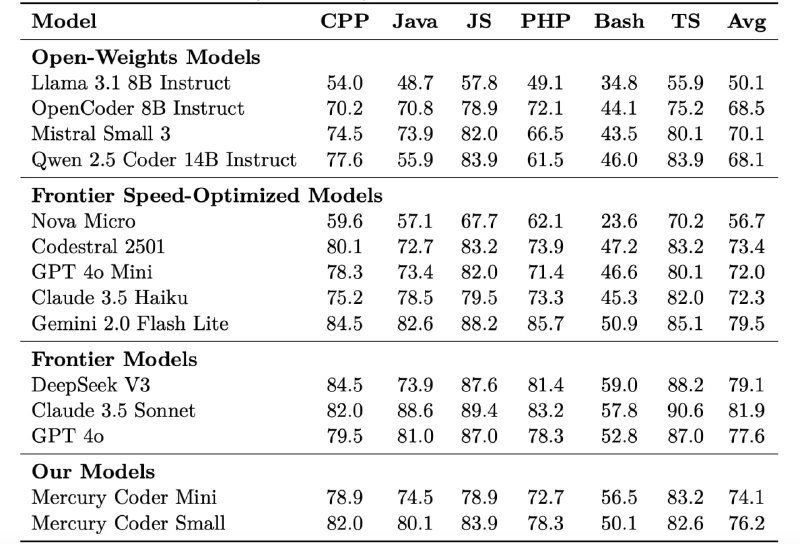
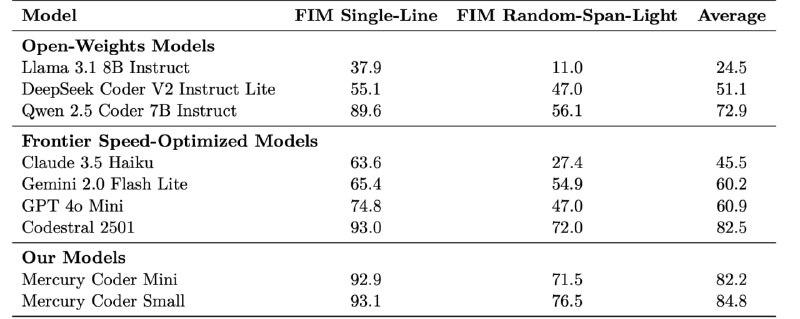
В большинстве бенчмарков Mercury Coder показывает себя лучше опенсорсных моделей, но уступает самым крупным и известным конкурентам вроде DeepSeek, GPT и Claude (таблица 1). То же самое касается и знания разных языков программирования — Mercury лучше опенсорсных решений, но хуже закрытых (таблица 2). При этом в плане скорости и при оценке fill-in-the-middle Mercury обходит даже именитых соперников (таблица 3).

Разбор подготовил ❣ Павел Темирчев

Душный NLP
  • ❤ 25
  • 👍 5
  • 🔥 3
Post #229 5.54K
Рекурсивные языковые модели

В последнее время всё чаще обсуждают проблему длинного контекста. Большое количество токенов просто физически не помещается в модели, а с увеличением контекста зачастую падает качество. Авторы сегодняшней статьи предлагают решение: дать моделям правильные инструменты.

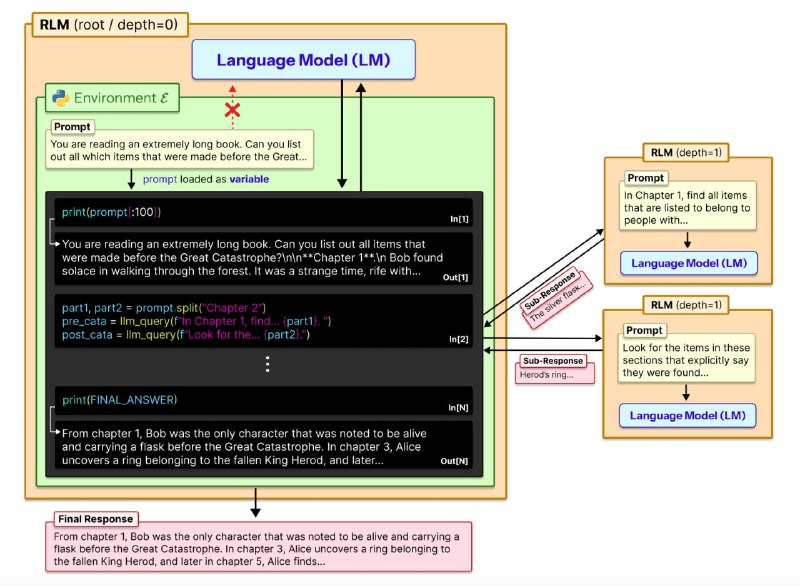
Как это устроено: у модели есть промпт с описанием задачи и доступных тулов. Первый — это Python REPL. Модель может исполнить произвольный код, где в переменной prompt сохранён весь длинный промпт.

Второй тул — это вызов языковой модели на глубине 1 (depth=1) с поданным фрагментом длинного промпта. Это напоминает субагентов в агентах для написания кода (Claude Code, Codex), но есть важное отличие. Вызов llm_query живёт «внутри» REPL, а значит модель может встроить его в цикл, условие или любую другую программную конструкцию. В Claude Code или Codex субагент — это отдельный тул-колл, который модель вызывает из контекста напрямую, без программного контроля. Такая модель называется рекурсивной (RLM), и их может быть несколько в рамках одного цикла. RLM не обязательно должна быть идентична изначальной. Главное, что у неё пустой контекст.

Суть метода, предложенного авторами статьи, в том, чтобы дать модели возможность запускать себя рекурсивно в той же программной среде (изображение 1). Среди бейзлайнов авторы рассматривают вариант без самовызовов (только модель с большим промптом и REPL), summary agent (суммаризация контекста, не поместившегося в модель) и CodeAct (код плюс ретривал через BM25).

Нюансы разницы RLM и типичных кодовых агентов до сих пор вызывают дискуссии с авторами в твиттере, и хайп вокруг статьи и идеи только растёт. Примеры тут, тут и тут.

Эксперименты проводили на Qwen3 и GPT-5 (изображение 2). На бенчмарке BrowseComp+ (контекст 6–11 миллиона токенов, нужно найти один релевантный документ из тысячи и ответить на вопрос) базовые модели невозможно запустить — контекст просто не влезает. RLM здесь работает.

Но поиск по длинному контексту — не единственная задача, которую решают RLM. Бенчмарк OOLONG требует семантической обработки фрагментов текста и их агрегации. Сложность линейная относительно длины входа. Здесь RLM без самовызовов уступает даже базовой модели, потому что задача требует «видеть» весь контекст. RLM с самовызовами заметно выигрывает у всех бейзлайнов.

Самый показательный результат на OOLONG-Pairs. Здесь нужно сравнивать пары фрагментов, то есть сложность задачи квадратичная. Базовая модель и summary agent выдают результат около нуля. RLM с самовызовами решает эту задачу, программно организуя квадратичное число вызовов через код в REPL. Это класс задач, недоступный другим подходам.

По стоимости RLM с самовызовами зачастую сопоставима с базовой моделью, хотя со сложностью задачи стоимость растёт (изображение 3).

Разбор подготовил ❣ Иван Рубачёв

Душный NLP
  • ❤ 24
  • 🔥 14
  • 👍 6
  • 👎 2
  • 🍌 2
  • 🤨 1
Post #227 9.66K
Как заставить агентов делать работу над ошибками

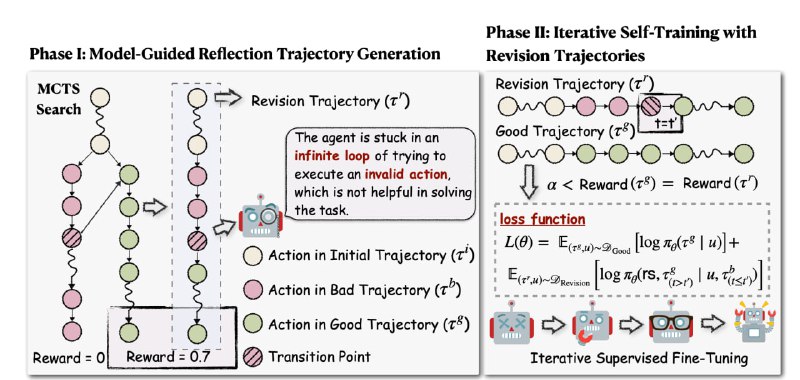
Сегодня разбираем статью об обучении агентов. Проблема такая: реворд-модели оценивают только результат в конце траектории, а если агент сделал ошибку и исправил её, нельзя сказать, когда это произошло. Если бы у нас была такая возможность, то мы могли бы раньше направить обучаемую LLM по нужному пути. Есть способы фиксировать ошибки и делать реворд по шагам, но это дорого и сложно в реализации.

Авторы предлагают метод Agent-R, суть которого заключается в обучении агентов не на правильных траекториях, а на тех, где есть явная ошибка и её исправление. Такие траектории получаются через Monte Carlo Tree Search. Берутся пары из одной стартовой точки (инструкции): одна траектория успешная, а другая — нет. На инференсе момент расхождения должна определить сама модель, а при обучении к началу провальной траектории добавляется фраза-рефлексия, которую генерирует агент, понимая, что он ошибся (CoT). Следом «приклеивается» хвост удачной траектории и на всём этом делают SFT. Такой подход, соединеняющий рефлексии и «хороший» хвост, снижает риск склейки не связанных траекторий.

В статье выводят следующие типы траекторий:

Initial Trajectory — общий начальный префикс.
Bad Trajectory — субоптимальные действия c низкой наградой.
Good Trajectory — оптимальные действия с высокой наградой.
Revision Trajectory — траектория, в которой агент совершил ошибку и исправил её.

Для получения Revision Trajectory можно брать плохие траектории, дожидаться их финала и переписывать. Однако так не получится обучить агента ловить ошибки на лету. Вместо этого авторы заставляют модель самостоятельно анализировать траектории и пытаться определить первый шаг, где совершена ошибка. На этом месте траектория обрезается, вставляется этап рефлексии и следом — правильная траектория.

Monte Carlo Tree Search позволяет собрать много разных траекторий с одним началом. Это удобно, так как можно сравнивать хорошие и плохие продолжения. Финальный реворд используется не для обучения напрямую, а для классификации траекторий по качеству — то есть, по сути, чтобы понять, что пойдёт в SFT-датасет. У реворда есть два порога: один отделяет плохие траектории от хороших, а другой выбирает уже из хороших лучшие.

Авторы отмечают, что обучаться только на Revision Trajectory нельзя — это мешает агенту определять правильные траектории. Поэтому изначально в датасет добавляют много Good Trajectory и постепенно в процессе SFT повышают порог реворда оптимальных решений, чтобы в конце оставались только лучшие из них. Кроме того, в датасет подмешивают обычные языковые данные, что помогает агенту не забывать, чему он обучался ранее.

Эксперименты проводили на Llama-3.1-8B, которую обучили на собранных Revision Trajectory. Результаты можно посмотреть в таблице, приложенной к посту. Авторы заявляют, что исправленные траектории оказываются даже лучше идеальных.

Разбор подготовила ❣ Карина Романова

Подписывайтесь на канал Карины «что-то на DL-ском» — там познавательно и можно ставить реакт кота в парике.

Душный NLP
  • ❤ 24
  • 🔥 7
  • 😁 3
  • ❤‍🔥 2
  • 👏 1
Post #226 5.64K
Seeing Eye to AI: Human Alignment via Gaze-Based Response Rewards for Large Language Models

Сегодня разберём статью о GazeReward — фреймворке, который интегрирует неявную обратную связь eye-tracking (ET) в модель вознаграждения (RM).

GPT, Llama, Claude, Gemini и другие популярные LLM отлично справляются с самыми разными задачами, но результат их работы не всегда соответствует ожиданиям пользователей. Модели часто донастраивают с помощью Reinforcement Learning with Human Feedback (RLHF), но и этот метод недостаточно хорош для точного моделирования предпочтений.

В GazeReward авторы предлагают учитывать данные о движении и фиксации человеческих глаз (eye-tracking или просто ET) в качестве дополнительного сигнала о том, как пользователи воспринимают информацию.

Для интеграции ET в RM авторы предлагают два подхода:

🔴 GazeConcat — конкатенировать ET с текстовыми эмбеддингами.
🔴 GazeAdd — добавить ET к текстовым эмбеддингам.

Архитектура фреймворка — на схеме выше. Сначала обучают отдельную модель для предсказания ET и генерируют их фичи. Потом объединяют ET-фичи с текстом, создавая различные типы комбинированных эмбеддингов. В конце — передают в качестве входных данных в RM, которую обучают по стандартной модели Брэдли-Терри.

То есть, традиционный RM с текстовым входом (комбинацией запроса и ответа) дополняют искусственной неявной обратной связью с помощью функций ET, сгенерированных по тому же тексту.

Эксперименты показали: фреймворк GazeReward помог повысить точность прогнозов о предпочтениях людей более чем на 10%. По мнению авторов, это подтверждает потенциал мультимодальных сигналов для NLP.

Разбор подготовил Карим Галлямов

Душный NLP
  • ❤ 10
  • 👍 6
  • 🔥 5
  • 🤔 1
  • 😱 1
Post #224 4.55K
Превращаем decoder-only в encoder-decoder

Несмотря на то, что decoder-only-модели сейчас популярнее, encoder-decoder-модели по-прежнему остаются актуальными в некоторых задачах. В сегодняшней статье — техника адаптации предобученных decoder-only-моделей в encoder-decoder с сохранением преимуществ обоих подходов.

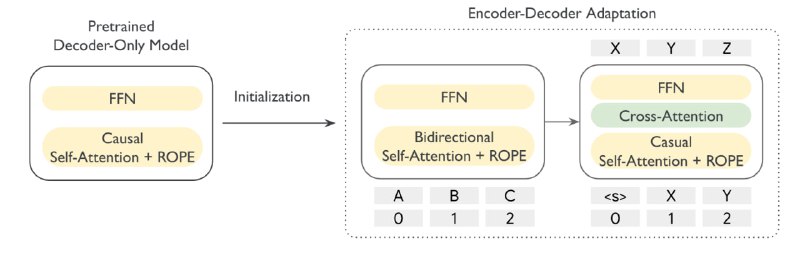
Суть метода: берут предобученную decoder-only и из её весов собирают encoder-decoder. В энкодере self-attention и FFN инициализируются из соответствующих self-attention и FFN исходной модели, но сам self-attention переключают с causal на двунаправленный. В декодере self-attention (он остаётся causal) и FFN тоже берутся из decoder-only (изображение 1).

Новая часть — cross-attention: если энкодер и декодер получены из одного и того же decoder-only-чекпойнта (с одинаковой конфигурацией и весами), то cross-attention инициализируют из SA. В противном случае инициализируется рандомно с дополнительным обучением в начале.

Далее авторы используют два варианта претрейн-обджектива encoder-decoder-моделей — PrefixLM и UL2 — и сравнивают их. Первый предполагает разбивку последовательностей на две равные части: первую половину текста подают в энкодер как префикс, а вторую должен генерировать декодер. Такой подход облегчает имплементацию дистилляции, где исходная decoder-only выступает «учителем». В рамках UL2 модель решает denoising-задачи: часть токенов заменяется на пропуски; в энкодер подаётся текст с пропущенными токенами, а в декодер — сами пропущенные токены. Дистилляция здесь не используется.

Авторы отмечают, что PrefixLM даёт лучшие результаты за счёт дистилляции, но у UL2-моделей оказались лучшие энкодер-представления. В целом, как показывают эксперименты, модели, полученные с помощью адаптации показывают лучшее качество, чем обученные с нуля.

Всё проверяли на Gemma 2 на 2B и 9B параметров. Сбалансированная адаптация — 2B-2B и 9B-9B — выходят на сопоставимое с decoder-only-моделями качество довольно быстро. 9B-2B растёт медленнее из-за нового cross-attention (результаты для итоговых моделей — на изображении 2).

Разбор подготовил ❣ Антон Викторов

Душный NLP
  • 🔥 19
  • ❤ 10
  • ❤‍🔥 4
  • 👍 3
  • 🙏 2
  • ✍ 1
  • 💅 1
Post #221 4.61K
Ускорение E2E-инференса через оптимизацию KV-кэша. Часть II

В первой части разбора мы говорили о методах оптимизации KV-кэша в принципе. А сегодня речь пойдёт об одном конкретном подходе — ShadowKV.

В его основе наблюдение, что post-RoPE key cache обладает attention locality — соседние токены часто имеют высокую cosine similarity, и только небольшая часть токенов выбивается из этого паттерна. Поэтому их режут на чанки по 8 токенов и строят landmarks — репрезентативные средние ключи для чанка. Это значительно ускоряет этап выбора ключей на шаге декодирования, а также улучшает доступ к памяти и позволяет лучше насыщать шину.

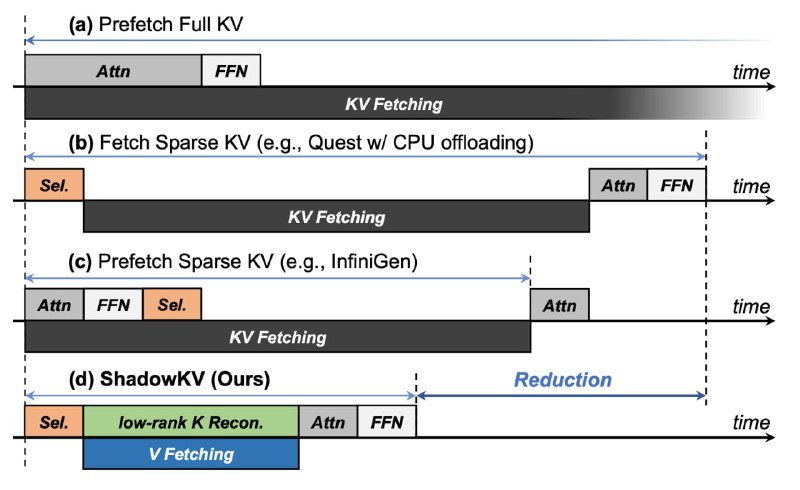
Ключевой момент в том, что лучше всего сжимается именно pre-RoPE K: он хорошо раскладывается в низкий ранг с минимальной ошибкой, заметно лучше, чем V. Поэтому ShadowKV делает так: pre-RoPE K сжимается через SVD, а V не сжимается, а уезжает в CPU (RAM), чтобы экономить GPU память и bandwidth.

При этом небольшое число токенов, которые плохо объясняются landmark’ами, выделяются как outliers (выбросы) и сохраняются полнорангово. В статье отмечают, что значимая доля outliers — это sink tokens. Достаточно порядка 0,049% бюджета на выбросы, чтобы попасть в точку diminishing returns: это минимальное количество outliers, которое почти полностью закрывает деградацию качества, а дальнейшее увеличение бюджета даёт лишь пренебрежимо малый дополнительный вклад.

На этапе prefill пайплайн строится так: параллельно с основным префиллом быстро вычисляются landmarks и outliers, и это вычисление перекрывается с отгрузкой V на CPU. В результате дополнительные шаги минимально увеличивают critical path, потому что большая часть работы делается в overlap-режиме.

Q на decode скорится не по всем токенам, а по landmarks каждого чанка. Затем выбираются лучшие чанки, и уже все токены из выбранных чанков отправляются в kernel attention. Для этого K восстанавливаются обратно из low-rank пространства, а соответствующие V подгружаются из CPU.

Дополнительно используется оптимизация в духе branch prediction или speculative-подходов. Между двумя соседними шагами декодирования выбранный набор токенов обычно меняется незначительно, потому что запросы на соседних шагах похожи. Поэтому можно кэшировать уже подгруженные токены для каждого слоя и на следующем шаге считать разность множеств, догружая только те токены, которых ещё нет в рабочем наборе. Эта оптимизация lossless относительно ShadowKV, потому что сохраняется инвариант: на каждом шаге в аттеншн всё равно попадает актуальный набор токенов — просто часть из них переиспользуется без повторной загрузки.

На бенчмарках деградация остаётся минимальной при бюджете около 1,56% от полного объёма KV. При этом в практических сценариях ShadowKV обеспечивает заметный прирост скорости и позволяет поддерживать существенно больший размер батча — за счёт снижения нагрузки на VRAM и уменьшения стоимости аттеншн на длинных контекстах.

Отдельно важно понимать, почему вообще имеет смысл оптимизировать именно аттеншн. Его вычислительная стоимость растёт с длиной последовательности, и на длинных контекстах он начинает доминировать по времени, тогда как FFN от длины контекста почти не зависит. Поэтому на коротких последовательностях в профиле часто доминирует FFN, и ускорение аттеншена даёт небольшой выигрыш.

Зато на длинных контекстах бутылочным горлышком становится аттеншн, и тогда по закону Амдала даже частичное ускорение этой части даёт заметную экономию общего E2E-времени инференса.

Разбор подготовил❣ Владислав Кругликов

Душный NLP
  • ❤ 16
  • 👍 9
  • 🔥 4
  • 🥱 1
Post #220 5.21K
Ускорение E2E-инференса через оптимизацию KV-кэша. Часть I

Существует много способов ускорить инференс LLM: менять архитектуру, использовать speculative decoding или просто добавлять вычислительные ресурсы. Но есть и более практичный путь — оптимизация KV-кэша.

Её можно разделить на pre-train и post-train. Первые требуют изменений до обучения модели: это архитектурные решения вроде GQA/MQA/MLA, смешивание глобального и локального атеншена, а также другие модификации, которые обычно стоят дорого из-за переобучения.

Post-train-методы можно применять к уже готовой модели: это различные sparse-стратегии, pruning, удаление повторов токенов и другие техники, которые уменьшают объём KV или сокращают число обращений к нему во время инференса.

KV-бюджеты удобно делить на dense и sparse, отдельно для prefill и отдельно для decode. В варианте dense prefill + dense decode (обычный KV-кэш) каждый новый Q взаимодействует со всеми K и V до него: ко всем токенам промпта и всем ранее сгенерированным токенам. Тогда KV-бюджет равен сумме длины промпта и длины генерации.

Если сделать sparse только на prefill, а decode оставить плотным, то Q перестаёт смотреть на весь промпт, но общий выигрыш заметен в основном в сценариях «длинный промпт — короткий ответ». Если же оставить dense prefill и сделать sparse decode, это часто релевантно reasoning/CoT-сценариям. Sparse и на prefill, и на decode даёт максимальную экономию бюджета, но обычно сильнее всего ухудшает качество.

Sparse можно строить по-разному. Если пересчитывать важные токены на каждом шаге decode, то качество станет выше, но скорость падает. Если пересчитывать раз в несколько токенов, то получается быстрее, но нужно удерживать локальный контекст между пересчётами, иначе модель начинает терять связность.

Один из сильных post-train-методов оптимизации KV-кэша — ShadowKV, который позволяет получать минимальные просадки на бенчмарках без дообучения и увеличивает throughput до трёх раз. О нём мы подробно поговорим в следующей части.

Разбор подготовил❣ Владислав Кругликов

Душный NLP
  • 👍 25
  • 🔥 6
  • 👀 5
  • ❤‍🔥 4
  • ❤ 1
  • 🤯 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →