
Превращаем decoder-only в encoder-decoder
Несмотря на то, что decoder-only-модели сейчас популярнее, encoder-decoder-модели по-прежнему остаются актуальными в некоторых задачах. В сегодняшней статье — техника адаптации предобученных decoder-only-моделей в encoder-decoder с сохранением преимуществ обоих подходов.
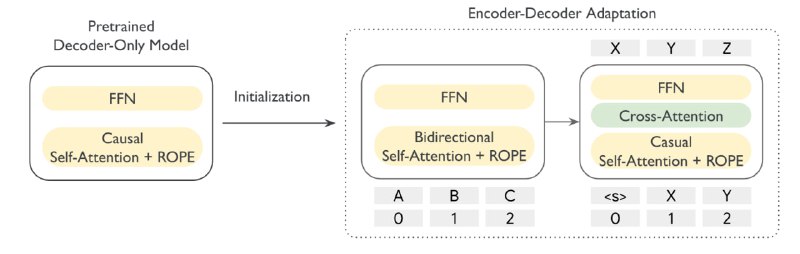
Суть метода: берут предобученную decoder-only и из её весов собирают encoder-decoder. В энкодере self-attention и FFN инициализируются из соответствующих self-attention и FFN исходной модели, но сам self-attention переключают с causal на двунаправленный. В декодере self-attention (он остаётся causal) и FFN тоже берутся из decoder-only (изображение 1).
Новая часть — cross-attention: если энкодер и декодер получены из одного и того же decoder-only-чекпойнта (с одинаковой конфигурацией и весами), то cross-attention инициализируют из SA. В противном случае инициализируется рандомно с дополнительным обучением в начале.
Далее авторы используют два варианта претрейн-обджектива encoder-decoder-моделей — PrefixLM и UL2 — и сравнивают их. Первый предполагает разбивку последовательностей на две равные части: первую половину текста подают в энкодер как префикс, а вторую должен генерировать декодер. Такой подход облегчает имплементацию дистилляции, где исходная decoder-only выступает «учителем». В рамках UL2 модель решает denoising-задачи: часть токенов заменяется на пропуски; в энкодер подаётся текст с пропущенными токенами, а в декодер — сами пропущенные токены. Дистилляция здесь не используется.
Авторы отмечают, что PrefixLM даёт лучшие результаты за счёт дистилляции, но у UL2-моделей оказались лучшие энкодер-представления. В целом, как показывают эксперименты, модели, полученные с помощью адаптации показывают лучшее качество, чем обученные с нуля.
Всё проверяли на Gemma 2 на 2B и 9B параметров. Сбалансированная адаптация — 2B-2B и 9B-9B — выходят на сопоставимое с decoder-only-моделями качество довольно быстро. 9B-2B растёт медленнее из-за нового cross-attention (результаты для итоговых моделей — на изображении 2).
Разбор подготовил ❣ Антон Викторов
Душный NLP
Post #224
4.55K

- 🔥 19
- ❤ 10
- ❤🔥 4
- 👍 3
- 🙏 2
- ✍ 1
- 💅 1