
Я не так давно рассказывал про очень простую и наглядную интерпретацию метрики LA (Load Average). Данную тему будет уместно дополнить более современными метриками – PSI (Pressure Stall Information). Это подсистема ядра Linux, которая отслеживает три наиболее важных ресурса:
▪️CPU
▪️Memory
▪️I/O
В отличие от LA, которая показывает очередь процессов, ожидающих выполнение, PSI измеряет время ожидания процессов при получении доступа к ресурсам, что даёт более точное представление о загрузке системы в режиме реального времени. Плюсом, PSI интегрирована в cgroups, что позволяет мониторить нагрузку отдельных служб и контейнеров.
PSI имеет 3 периода измерений: avg10, avg60, avg300. Это время в секундах, то есть 10 секунд, 1 минута и 5 минут. К периодам прилагаются два типа метрик:
🔹some - процент времени, когда хотя бы один процесс ждёт освобождение ресурсов (line indicates the share of time in which at least some tasks are stalled on a given resource)
🔹full - процент времени, когда все активные процессы находятся в ожидании освобождения ресурсов (line indicates the share of time in which all non-idle tasks are stalled on a given resource simultaneously)
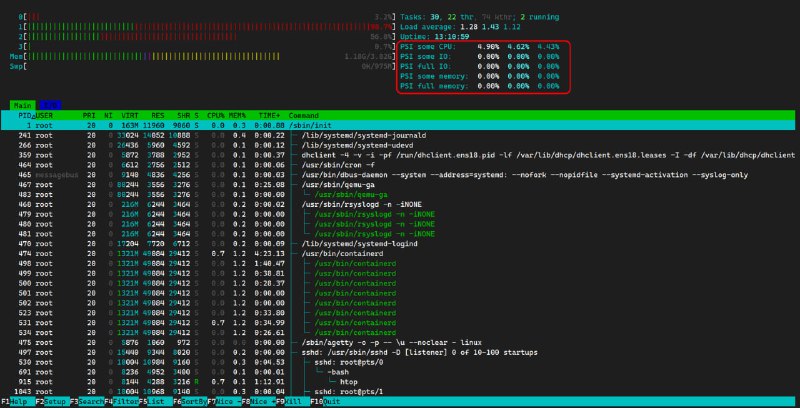
Эти метрики можно и нужно использовать в повседневной работе, наравне с привычными LA, disk r/w, iops. В версии htop, начиная с 3.0.0, можно включить их отображение. По умолчанию они не отображаются. Включаются так:
Открываем htop ⇨ F2 ⇨ Meters ⇨ Aviable Meters ⇨ Выбираем нужные метрики, нажатием Enter ⇨ F10 выйти с сохранением.
В недавнем обновлении Proxmox эти метрики появились на стандартном дашборде.
PSI активно используется в systemd-oomd – современной замене OOM Killer. А точнее помощнике. На основе метрик PSI он более избирательно останавливает процессы, а не ждёт, как OOM Killer, когда закончится память, чтобы прибить самого жирного потребителя при прочих равных условиях.
На практике метрики PSI могут быстро помочь определить узкое место в системе. Например, у вас начала тормозить СУБД. Заходите на сервер и видите высокий LA. Но сама по себе эта метрика не даёт никакой конкретики. Может быть чрезмерно нагружен как процессор, так и диск. Рядом метрики cpu some и io some сразу ответят на вопрос, где у вас узкое место. Если оно реально в CPU, то не придётся лезть в дисковую подсистему и смотреть, что там происходит.
Изменение метрик в режиме реального времени позволяют сразу же оценить какие-то свои изменения и посмотреть, как они повлияли на нагрузку. В общем, это полезные метрики, которые имеет смысл по умолчанию выводить в htop. Не знаю, есть ли они в обычном top. Я на все свои сервера без исключения ставлю htop. Очень к нему привык. Там и PSI, и вкладка I/O с активностью диска, и lsof для просмотра открытых файлов, и strace. В общем, очень удобно.
❗️Если заметка вам полезна, не забудьте 👍 и забрать в закладки.
#linux #perfomance
Post #4951
10.4K
- 👍 147
- 👎 2