
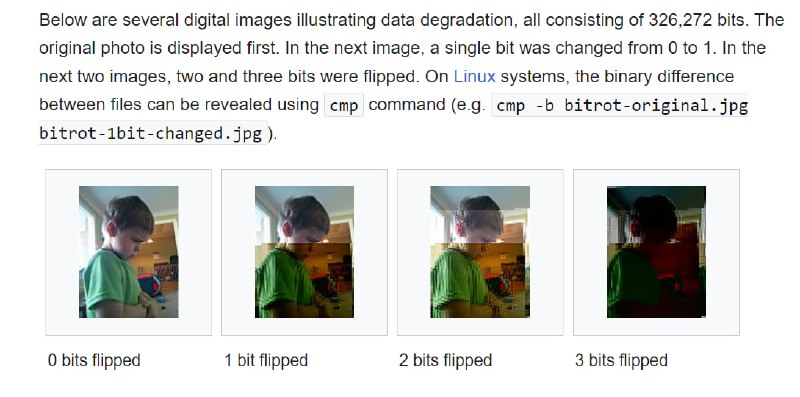
В недавнем цикле статей по LVM в комментариях всплывали вопросы так называемого Bit Rot или битового гниения. Это когда на носитель записан бит 1 или 0, а со временем по разным причинам он поменял своё значение. В конечном счёте эти изменения ведут к тому, что нужный файл хоть и нормально прочитается, но окажется "битым". Причём подвержены этим ошибкам все типы устройств хранения - от лент и CD до современных SSD. Я проверял свои старые записанные CD диски. Многие из них хоть и прочитались, но часть данных была безвозвратно утеряна или повреждена.
Защита от этого явления начинается с того, что данные у вас должны храниться в нескольких экземплярах. Если экземпляр один, то даже если вы узнаете о том, что файл побился, вам это никак не поможет.
Проще всего следить за целостностью файлов с помощью подсчёта контрольных сумм по тем или иным алгоритмам (CRC, MD5, SHA1 и т.д.) Есть много бесплатного софта, который автоматически может это выполнять и сравнивать по расписанию. В Linux такой софт обычно используется для контроля за системными файлами, чтобы определять несанкционированное изменение. Пример - Afick, Tripwire. Если у вас лежат файлы, с ними никто не работает, но изменилась контрольная сумма, значит возникли проблемы. Необходимо то же самое проверить на другом хранилище этих же файлов и если там контрольная сумма не менялась, значит тот файл оригинальный и стоит его восстановить из этой копии.
Некоторые файловые системы выполняют такие проверки в автоматическом режиме. Это заложено в их архитектуру. Пример - ZFS, Btrfs, ReiserFS, Ceph. Все эти файловые системы могут не только контролировать изменения, но и выполнять автоматическое восстановление повреждённых файлов, если хранилища на их основе собраны с избыточностью данных. То есть каждый файл хранится как минимум в двух или более копиях, для каждой из которых посчитана и сохранена контрольная сумма.
Важно понимать, что подобный контроль - не бесплатная операция. Она занимает системные ресурсы, как процессора, так и диска. И чем больше нагрузка на диск, тем больше ресурсов нужно. Перечисленные выше ФС обладают не только функциональностью контроля хэшей, но и многими другими, которые не обязательно будут нужны, но ресурсы они потребляют. Плюс, в них могут быть свои ошибки с вероятностью возникновения выше, чем Bit Rot. И стоит не забывать, что даже если вы возьмёте хранилище с ZFS или Ceph с контролем целостности файлов, это не освобождает вас от хранения этих же файлов где-то ещё.
Есть и другой механизм защиты файлов в Linux на основе контроля целостности - DM-integrity. С его помощью можно блочное устройство превратить в устройство с контролем целостности. А дальше с ним можно работать как с обычным диском - создавать разделы, тома Mdadm или Lvm. В случае нарушения целостности файла такое устройство будет возвращать Input/output error. Mdadm или LVM будут пытаться автоматически восстановить файл из копии, если хранилище обладает избыточностью данных, то есть собран рейд соответствующего уровня.
Таким образом мне не понятны претензии к Mdadm, Lvm или обычным файловым системам типа Ext4 или Xfs. Следить за целостностью файлов - не их задача. Где-то это будет слишком накладно, а где-то вообще не нужно. Если вам это необходимо, возьмите отдельный инструмент. В основном это актуально для долговременных хранилищ с холодными архивами.
☝️ Самая надёжная защита от Bit Rot - множественные копии. И тут очень важно соблюдать один принцип. Делать копию надо не от копии, а от оригинала данных. У вас есть исходное хранилище с данными, где они регулярно меняются. С него вы снимаете первый бэкап. Второй бэкап для другого хранилища надо снимать не с первого бэкапа, а тоже с исходного сервера. Иначе вы на все зависимые сервера принесёте битые файлы с первого бэкапа.
❓Для меня остался открытым другой вопрос. А как вообще понять, что у нас в хранилище файлы исправны, откроются и прочитаются? Как проверить изначальный источник правды для всех остальных копий?
#backup
Post #4200
10.7K
- 👍 111
- 👎 5