TGViewer
Channel Public Channel
SQL Portal | Базы Данных

SQL Portal | Базы Данных

@sqlportal

Присоединяйтесь к нашему каналу и погрузитесь в мир баз данных

Связь: @devmangx

РКН: https://clck.ru/3H4Wo3
Subscribers
13.7K
Photos
1.1K
Videos
142
Links
810

Showing posts older than #1846 · Back to latest

Older Posts 17 shown
Post #1845 1.53K
Два data engineer-а спроектировали один и тот же warehouse.

Design A

- SQL
- ETL
- Star Schema
- Data Warehouse

Design B

- Spark
- Data Lakehouse
- Medallion Architecture
- Real-Time Analytics

Какой дизайн согласуют?

A. Design A
B. Design B

Подвох: в компании всего 50 сотрудников.

Защити свой ответ.

👉 @SQLPortal
Post #1844 1.35K
Некоторые люди — как Kafka.
Постоянно что-то стримят, никогда не останавливаются.

Некоторые — как DuckDB.
Их недооценивают, пока они не начинают работать на безумной скорости.

Некоторые — как Airflow.
Тихо координируют всё происходящее за кулисами.

Некоторые — как Apache Iceberg.
Долго раскачиваются, зато рассчитаны на долгую дистанцию.

Дата твоего рождения покажет, кто ты на самом деле.

Ищи себя ниже 👇
  • 👍 1
Post #1843 1.26K
Сегодня ковырялся в Stored Procedures в SQL.

По сути, Stored Procedure — это сохранённый набор SQL-инструкций внутри базы данных. Написал один раз, потом вызываешь сколько угодно раз.

Сегодня разобрал три вещи:
• IF / ELSE
• Обработку ошибок
• Нормальный стиль написания процедур

1. IF / ELSE
Stored Procedures умеют принимать решения.
Логика такая же, как в обычном коде:

IF условие
выполнить действие
ELSE
выполнить другое действие


Например, проверить, сдал студент экзамен или нет:
IF @Score >= 50
PRINT 'You passed!';
ELSE
PRINT 'You failed.';


Точно так же можно проверять:
право голоса по возрасту;
наличие товара на складе;
скидки для клиентов;
права администратора;
любые бизнес-правила.

Теперь стало понятно, что IF ELSE — это основной способ управлять логикой внутри процедуры.

2. Обработка ошибок

Рано или поздно что-то ломается:
деление на ноль;
дубликаты данных;
обновление несуществующих записей;
ошибки во время денежных переводов.

Для таких случаев в SQL Server есть:
BEGIN TRY
-- основной код
END TRY
BEGIN CATCH
-- обработка ошибки
END CATCH


Пример:
BEGIN TRY
SELECT @Number1 / @Number2;
END TRY
BEGIN CATCH
PRINT 'Division by zero.';
END CATCH


Полезная штука:
ERROR_MESSAGE()


Позволяет получить текст реальной ошибки:
PRINT ERROR_MESSAGE();


Ещё посмотрел на транзакции.

Идея простая:
либо выполняются все операции, либо не выполняется ни одна.


Для денежных переводов это критично.
Если одна из операций упала:

ROLLBACK TRANSACTION;


База откатит изменения и не останется в промежуточном состоянии.

3. Стиль написания Stored Procedures

SQL быстро превращается в кашу, если писать как попало.

Плохой вариант:
create procedure getstudents as begin select * from students end


Нормальный вариант:
CREATE PROCEDURE GetStudents
AS
BEGIN
SELECT *
FROM Students;
END;


Что стоит соблюдать:
понятные названия процедур;
понятные названия параметров;

SQL-ключевые слова в верхнем регистре;
отступы;

комментарии только там, где они реально нужны;
аккуратная структура кода.

Ещё узнал про:
SET NOCOUNT ON;


Эта команда отключает лишние сообщения вида:
(1 row affected)


Мелочь, но в рабочих процедурах её почти всегда добавляют.

Маленькая тема, но без неё сложно писать серьёзные процедуры и автоматизировать работу с данными.

👉 @SQLPortal
  • 👍 6
  • ❤ 2
Post #1842 1.26K
Oracle AI Database 23.26.1 получила поддержку partition by expression.
Теперь секционировать таблицы можно прямо по выражению, а не только по отдельному столбцу.

Например, можно автоматически раскладывать записи по доменам верхнего уровня из email:
PARTITION BY LIST (
REGEXP_SUBSTR(email_address, '[^.]+$')
)


То есть .com, .org, .net и другие TLD будут попадать в свои партиции без создания отдельного вычисляемого столбца.
Небольшая фича, которая убирает лишний слой костылей в схемах БД.
Демонстрация от Dani Schnider -https://danischnider.wordpress.com/2026/05/22/partition-by-expression/

👉 @SQLPortal
Data Warehousing with Oracle Partition by Expression In the latest version of the Oracle database, it is now possible to define the partition key of a partitioned table using an expression. This was already possible previously, but only with a small …
  • 👍 1
  • 🤔 1
Post #1841 1.41K
Нумеровать строки в SQL можно по-разному

ROW_NUMBER() — уникальный порядковый номер для каждой строки
DENSE_RANK() — одинаковый ранг для одинаковых значений, без пропусков в нумерации
RANK() — одинаковый ранг для одинаковых значений, после совпадений появляются пропуски

Пример:
score
-----
100
100
90
80


ROW_NUMBER()

1
2
3
4


DENSE_RANK()

1
1
2
3


RANK()

1
1
3
4


Джесс Рамос показывает разницу между этими функциями на практике и разбирает типичные сценарии их использования.

👉 @SQLPortal
YouTube Master SQL Window Functions: ROW_NUMBER, RANK, and DENSE_RANK ⚡Free 5-Day Data Career Kickstart https://www.bigdataenergycourses.com/kickstart If you're preparing for a data interview, you need to know the difference between ROW_NUMBER, RANK, and DENSE_RANK — and you need to be able to explain it confidently. In this…
  • 👍 6
Post #1840 1.48K
В PostgreSQL 19 Beta 1 завезли ON CONFLICT DO SELECT.
Теперь можно попытаться вставить запись, а если она уже есть — сразу получить существующую.
Похоже, атомарный get-or-create наконец добрался до PostgreSQL.
#PostgreSQL #SQL

👉 @SQLPortal
  • ❤ 7
Post #1839 1.55K
10 SQL-проверок качества данных, которые стоит внедрить в любом проекте

👉 @SQLPortal
  • 👍 4
Post #1838 1.54K
Вышел Extend UI — open-source набор компонентов для документных агентов.

Что внутри:

✓ 14 готовых компонентов и примеров
✓ Просмотр PDF, DOCX и XLSX
✓ Bounding box citations
✓ Загрузка файлов
✓ Электронная подпись
✓ Полная кастомизация
✓ MIT-лицензия

Команда перепробовала десятки просмотрщиков документов и UI-библиотек, но ни одна не закрывала все их требования по функциональности и UX.

В итоге они собрали собственное решение для Extend.

Изначально проект был внутренним инструментом, но после многочисленных запросов клиентов его решили открыть для сообщества.

Подойдёт для агентных систем, пользовательских документных сценариев и внутренних корпоративных инструментов.

Бонус: компонентами уже ежедневно пользуются на миллионах страниц документов внутри Extend, так что проект успел пройти хорошую проверку в продакшене.

👉 @SQLPortal
Post #1837 1.23K
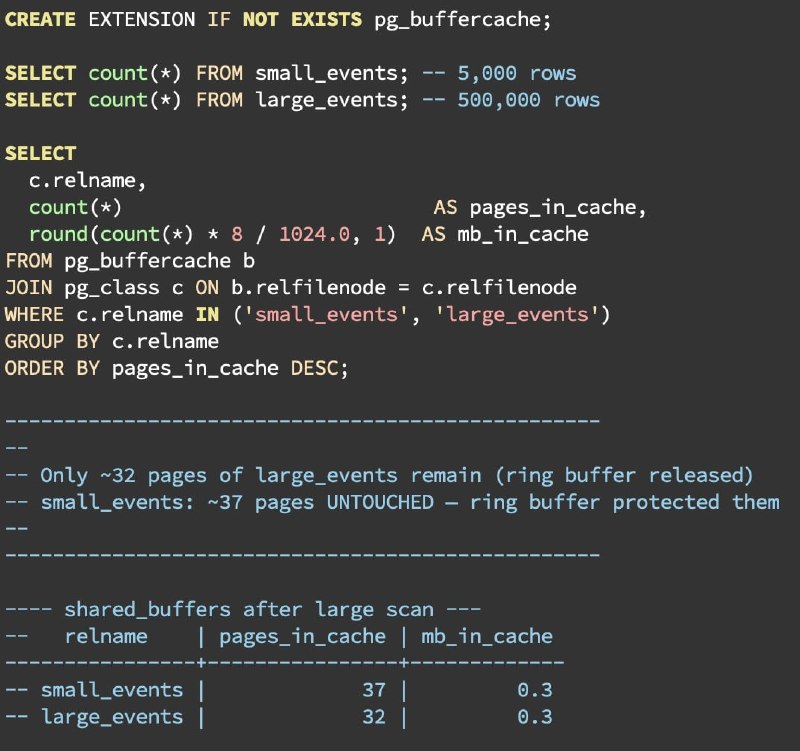
PostgreSQL защищает «горячие» данные от вытеснения во время больших последовательных сканирований с помощью Sequential Scan Ring Buffer.

В этом посте посмотрим, сколько раз можно употребить термин shared_buffers... поехали.
Без Sequential Scan Ring Buffer один запрос вида SELECT * FROM large_table загрузил бы все страницы большой таблицы в shared_buffers, вытеснив всё, что уже находилось в кеше. Один «холодный» аналитический запрос мог бы полностью разрушить рабочий набор данных всех остальных сессий.

Что такое ring buffer?
Когда PostgreSQL обнаруживает большое последовательное сканирование, он переключается на стратегию ring buffer: временное циклическое окно, выделенное внутри shared_buffers.

По мере выполнения сканирования страницы проходят через этот буфер по кругу и сразу становятся кандидатами на вытеснение после использования. Благодаря этому основной кеш остаётся изолированным.

Размер ring buffer зависит от типа операции:

Большие последовательные сканирования — базовый размер составляет 32 страницы (256 КБ), но в PostgreSQL 17+ может немного увеличиваться для асинхронного ввода-вывода.
VACUUM — по умолчанию 256 страниц (2 МБ), начиная с PostgreSQL 16. Настраивается через vacuum_buffer_usage_limit.
COPY и другие операции массовой записи — 2048 страниц (16 МБ).

Срабатывает при 25% от shared_buffers
Порог рассчитывается как: shared_buffers / 4
Если размер сканируемой таблицы превышает четверть shared_buffers, PostgreSQL использует стратегию ring buffer.
Для операций обслуживания действуют отдельные правила. Размер ring buffer для VACUUM задаётся параметром vacuum_buffer_usage_limit, но PostgreSQL автоматически ограничивает этот буфер значением не более 1/8 от размера shared_buffers.

Что это означает на практике. Данные приложения защищены от вытеснения большими сканированиями. Если рабочий набор помещается в shared_buffers, он останется в кеше даже при запуске крупного последовательного сканирования.
Результаты последовательного сканирования таблиц, размер которых превышает shared_buffers, не будут сохраняться в кеше PostgreSQL. При этом повторные чтения всё ещё могут обслуживаться из page cache операционной системы без обращения к физическому диску.

Каждый параллельный воркер, выполняющий последовательное сканирование, использует собственный ring buffer. Это увеличивает пропускную способность больших сканирований и одновременно защищает основной пул буферов.
Таблицы, размер которых находится чуть ниже порога в 25% от shared_buffers, всё ещё могут вызывать вытеснение данных из кеша.

👉 @SQLPortal
  • ❤ 3
Post #1836 1.2K
VIEW (представления)

🧠 Что такое VIEW?

VIEW — это виртуальная таблица, построенная на основе SQL-запроса.
Данные в ней не хранятся
Хранится только запрос
Проще говоря:
VIEW = сохранённый SQL-запрос, который можно использовать как таблицу


Зачем нужны VIEW?
- упрощают сложные запросы
- позволяют переиспользовать логику
- помогают скрывать чувствительные данные
- делают SQL-код понятнее

Создание VIEW
CREATE VIEW high_salary_emp AS
SELECT name, salary
FROM employees
WHERE salary > 50000;


Использование VIEW
SELECT * FROM high_salary_emp;


Работает почти так же, как обычная таблица.

Обновление VIEW
CREATE OR REPLACE VIEW high_salary_emp AS
SELECT name, salary, department
FROM employees
WHERE salary > 50000;


Удаление VIEW
DROP VIEW high_salary_emp;


Практический пример
Создадим представление со средней зарплатой по отделам:
CREATE VIEW dept_avg_salary AS
SELECT department, AVG(salary) AS avg_salary
FROM employees
GROUP BY department;


Использование:
SELECT * FROM dept_avg_salary;


Важные моменты
VIEW не хранит данные
изменения в исходной таблице сразу отражаются в VIEW
VIEW можно использовать в запросах как обычную таблицу

Практика
Создайте VIEW для сотрудников с зарплатой выше 40 000
Создайте VIEW для сотрудников отдела IT
Создайте VIEW со средней зарплатой по отделам
Выполните запросы к созданным VIEW
Удалите одно из представлений

Решения
1. Сотрудники с зарплатой выше 40 000
CREATE VIEW high_salary_emp AS
SELECT *
FROM employees
WHERE salary > 40000;


2. Сотрудники отдела IT

CREATE VIEW it_employees AS
SELECT *
FROM employees
WHERE department = 'IT';


3. Средняя зарплата по отделам

CREATE VIEW dept_avg_salary AS
SELECT department, AVG(salary) AS avg_salary
FROM employees
GROUP BY department;


4. Запросы к представлениям

SELECT * FROM high_salary_emp;

SELECT * FROM it_employees;

SELECT * FROM dept_avg_salary;

5. Удаление представления
DROP VIEW high_salary_emp;


Мини-задача
Создайте VIEW, который показывает 3 сотрудников с самой высокой зарплатой.

Решение
CREATE VIEW top_3_salary AS
SELECT *
FROM employees
ORDER BY salary DESC
LIMIT 3;

Использование:
SELECT * FROM top_3_salary;


Где VIEW используют чаще всего?
- дашборды
- системы отчётности
- аналитические проекты

Потому что представления позволяют скрыть сложную SQL-логику за простым запросом.
Таблица хранит данные.
VIEW хранит запрос.


👉 @SQLPortal
  • ❤ 2
Post #1833 1.54K
«Но ведь запрос был быстрым на dev и staging!»

Какие признаки говорят о том, что запрос работает быстро локально, но в production потребует отдельного внимания к производительности?

Есть две точки, после которых простой запрос начинает заметно замедляться:

Сортировка перестаёт помещаться в память.
Сканирование таблицы начинает читать данные с диска.

Примеры ниже показаны на небольших стендах с ограниченными ресурсами. В крупных системах картина будет такой же, только с гораздо большим количеством строк.
Простой запрос:
SELECT user_id, event_type, created_at
FROM events
WHERE user_id = 1
ORDER BY created_at DESC


Без индекса PostgreSQL приходится сканировать всю таблицу, чтобы найти события пользователя, даже если нужных строк совсем немного.

(Небольшая оговорка: если для пользователя нет ни одной строки, PostgreSQL может решить вообще не сканировать таблицу, используя статистику по таблице и колонкам.)

Фаза 1. Всё помещается в память

Таблица содержит 10 000 строк.
Для user_id = 1 найдено 5 000 событий.
work_mem = 1MB.

Что видно ((фото1):

Sort Method: quicksort Memory: 427kB
Все 5 000 строк были отсортированы прямо в RAM.
Rows Removed by Filter: 5000
PostgreSQL всё равно прочитал остальные 5 000 строк и отбросил их.
Buffers: shared hit=74
Все страницы уже находились в памяти (shared_buffers).

Фаза 2. Сортировка начинает писать на диск

Теперь в таблице 200 000 строк.
У пользователя уже 100 000 событий.
work_mem всё ещё равен 1 MB.

Что изменилось (2):

Sort Method: external merge Disk: 3352kB
Сортировка больше не помещается в память и начинает использовать временные файлы.
temp read=836 written=843
PostgreSQL записал 843 временные страницы на диск и затем прочитал их обратно во время merge-фазы.
Rows Removed by Filter: 100000
Ещё 100 тысяч строк были прочитаны только для того, чтобы потом их выбросить.

Фаза 3. Таблица перестаёт помещаться в буферный кеш

Всего уже 600 000 строк.
Из них 100 000 принадлежат нужному пользователю, остальные 500 000 — другим пользователям.
PostgreSQL всё равно вынужден читать их.
Размер таблицы становится больше shared_buffers.

(3 фото)

Планировщик запустил 2 параллельных воркера.
Сканирование и сортировка были распределены между 3 процессами, поэтому каждый сортировал примерно по 33 000 строк вместо 100 000.

Но основные проблемы остались:

shared read=3049
Таблица перестала помещаться в буферный кеш. Более 3 000 страниц пришлось читать с диска.
Rows Removed by Filter: 166667 × 3
Было прочитано и выброшено около 500 тысяч строк.
Все три сортировки всё равно использовали external merge
Параллелизм уменьшил объём работы на каждый процесс, но не убрал запись на диск.

Решение зависит от конкретного приложения.
Самый очевидный вариант:
CREATE INDEX idx_events_user_created_at
ON events (user_id, created_at DESC);


Такой индекс позволяет резко сократить объём сортировки и избежать полного сканирования таблицы.
Но индекс далеко не единственный вариант.
В зависимости от нагрузки могут помочь:
- кэширование на уровне приложения;
- materialized views;
- партиционирование таблиц;
- изменение модели хранения данных.

Главный вывод простой:

Если в EXPLAIN ANALYZE появляются:
external merge
temp read / temp written
большие значения Rows Removed by Filter
shared read

то запрос, который отлично работал на dev-базе с 10 тысячами строк, уже начинает показывать, что будет происходить в production на миллионах записей.

👉 @SQLPortal
  • 👍 3
  • ❤ 1
Post #1831 1.3K
Появился /no-mistakes.

По многочисленным просьбам автор вынес один из самых полезных инструментов своего агентного пайплайна в отдельный skill для Claude Code, Codex и других агентных сред.
После того как агент внёс изменения, достаточно выполнить: /no-mistakes

Дальше инструмент автоматически проверит изменения и поможет найти проблемы до коммита.
По словам автора, код, сгенерированный ИИ, даже лучшими моделями, пока нельзя безоговорочно принимать и мержить без тщательной проверки.

Его собственная статистика:
68% изменений содержали проблемы
эти проблемы могли попасть в основную ветку, если бы их не обнаружил no-mistakes

Раньше инструмент запускался только через:
git push no-mistakes

Теперь доступен и как skill.
Исходный код открыт и распространяется бесплатно: https://github.com/kunchenguid/no-mistakes

Для настройки в репозитории:
no-mistakes init

👉 @SQLPortal
  • 😁 1
Post #1830 1.29K
Начиная с Oracle 21c, массивы PL/SQL можно инициализировать через конструкторы с циклом FOR.

array := arr_type ( FOR i IN ... )


Такие конструкторы позволяют перебирать:
значения — IN x .. y
результат курсора — IN ( SELECT ... )
Для задания собственных индексов можно использовать необязательное выражение INDEX.

👉 @SQLPortal
  • 👍 2
Post #1819 1.33K
Новый бесплатный курс от Anthropic!

Agent Skills: пошагово и с нуля
✓ Создание навыков (Skills) и лучшие практики
✓ Отличия от Tools и MCP
✓ Для Claude Code и Visual Studio Code
2 часа контента и 10 видеоуроков

→ deeplearning.ai/short-courses/agent-skills-with-anthropic/

👉 @SQLPortal
www.deeplearning.ai Agent Skills with Anthropic Equip agents with expert on-demand knowledge to enable reliable coding, research, and data analysis workflows
Post #1818 1.25K
Тебе точно понравится:

Этот инструмент, который преобразует запросы на естественном языке в SQL-запросы

То есть пишешь ему, например:
все книги которые взяли студенты 2 курса за последнюю неделю

И он вам выдаёт SELECT * FROM ... и тд.

Очень удобный инструмент для тех, кто не знаком с SQL, но нуждается в работе с базами данных, пользуйтесь 📸

⛓ Ознакомиться: тут

👉 @SQLPortal
GitHub GitHub - shurutech/mql: MQL tool is designed to generate SQL queries directly from natural language inputs. MQL tool is designed to generate SQL queries directly from natural language inputs. - shurutech/mql
  • ❤ 1
Post #1817 1.16K
Чем больше пользуюсь Claude Code, тем сильнее кажется, что главный навык теперь не кодинг.

А управление агентами.

У некоторых workflow выглядит примерно так:

Одна задача автоматически разбивается между несколькими агентами.

• один накидывает идеи
• один пишет технический план
• один кодит
• один делает ревью
• один ищет проблемы и пропущенные кейсы

Всё складывается в markdown, чтобы не потерять контекст.

Да, получается медленнее.

Да, приходится ждать.

Но качество обычно выше, потому что каждый агент делает только одну работу.

А настоящий буст начинается с Git Worktrees.

Вместо одной сессии Claude Code можно держать несколько параллельных.

Одна пилит новую фичу.

Вторая разбирается с багом.

Третья пишет тесты.

Четвёртая занимается рефакторингом.

В итоге начинаешь думать не в стиле «как написать этот код», а в стиле «как распределить работу между агентами и не потерять контроль над результатом».

Похоже, это и есть новый engineering skill.

👉 @SQLPortal
  • 🔥 3
Post #1816 1.01K
Любимый паттерн для “последняя запись на группу” в Postgres — DISTINCT ON.
Да, он Postgres-specific. Нет, он не из SQL Standard. Зато для этой задачи он читается почти идеально.

Есть таблица заказов:
CREATE TABLE orders (
id bigint PRIMARY KEY,
customer_id int,
status text,
created_at timestamptz
);


Старый классический вариант:
SELECT o.*
FROM orders o
INNER JOIN (
SELECT customer_id, MAX(created_at) AS latest
FROM orders
GROUP BY customer_id
) latest ON o.customer_id = latest.customer_id
AND o.created_at = latest.latest;


Работает, но есть нюансы.
Таблица читается два раза: сначала ищем MAX(created_at) по каждому customer_id, потом джойнимся обратно за полной строкой.

И ещё хуже: если у одного клиента два заказа с одинаковым created_at, запрос может вернуть две строки. Нужен tie-breaker.

В Postgres проще так:
SELECT DISTINCT ON (customer_id)
customer_id, status, created_at
FROM orders
ORDER BY customer_id, created_at DESC;


DISTINCT ON (customer_id)
оставляет первую строку для каждого клиента после сортировки.
То есть ORDER BY customer_id, created_at DESC сначала кладёт свежий заказ клиента наверх, а DISTINCT ON забирает его.

Чтобы это реально летало, добавляем индекс:
CREATE INDEX ON orders (customer_id, created_at DESC);


Теперь Postgres может идти по уже отсортированному индексу и не делать отдельную сортировку.
На небольшом тесте с 100k строк и 20k customer_id получилось так:
Без индекса:
• MAX + self-join: 32.92ms
• DISTINCT ON: 34.75ms
• ROW_NUMBER(): 38.68ms
С индексом (customer_id, created_at DESC):
• DISTINCT ON: 15.99ms
• ROW_NUMBER(): 25.36ms
• MAX + self-join: 38.01ms

Главный вывод: для “одна последняя строка на группу” в Postgres я первым беру DISTINCT ON.
Если нужно не одну строку, а top N строк на группу, тогда уже ROW_NUMBER():
SELECT customer_id, status, created_at
FROM (
SELECT *,
ROW_NUMBER() OVER (
PARTITION BY customer_id
ORDER BY created_at DESC
) AS rn
FROM orders
) ranked
WHERE rn = 1;


DISTINCT ON
— для простого “последний на группу”.
Window functions — когда нужна гибкость.

👉 @SQLPortal
  • ❤ 2
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →