
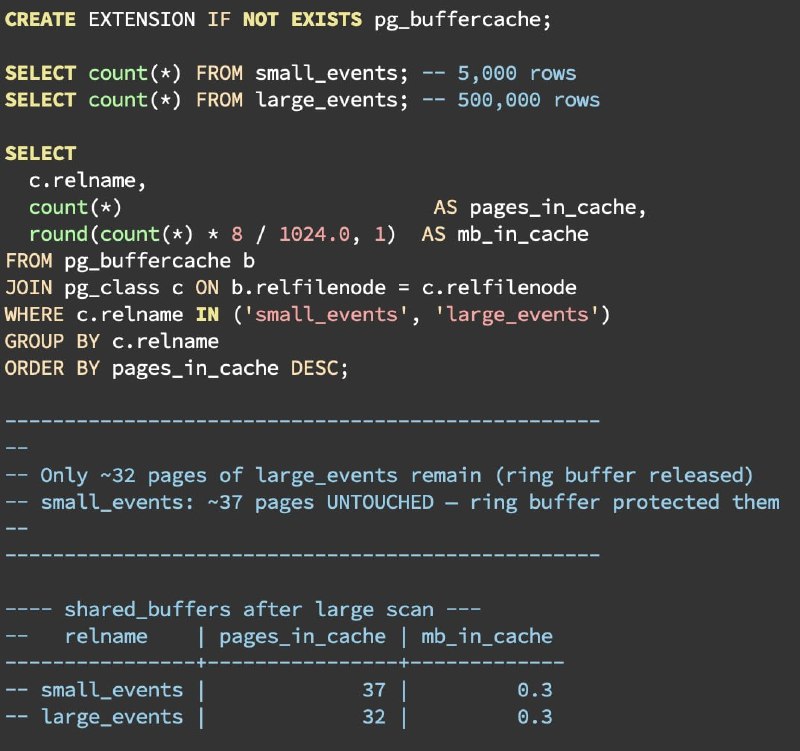
В этом посте посмотрим, сколько раз можно употребить термин
shared_buffers... поехали.Без Sequential Scan Ring Buffer один запрос вида
SELECT * FROM large_table загрузил бы все страницы большой таблицы в shared_buffers, вытеснив всё, что уже находилось в кеше. Один «холодный» аналитический запрос мог бы полностью разрушить рабочий набор данных всех остальных сессий.Что такое ring buffer?
Когда PostgreSQL обнаруживает большое последовательное сканирование, он переключается на стратегию ring buffer: временное циклическое окно, выделенное внутри
shared_buffers.По мере выполнения сканирования страницы проходят через этот буфер по кругу и сразу становятся кандидатами на вытеснение после использования. Благодаря этому основной кеш остаётся изолированным.
Размер ring buffer зависит от типа операции:
Большие последовательные сканирования — базовый размер составляет 32 страницы (256 КБ), но в PostgreSQL 17+ может немного увеличиваться для асинхронного ввода-вывода.
VACUUM — по умолчанию 256 страниц (2 МБ), начиная с PostgreSQL 16. Настраивается через
vacuum_buffer_usage_limit.COPY и другие операции массовой записи — 2048 страниц (16 МБ).
Срабатывает при 25% от
shared_buffersПорог рассчитывается как:
shared_buffers / 4Если размер сканируемой таблицы превышает четверть
shared_buffers, PostgreSQL использует стратегию ring buffer.Для операций обслуживания действуют отдельные правила. Размер ring buffer для VACUUM задаётся параметром
vacuum_buffer_usage_limit, но PostgreSQL автоматически ограничивает этот буфер значением не более 1/8 от размера shared_buffers.Что это означает на практике. Данные приложения защищены от вытеснения большими сканированиями. Если рабочий набор помещается в
shared_buffers, он останется в кеше даже при запуске крупного последовательного сканирования.Результаты последовательного сканирования таблиц, размер которых превышает
shared_buffers, не будут сохраняться в кеше PostgreSQL. При этом повторные чтения всё ещё могут обслуживаться из page cache операционной системы без обращения к физическому диску.Каждый параллельный воркер, выполняющий последовательное сканирование, использует собственный ring buffer. Это увеличивает пропускную способность больших сканирований и одновременно защищает основной пул буферов.
Таблицы, размер которых находится чуть ниже порога в 25% от
shared_buffers, всё ещё могут вызывать вытеснение данных из кеша.👉 @SQLPortal