TGViewer
Channel Public Channel
SQL Portal | Базы Данных

SQL Portal | Базы Данных

@sqlportal

Присоединяйтесь к нашему каналу и погрузитесь в мир баз данных

Связь: @devmangx

РКН: https://clck.ru/3H4Wo3
Subscribers
13.8K
Photos
1.1K
Videos
142
Links
810

Showing posts older than #1634 · Back to latest

Older Posts 20 shown
Post #1633 1.83K
Вам нужно выполнить запрос по иерархии? Рекурсивные CTE могут быть очень полезны. Они начинают с якорной точки (anchor point) и проходят через CTE до конца.

Рекурсивный CTE состоит из двух частей:

1/ Якорный запрос (Anchor Query) — это верхний уровень / начальная точка.

2/ Рекурсивный запрос (Recursive Query) — он ссылается на CTE и продолжает выполняться, пока не будет выполнено условие остановки.

Рекурсивный запрос будет продолжать вызывать сам себя, пока больше не будут возвращаться строки.

WITH RECURSIVE EmployeeHierarchy AS (
-- Якорь / начальная точка
SELECT id, name, manager_id, 1 AS level
FROM employees
WHERE id = 1

UNION ALL

-- Рекурсивный случай: найти элементы, которые относятся к предыдущему уровню
SELECT e.id, e.name, e.manager_id, eh.level + 1
FROM employees e
INNER JOIN EmployeeHierarchy eh ON e.manager_id = eh.id
)

SELECT * FROM EmployeeHierarchy;


👉 @SQLPortal
  • 👍 6
Post #1631 1.83K
Представили pg_duckpipe: CDC в реальном времени для вашего Lakehouse

TL;DR:
pg_duckpipe — это новое расширение для PostgreSQL, которое непрерывно синхронизирует обычные heap-таблицы с колонночными таблицами в DuckLake, используя CDC на основе WAL.

Чтобы запустить синхронизацию, достаточно одного SQL-вызова — без внешней инфраструктуры.

https://pgducklake.select/blog/introducing-pg-duckpipe/

👉 @SQLPortal
pgducklake.select Introducing pg_duckpipe: Real-Time CDC for Your Lakehouse Automatically keep a fast, analytical copy of your PostgreSQL tables, updated in real time with no external tools needed.
  • 👍 4
  • ❤ 1
Post #1630 2.07K
Никогда не предполагайте, что SQL вычисляет условия слева направо

Если вы пишете код так:

SELECT * FROM products 
WHERE price > 100
AND (total_sales / price) > 10;


Можно предположить, что запрос будет вычисляться слева направо, и это предотвратит ошибку деления на ноль. Однако это не всегда так. Большинство крупных SQL-баз данных НЕ гарантируют short-circuit-вычисление условий AND в WHERE. И даже если в простых случаях кажется, что short-circuit работает, оптимизатор часто перестраивает или вычисляет выражения вне исходного порядка по соображениям производительности.

Это означает, что база данных может попытаться вычислить:

total_sales / price

раньше, чем:

price > 100.

То есть, если какое-либо значение в price равно нулю, может возникнуть ошибка деления на ноль.

Таким образом, даже несмотря на то, что логически условие price > 100 должно предотвращать деление на ноль, фактический порядок выполнения не гарантирует этого.

Чтобы обезопасить себя, можно использовать оператор NULLIF в WHERE:

SELECT *
FROM products
WHERE price > 100
AND (total_sales / NULLIF(price, 0)) > 10;


Никогда не используйте деление в WHERE, если знаменатель не защищён через NULLIF(), не переписан в умноженную форму (например, numerator > denominator * constant) или не обёрнут в CASE.

👉 @SQLPortal
  • 👍 9
  • 🏆 2
  • 🤔 1
Post #1628 1.83K
Причины, почему SELECT * плохо влияет на производительность SQL: читать

Старый блог (с примерами, специфичными для Oracle), где приводится целый ряд причин. Дело не только в сетевом трафике и выполнении плана SQL-запроса, но также в обработке данных на стороне клиента и использовании памяти.

👉 @SQLPortal
  • ❤ 4
Post #1627 2.01K
Много NULL-ов или неактивных строк в PostgreSQL? Настройте частичный индекс (partial index), чтобы индексировались только те данные, по которым вы выполняете запросы. Такие индексы меньше по размеру и уменьшают нагрузку на операции записи.

👉 @SQLPortal
  • 👍 4
Post #1626 2.28K
Совет по Data Engineering: различайте трансформации и действия в Apache Spark

При работе с Apache Spark понимание разницы между transformations и actions имеет ключевое значение.

Transformations (трансформации) — это операции над DataFrame или Dataset, которые создают новый распределённый набор данных на основе существующего.
Обычно они ленивые (lazy) — то есть выполняются не сразу, а лишь формируют логический план выполнения.

Примеры трансформаций из кода:

👉spark.read.option()
👉 withColumn()
👉 filter()
👉 groupBy()
👉 count()

Эти операции описывают, что должен сделать Spark, но фактически выполняются только после вызова действия.

Actions (действия), в свою очередь, запускают выполнение трансформаций и возвращают результат в driver-программу или выводят его.

Примеры действий:

👉 show(5)
👉 collect()

👉 @SQLPortal
  • ❤ 3
  • 👍 3
Post #1625 2.25K
Если номер телефона (`phone`) равен `NULL`, а `backup_phone` равен нулю,

что вернёт этот запрос?

SELECT
COALESCE(phone, backup_phone, 'Not provided') AS primary_contact
FROM customers;


A) NULL
B) ноль (0)
C) 'Not provided'
D) ошибка

👉 @SQLPortal
Post #1624 2.29K
Понимание IOPS в Postgres: зачем они вообще нужны, даже когда данные в кеше: читать

👉 @SQLPortal
  • 👍 4
Post #1623 2.38K
Твой индекс в MySQL не медленный, он просто фрагментирован :)

Базы данных вроде MySQL, которые хранят данные в B+-деревьях, страдают от фрагментации индексов, и это серьезно влияет на производительность. Сейчас объясню.

Фрагментация индекса возникает, когда страницы индекса B+-дерева содержат значительное количество свободного пространства вместо плотного размещения данных. Но почему так происходит?

В MySQL движок InnoDB хранит данные в кластеризованных индексах (организованных по первичному ключу). Когда кластеризованный индекс фрагментируется из-за случайных вставок по первичному ключу (например, UUID), производительность чтения данных ухудшается.

Поскольку движок старается сохранять порядок листовых узлов, при вставке строки в середину происходит split страницы. Разделение страницы выполняется, когда в ней недостаточно свободного места или превышен порог split’а. Со временем повторяющиеся случайные вставки вызывают всё больше таких разделений, из-за чего тратится лишнее пространство.

Фрагментация индекса напрямую влияет на производительность запросов и использование памяти. Когда индексы фрагментированы, базе данных приходится читать больше страниц с диска для выполнения того же запроса, что увеличивает количество I/O-операций и снижает пропускную способность.

Кстати, при последовательных вставках фрагментация минимальна, поскольку InnoDB просто создаёт новые страницы без разделения существующих и размещает их вдоль крайнего правого пути дерева. Это помогает сохранять оптимальную плотность страниц.

Управлять фрагментацией индексов можно, настроив параметр innodb_fill_factor и/или выполнив следующий запрос:

ALTER TABLE tbl_name FORCE;


Надеюсь, было интересно :)

👉 @SQLPortal
  • 👍 5
  • ❤ 3
Post #1622 2.09K
Как создать трекер прогресса в Excel

👉 @SQLPortal
  • ❤ 7
  • 👍 3
Post #1621 2.05K
Аргумент «SQL не масштабируется» — это ленивое и абсурдное обобщение.

Настоящий вопрос не в том, масштабируется SQL или NoSQL. Вопрос в том, соответствует ли база данных вашим требованиям. Если какая-то функция критична для вашего кейса и есть только в одной базе данных, будете ли вы выбирать что-то другое? Конечно нет.

Любая база данных и масштабируется, и не масштабируется одновременно. Всё зависит от того, какой use case вы на ней строите. Если у вас 100 запросов в секунду, зачем вообще заморачиваться с шардингом? Одного инстанса на одном узле будет более чем достаточно.

Масштабируемость — лишь один из факторов при выборе базы данных, а не единственный. Всегда смотрите на ключевые свойства, потребности и требования вашего кейса, а затем выбирайте подходящую БД. Но будьте готовы жить с её недостатками и ограничениями.

Если кто-то говорит вам, что SQL не масштабируется, спросите, что именно он имеет в виду.

👉 @SQLPortal
  • 👍 3
  • ❤ 1
Post #1619 2.01K
Можно ли восстановить данные после DELETE?

В PostgreSQL операция DELETE не стирает данные с диска мгновенно. Механизм MVCC сохраняет удалённые строки в виде dead tuples, и чтение этих dead tuples является одним из рабочих способов восстановления данных.

Однако у этого подхода есть очевидное ограничение по времени: как только autovacuum завершает очистку, dead tuples физически удаляются, и методы восстановления, основанные на файлах данных, перестают работать.

В этот момент альтернативный путь восстановления даёт WAL (Write-Ahead Log). В частности, основой этого подхода служит механизм FPW (Full Page Write) внутри WAL. Инструменты восстановления после DELETE в PostgreSQL, включая PDU (PostgreSQL Data Unloader), опираются именно на эту технику. Её ключевое свойство такое: пока файлы WAL, созданные в период удаления, всё ещё существуют, данные можно полностью восстановить независимо от того, сколько времени прошло.

В этой статье этот путь восстановления разбирается по функциям, шаг за шагом, на основе исходного кода PostgreSQL 18.

👉 @SQLPortal
Pduzc PDU - PostgreSQL Data Unloader Professional PostgreSQL data recovery tool for corrupted databases
  • 👍 3
Post #1617 2.05K
Используйте EXISTS вместо COUNT(*) для проверки существования

Если вам нужно проверить, существует ли конкретная запись в данных, не стоит использовать COUNT() с фильтром (WHERE).

COUNT(*) заставляет базу данных посчитать все подходящие строки, прежде чем определить, есть ли вообще хоть одна строка. Из-за этого база делает лишнюю работу, особенно на больших таблицах. Как однажды пошутили: использовать COUNT() для проверки существования, это как проверять, есть ли кто-нибудь дома, по данным переписи населения.

Вот наивный вариант:

SELECT *
FROM Customers c
WHERE (
SELECT COUNT(*)
FROM Orders o
WHERE o.CustomerID = c.CustomerID
) > 0;


База данных должна посчитать все заказы для каждого клиента, прежде чем проверить условие.

Вместо COUNT() правильнее использовать EXISTS. Оператор EXISTS прекращает поиск сразу после того, как находит первую подходящую строку. Это позволяет движку БД сделать short-circuit при поиске, а сам запрос становится эффективнее и лучше масштабируется.

Кроме того, если по столбцу, который участвует в условии, есть индекс, база данных сможет находить подходящие строки ещё быстрее, что дополнительно улучшает производительность. Поэтому EXISTS считается стандартным подходом в случаях, когда нужно ответить только на один вопрос: существует ли хотя бы одна подходящая строка. Пример:

-- Создайте индекс, чтобы ускорить поиск
CREATE INDEX idx_orders_customerid
ON Orders(CustomerID);

-- Используйте EXISTS, чтобы проверить, есть ли хотя бы один заказ
SELECT *
FROM Customers c
WHERE EXISTS (
SELECT 1
FROM Orders o
WHERE o.CustomerID = c.CustomerID
);


Когда индекс уже есть, база данных может быстро найти подходящие строки в таблице Orders и остановить поиск сразу после первого совпадения. Это делает запрос заметно эффективнее, особенно при работе с большими наборами данных.

👉 @SQLPortal
  • 👍 12
Post #1616 1.81K
Избегайте использования IN с NULL

Оператор IN относится к тем конструкциям, которые легко вносят тихие баги в запрос, если использовать его неправильно. Когда вы включаете NULL в список IN, сравнение никогда не даст TRUE для части с NULL. В результате строки, содержащие NULL, не матчятся так, как многие ожидают. SQL использует трёхзначную логику: TRUE, FALSE и UNKNOWN. Сравнения с NULL не возвращают ни TRUE, ни FALSE; они возвращают UNKNOWN. Вот наивный вариант использования IN:

SELECT *
FROM Employees
WHERE DepartmentID IN (1, 2, NULL);


Поскольку NULL даёт UNKNOWN, запрос выше выполнится без ошибок, но гарантированно вернёт пустой результат.

Правильный способ обрабатывать NULL - использовать IS NULL. IS NULL явно учитывает то, как SQL работает с отсутствующими значениями. Это помогает запросу корректно различать реальные значения и неизвестные значения, что предотвращает тихие логические ошибки. Вот как этот запрос лучше писать:

SELECT *
FROM Employees
WHERE DepartmentID IN (1, 2)
OR DepartmentID IS NULL;


👉 @SQLPortal
  • 👍 8
  • 🔥 2
Post #1615 1.96K
Всегда добавляйте неагрегированные столбцы в GROUP BY

Это одна из тех практик, которые новички часто игнорируют, особенно если работают с базой данных, которая не навязывает строгие правила группировки, например SQLite.

Оператор GROUP BY обычно используется вместе с агрегатными функциями вроде COUNT(), SUM() или AVG(). Эти функции сводят данные, а столбцы в GROUP BY определяют, как именно данные группируются. Иначе говоря, агрегированные результаты вычисляются для каждой группы, заданной неагрегированными столбцами.

Если столбец присутствует в SELECT, но при этом не агрегируется и не включён в GROUP BY, база данных может не понимать, какое именно значение из этого столбца нужно вернуть для группы. Вот как может выглядеть плохо написанный запрос:

SELECT
Department,
EmployeeID,
COUNT(*) AS EmployeeCount
FROM Employees
GROUP BY Department;


Почему наивный подход здесь проблемный? Когда вы используете агрегатные функции, такие как COUNT(), SUM() или AVG(), SQL группирует строки по столбцам, перечисленным в GROUP BY. Поэтому каждая строка в результате представляет одну группу.

Если неагрегированный столбец присутствует в списке SELECT, но не включён в GROUP BY, движок базы данных не знает, какое значение из этого столбца должно представлять всю группу. Иначе говоря, внутри одной группы может быть несколько строк, и в каждой из них может быть разное значение этого столбца.

Если в такой ситуации ваша база данных выбрасывает ошибку, вам на самом деле повезло, потому что это заставляет исправить запрос. Но некоторые базы данных позволят такому запросу выполниться и просто вернут произвольное значение из группы. Это может привести к непоследовательным или вводящим в заблуждение результатам. Особенно опасно то, что запрос с виду работает нормально, при этом молча выдавая некорректный результат. Вот как писать правильно:

SELECT
Department,
EmployeeID,
COUNT(*) AS EmployeeCount
FROM Employees
GROUP BY EmployeeID, Department;


Теперь у нас и EmployeeID, и Department включены в GROUP BY. Это правильный способ. Добавление всех неагрегированных столбцов в GROUP BY гарантирует, что каждая строка в результате соответствует чётко определённому уровню агрегации. Это убирает неоднозначность и делает запрос логически корректным и переносимым между разными СУБД.

👉 @SQLPortal
  • 🔥 3
Post #1614 2.1K
Использование SKIP LOCKED в Postgres в запросах или процессах позволяет строить очереди задач, гарантируя, что отдельные строки обрабатываются внутри транзакции без блокировки при одновременной работе нескольких экземпляров джобы.

👉 @SQLPortal
  • 👍 4
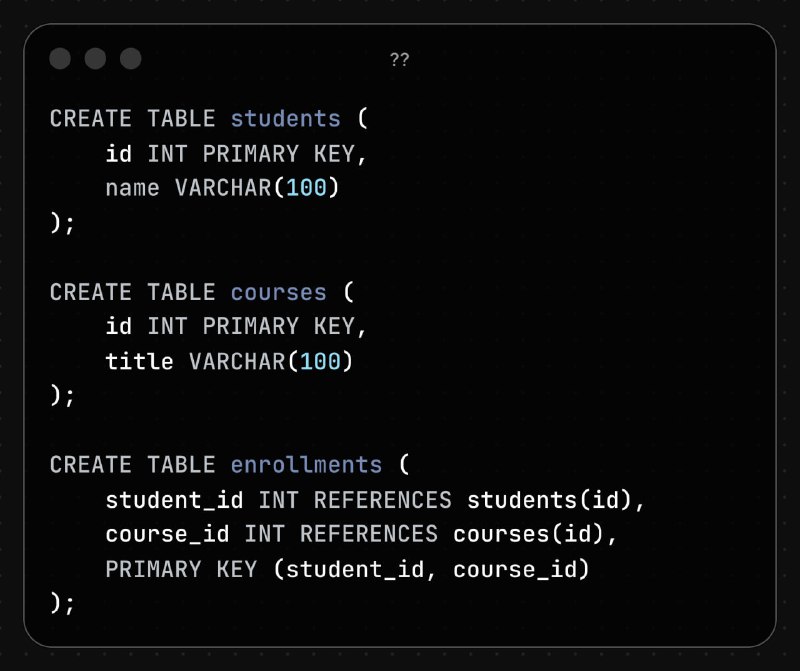
Post #1612 1.99K
Какие отношения существуют между этими тремя таблицами и как вы это узнаете?

👉 @SQLPortal
  • 👍 1
Post #1611 2.13K
Если используешь COUNT вместе с CASE, не ставь ELSE 0

Пример:

SELECT 
Department,
COUNT(CASE WHEN Status = 'Active' THEN EmployeeID ELSE 0 END) AS ActiveCount
FROM Employees
GROUP BY Department;


Это неправильно и даст некорректный результат. Когда ты пишешь ELSE 0, COUNT начинает считать нули как значения. COUNT игнорирует только NULL, а ноль это не NULL. Поэтому если в отделе 10 активных и 5 неактивных сотрудников, запрос вернет 15 для ActiveCount, потому что посчитает все 15 строк (10 EmployeeID + 5 нулей).

Лучше так: убрать ELSE 0:

SELECT 
Department,
COUNT(CASE WHEN Status = 'Active' THEN EmployeeID END) AS ActiveCount
FROM Employees
GROUP BY Department;


ELSE тут не нужен. Если условие не выполняется, выражение вернет NULL, а COUNT NULL-ы не считает. Еще более явно можно написать так:

SELECT 
Department,
COUNT(CASE WHEN Status = 'Active' THEN 1 END) AS ActiveCount
FROM Employees
GROUP BY Department;


Единственный случай, когда ELSE 0 будет уместен, это если вместо COUNT ты используешь SUM.

👉 @SQLPortal
  • ❤ 4
  • 👍 2
Post #1610 2.05K
Вопрос по SQL

Нужно получить:

- все товары дешевле 100
- плюс товары из категории Electronics дешевле 500

Какое условие корректно вернет такой результат?

A)

price < 100 AND category = 'Electronics' OR price < 500


B)

price < 100 OR (category = 'Electronics' AND price < 500)


C)

(price < 100 OR category = 'Electronics') AND price < 500


👉 @SQLPortal
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →