TGViewer
Channel Public Channel
SQL Portal | Базы Данных

SQL Portal | Базы Данных

@sqlportal

Присоединяйтесь к нашему каналу и погрузитесь в мир баз данных

Связь: @devmangx

РКН: https://clck.ru/3H4Wo3
Subscribers
13.8K
Photos
1.1K
Videos
142
Links
810

Showing posts older than #1610 · Back to latest

Older Posts 17 shown
Post #1609 2.17K
Не используй CASE в WHERE

Один из самых частых SQL анти-паттернов это пихать CASE прямо в WHERE, чтобы разрулить условную логику для диапазонов или фильтров.

Классический пример:

SELECT * FROM products
WHERE
CASE WHEN category = 'Electronics' THEN price < 500 ELSE price < 100 END;


Работает, но часто убивает производительность, потому что CASE делает предикат не SARGable в большинстве популярных СУБД. Оптимизатор уже не может нормально сделать index seek по индексу на price (или по составному индексу (category, price)). В итоге нередко получаешь full table scan, даже если индексы отличные.

Лучше переписать так:

SELECT * FROM products
WHERE price < 100
OR (category = 'Electronics' AND price < 500);


Этот вариант лучше, потому что логика становится прямолинейной и без лишних условий. Запрос проще читать, проще поддерживать, и оптимизатору проще рассуждать о предикатах, потому что они “голые”, без обертки в логическое ветвление.

👉 @SQLPortal
  • 👍 10
  • ❤ 3
Post #1608 2.01K
Open-source инструмент Text2SQL, который превращает запросы на естественном языке в SQL, используя понимание схемы на базе графа. Задавай вопросы к базе простым языком, а QueryWeaver сам сделает всю склейку и соберет нужный SQL.

https://github.com/FalkorDB/QueryWeaver

👉 @SQLPortal
  • ❤ 5
Post #1607 2.01K
Поток данных в Postgres для чтения/записи:

Приложение --> (опционально) пулер --> отдельный backend/клиентское соединение --> shared buffers --> кэш ОС (page cache) --> физический диск.

При чтении к кэшу ОС или диску обращается только если нужных страниц нет в shared buffers.

👉 @SQLPortal
  • 👍 1
Post #1605 2.36K
Cтатья про ACID-свойства.

Не только теория, но и практическая реализация на PostgreSQL с примерами из реальной жизни.

Этот пост отлично зайдет новичкам, которые хотят начать разбираться в базах данных, и он же нужен как база перед моей серией про внутренности PostgreSQL.

👉 @SQLPortal
Medium ACID Properties Explained: A Complete Guide with PostgreSQL Implementation ACID Properties for Beginners. Not only theory but also practicle implementation using PostgreSQL.
Post #1603 2.31K
Полезные Excel формулы

👉 @SQLPortal
  • 👍 6
Post #1601 2.35K
JSONB-колонки Postgres и TOAST: гайд по производительности

Postgres даёт огромный набор фич на уровне пользователя под кучу разных кейсов, а под капотом там довольно сложная абстракция.

Работа с API и массивами в типе jsonb в последнее время стала заметно популярнее, и хранить куски данных приложения в jsonb превратилось в распространённый паттерн.

Но зачем вообще “нарезать” JSON-объект на строки и колонки, а потом собирать его обратно, чтобы отправить клиенту?

Ответ: эффективность. Postgres быстрее всего работает со строками и колонками, а когда ты прячешь структуру данных внутрь JSON, движку сложнее разогнаться на максимум, как он мог бы.

👉 @SQLPortal
Snowflake Postgres JSONB Columns and TOAST: A Performance Guide Understand how Postgres handles variable-length JSONB data using The Oversize Attribute Storage Technique (TOAST). Explore techniques to avoid the TOAST tax and efficiently retrieve your data.
Post #1600 2K
Как выполнить поиск по нескольким условиям с помощью Xlookup

👉 @SQLPortal
  • ❤ 5
  • 🔥 3
Post #1599 1.99K
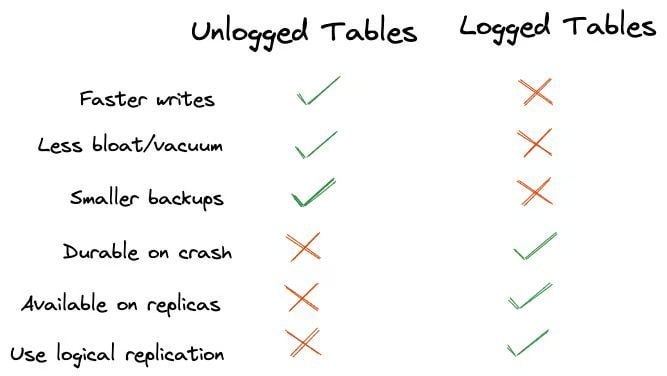
В Postgres есть unlogged-таблицы: для них отключается Write-Ahead Logging (WAL). За счёт этого запись становится заметно быстрее, но очевидная цена — такие таблицы не реплицируются через WAL и после крэша/перезапуска их содержимое не восстанавливается (по сути, данные считаются временными). В некоторых сценариях этот размен реально оправдан.

👉 @SQLPortal
  • 👍 5
Post #1598 2.18K
Перестань переписывать JOIN через ON; используй USING

Если ты давно пишешь JOIN’ы в SQL, ты наверняка привык к ON. Оно работает и делает свою работу. Но когда ты джоинишь две таблицы по колонкам с абсолютно одинаковым именем, есть более чистый и аккуратный вариант: USING.

Вот почему стоит подумать о переходе.

SELECT 
e.Employee_ID,
e.Employee_Name,
e.Department,
s.Net_Sales
FROM Employees e
JOIN sales s
ON e.Employee_ID = s.Employee_ID;


ON ок, но оно многословное. Приходится повторять и имена таблиц, и имена колонок. Если имя колонки одинаковое в обеих таблицах, ты по сути пишешь одно и то же дважды. Хуже того: когда выбираешь колонки, можешь получить два столбца Employee_ID, если явно не квалифицировать их.

USING это сокращение для join’ов по равенству, когда колонки называются одинаково. Та же самая выборка будет такой:

SELECT 
e.Employee_ID,
e.Employee_Name,
e.Department,
s.Net_Sales
FROM Employees e
JOIN sales s
USING (Employee_ID);


Намного чище, да? USING автоматически сопоставляет колонки с одинаковым именем и делает inner join (или left/right join, в зависимости от типа join). Ты указываешь имя колонки один раз.

Перейти на USING это маленькое изменение, которое делает SQL короче и более “самодокументируемым”. Меньше шансов ошибиться, и результирующий набор получается аккуратнее. В следующий раз, когда джоинишь по одинаково названным колонкам, выкинь ON и попробуй USING. Только проверь, что твоя СУБД поддерживает USING.

👉 @SQLPortal
  • ❤ 11
Post #1592 2.17K
Какой SQL-запрос работает быстрее?

SELECT * FROM orders
WHERE status = 'NEW'
OR status = 'PENDING'
OR status = 'PROCESSING';


vs

SELECT * FROM orders
WHERE status IN ('NEW', 'PENDING', 'PROCESSING');


👉 @SQLPortal
  • 🤔 7
  • ❤ 2
Post #1591 2.16K
В Postgres 18 появился новый метод клонирования для создания баз данных из шаблонных (template) БД, который работает заметно быстрее, чем другие способы. Это работает на конкретных файловых системах, которые поддерживают copy-on-write / reflink.


👉 @SQLPortal
  • 👍 4
  • ❤ 1
Post #1590 2.24K
В Postgres можно делать функциональные индексы для запросов, которые приходят в конкретном формате. Например, для TIMESTAMP, когда в запросе фильтрация идет только по дате:

CREATE INDEX idx_orders_dt_only ON orders ((created_at::date)); 

SELECT count(*) FROM orders WHERE created_at::date = '2024-05-20';


👉 @SQLPortal
  • 👍 3
  • 🤯 2
  • ❤ 1
Post #1589 2.3K
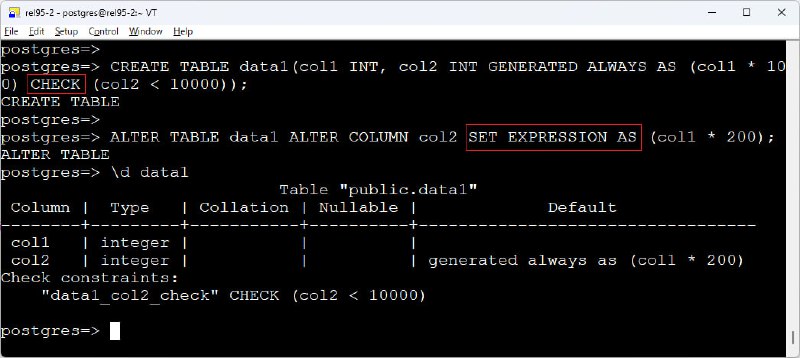
В PostgreSQL 19 (dev) прилетели еще 2 полезных изменения:

1. Разрешили ALTER COLUMN SET EXPRESSION для виртуальных столбцов с CHECK-ограничениями

2. Запретили CR и LF в именах баз данных, ролей и табличных пространств

Небольшие изменения, но оба коммита полезные:
- первый про более гибкую работу с virtual columns
- второй про ужесточение/санитизацию имен и снижение странных кейсов

👉 @SQLPortal
  • 👍 1
Post #1587 2.3K
Один чувак написал подробный разбор того, как базы данных на самом деле выполняют JOIN'ы.

В этом разборе он объясняет, какие алгоритмы работают под капотом, когда мы используем JOIN: nested loop join, hash join, merge join, index join, grace hash join и broadcast join, а также почему query planner выбирает один вариант вместо другого.

Если тебе было интересно, почему в одном случае JOIN срабатывает мгновенно, а в другом ужасно тормозит, или как базы данных эффективно джойнят таблицы с миллиардами строк, этот материал поможет собрать четкую ментальную модель. Почитай.

👉 @SQLPortal
  • 👍 4
Post #1583 2.46K
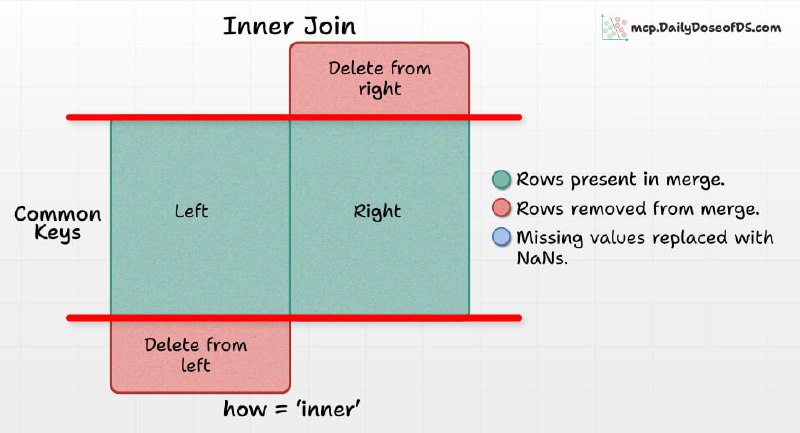
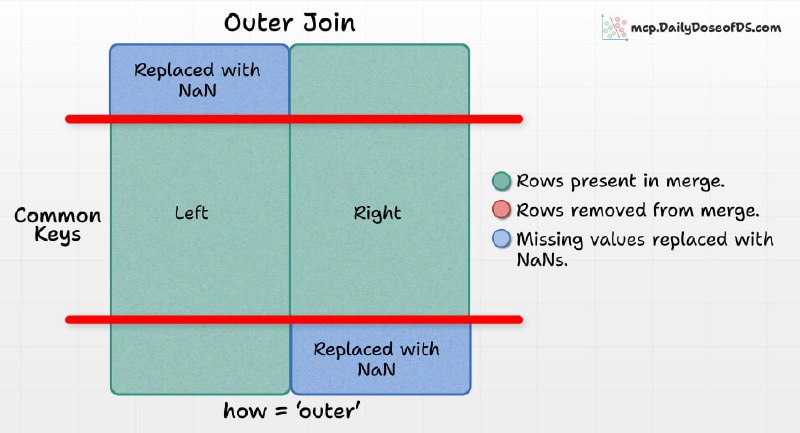
Хватит объяснять SQL JOIN’ы через диаграммы Венна.

Вот 4 картинки, которые показывают это намного логичнее:

👉 @SQLPortal
  • 👍 17
  • 😁 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →