TGViewer
Channel Public Channel
SQL Ready | Базы Данных

SQL Ready | Базы Данных

@sql_ready

Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!

Cотрудничество: @energy_c

РКН: https://clck.ru/3QREBc
Subscribers
17.5K
Photos
1.4K
Videos
114
Links
766

Showing posts older than #1564 · Back to latest

Older Posts 11 shown
Post #1562 2.34K
  • 😁 26
  • ❤ 11
  • 👍 5
  • 🔥 1
Post #1561 2.7K
Keyset-пагинация: быстрый скролл без OFFSET!

OFFSET…LIMIT прост, но плохо масштабируется: чем дальше страница, тем медленнее запрос и выше риск дубликатов при вставках.
Keyset использует курсор (id/дату) и даёт стабильную скорость на больших объёмах.

Создаём таблицу (пример на PostgreSQL):
CREATE TABLE posts (
id BIGSERIAL PRIMARY KEY,
title TEXT NOT NULL,
created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);


Подготавливаем входящие данные с помощью CTE:
WITH cursor AS (
SELECT 1000::BIGINT AS last_seen_id
)


Здесь мы храним «курсор» — id последней записи, которую клиент уже получил.

Получаем следующую страницу без OFFSET по keyset-подходу:
SELECT p.id, p.title, p.created_at
FROM posts p
JOIN cursor c ON TRUE
WHERE p.id < c.last_seen_id
ORDER BY p.id DESC
LIMIT 20;


Запрос отдаёт следующие 20 записей с id < last_seen_id.
На клиенте берём минимальный id из результата и используем его как новый last_seen_id для следующего запроса.
🔥 Подход работает в PostgreSQL, MySQL, SQL Server и др.: стабильно, эффективно и без проблем с дубликатами при конкурентных вставках.

➡️ SQL Ready | #практика
  • ❤ 15
  • 👍 8
  • 🔥 6
  • 🤝 2
Post #1559 2.53K
✍️ LangShift — учись новому языку программирования, используя знания, которые у тебя уже есть!

Этот сайт предлагает другой путь: выбираешь язык, который уже знаешь, и переходишь на новый через сопоставление синтаксиса и парадигм. Более 80 модулей, 30+ проектов, всё бесплатно и без регистрации.

📌 Оставляю ссылочку: langshift.dev

➡️ SQL Ready | #ресурс
  • 👍 15
  • 🔥 7
  • 🤝 6
  • ❤ 1
Post #1553 2.47K
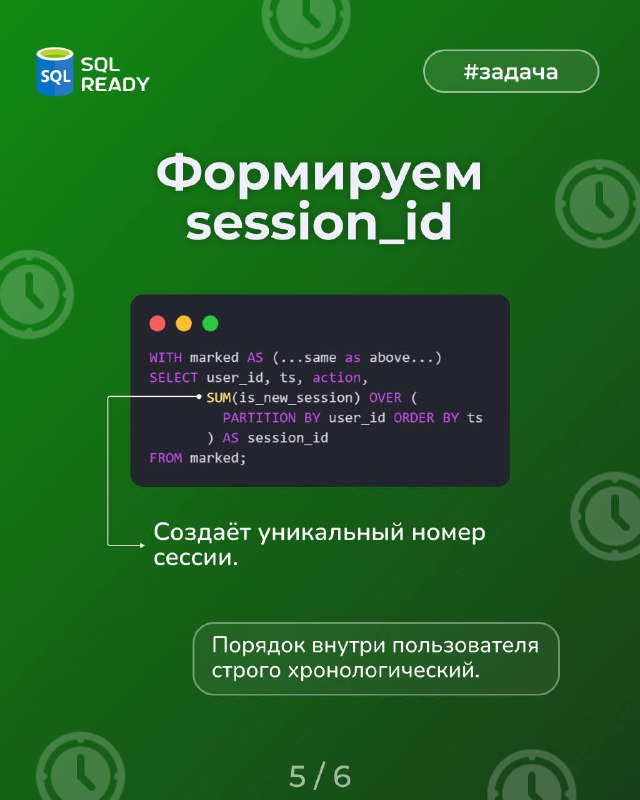
🖥 Как восстановить пользовательские сессии без session_id?

SQL позволяет восстановить сессии даже без session_id, выделяя их по временным разрывам и последовательности событий.

Сегодня в задаче:
• Определим моменты, когда начинается новая сессия;

• Присвоим каждому событию уникальный session_id с помощью оконной суммы;

• Получим полноценные сессии так же, как это делают продуктовые аналитические платформы.


Пригодится для расчёта удержания, построения пользовательских путей, анализа фич и диагностики проблем поведения.

➡️ SQL Ready | #задача
  • 👍 12
  • 🔥 9
  • 🤝 7
Post #1551 2.27K
😎 На Хабре вышла полезная статья: «6 лайфхаков при внедрении СУБД: учимся на чужих граблях»!

В этой статье:
• Разберёте реальные ошибки при развёртывании СУБД;
• Узнаете, как повысить производительность запросов через правильное партицирование и не только;
• Поймёте, как организовать конкурентный доступ и обновления данных без блокировок и простоев;
• Получите шесть конкретных лайфхаков, которые помогут избежать критических проблем.


🔊 Продолжайте читать на Habr!


➡️ SQL Ready | #статья
  • 👍 13
  • ❤ 10
  • 🔥 6
  • 🤝 2
Post #1550 2.34K
Работа со строками в PostgreSQL — извлекаем данные с помощью регулярных выражений!

В аналитике часто нужно разобрать строку: вытащить домен из email, код из SKU, номер из текста. PostgreSQL предоставляет функции regexp_match и regexp_replace, позволяющие делать это напрямую в SQL.

Создадим таблицу:
CREATE TABLE users (
id INT,
email TEXT,
profile_code TEXT
);


Извлечём домен из email:
SELECT 
id,
email,
(regexp_match(email, '@(.+)$'))[1] AS domain
FROM users;


regexp_match возвращает один массив, и [1] достаёт первую группу. Паттерн @(.+)$ берёт всё, что стоит после символа @.

Вытащим числовую часть из кода профиля, например "USR-2391-A":
SELECT 
id,
profile_code,
(regexp_match(profile_code, '([0-9]+)'))[1] AS numeric_part
FROM users;


Паттерн ([0-9]+) извлекает последовательность цифр.

Удалим всё кроме букв и цифр — удобно для нормализации входных данных:
SELECT 
id,
regexp_replace(profile_code, '[^A-Za-z0-9]', '', 'g') AS cleaned
FROM users;

🔥 Такие операции часто используются при подготовке данных, парсинге логов, анализе текстовых полей и нормализации входных атрибутов.

➡️ SQL Ready | #практика
  • ❤ 15
  • 👍 9
  • 🔥 8
Post #1548 2.88K
😎 Sqltest - бесплатный онлайн-тренажёр для практики запросов прямо в браузере!

Вам будут доступы более 320 интерактивных задач разной сложности: от простых SELECT-запросов до вложенных подзапросов и агрегаций. Поддерживаются MySQL, PostgreSQL, MS SQL и Firebird, есть мгновенная проверка решений и удобный интерфейс для отработки навыков на практике.

📌 Оставляю ссылочку: sqltest.online

➡️ SQL Ready | #ресурс
  • 🔥 18
  • ❤ 9
  • 👍 8
Post #1547 2.42K
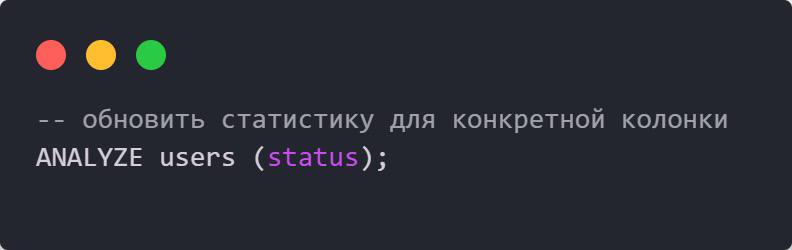
Как точечно понять, почему конкретный индекс НЕ используется оптимизатором?

Если запрос игнорирует индекс, причина может быть не в индексе, а в том, что PostgreSQL не знает, насколько селективное значение в колонке.

Обновить статистику можно точечно, для одной конкретной колонки:
ANALYZE users (status);


Теперь оптимизатор видит реальное распределение значений и может корректно выбрать Index Scan.

Хотите повысить точность — увеличьте глубину сбора статистики:
ALTER TABLE users
ALTER COLUMN status SET STATISTICS 500;


🔥 Позволяет понять почему план деградирует и как вернуть индекс в работу, без изменения кода и структуры данных.

➡️ SQL Ready | #совет
  • ❤ 13
  • 👍 9
  • 🔥 9
Post #1545 2.29K
📂 Напоминалка по оптимизации производительности БД!

Например, грамотное индексирование ускоряет выборки в разы, шардирование помогает масштабировать систему под высокий трафик, а репликация повышает отказоустойчивость и снижает нагрузку на основной узел.

На изображении — структурированное напоминание о ключевых метриках, типах нагрузок и практических стратегиях оптимизации.

Сохрани, чтобы не забыть!

➡️ SQL Ready | #ресурс
  • 👍 13
  • 🔥 8
  • 🤝 7
Post #1544 2.38K
ALL и ANY в SQL — учимся использовать для сравнения с подзапросами!

Эти операторы предназначены для сравнения результатов одного SELECT с результатами второго SELECT из подзапроса, что может быть удобно в некоторых случаях: если подзапрос возвращает небольшое количество строк или когда нужно сравнить значение хотя бы с одним значением из подзапроса.

Представим, что нам нужно найти все продукты, цена которых выше, чем цена любого продукта в категории Discount:
SELECT product, price 
FROM products
WHERE price > ALL (SELECT price FROM products WHERE category = 'Discount');


Теперь найдем всех клиентов, заказавших хотя бы один продукт с ценой выше 1000 рублей:
SELECT DISTINCT customer_id 
FROM orders
WHERE product_id = ANY (SELECT product_id FROM products WHERE price > 1000);


И найдем всех клиентов, которые заказывали продукты из определенной категории:
SELECT DISTINCT customer_id
FROM orders
WHERE product_id = ANY (SELECT product_id FROM products WHERE category = 'Electronics');


🔥 Но помните, что использование ALL и ANY возможно только с подзапросами и может быть неэффективным, если подзапрос возвращает большое количество строк.

➡️ SQL Ready | #практика
  • 🤝 17
  • 👍 9
  • 🔥 9
  • ❤ 2
Post #1538 2.28K
🖥 Какие API-маршруты действительно тормозят систему?

В производительных системах реальный UX определяется не средним временем ответа, а редкими хвостовыми задержками, из-за которых важны именно p95 и p99.

Сегодня в задаче:
• Посчитаем ключевые перцентильные метрики (p50/p95/p99) по каждому маршруту;

• Определим, какие запросы регулярно превышают собственный p99;

• Увидим, какие эндпоинты “убивают” отклик сервиса под нагрузкой;


Такой анализ помогает быстро находить узкие места API и контролировать качество работы системы.

➡️ SQL Ready | #задача
  • 👍 14
  • ❤ 11
  • 🔥 8
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →