TGViewer
Channel Public Channel
SQL Ready | Базы Данных

SQL Ready | Базы Данных

@sql_ready

Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!

Cотрудничество: @energy_c

РКН: https://clck.ru/3QREBc
Subscribers
17.5K
Photos
1.4K
Videos
114
Links
765

Showing posts older than #1538 · Back to latest

Older Posts 7 shown
Post #1536 2.31K
RETURNING: получение данных прямо из DML!

Во многих СУБД (например, PostgreSQL, Oracle и др.) оператор RETURNING позволяет вернуть значения вставленных, обновлённых или удалённых строк без дополнительного SELECT.

Вставляем строку и сразу получаем созданный ID:
INSERT INTO users (name, email)
VALUES ('Anna Ivanova', 'anna@example.com')
RETURNING id;


Обновляем запись и возвращаем изменённое значение:
UPDATE accounts
SET balance = balance + 500
WHERE id = 10
RETURNING balance AS new_balance;


Удаляем строку и получаем данные до удаления:
DELETE FROM orders
WHERE id = 42
RETURNING order_date, amount;


Возвращаем множество строк:
UPDATE products
SET price = price * 1.10
WHERE category = 'Books'
RETURNING id, price;


🔥 RETURNING упрощает логику: нет необходимости выполнять дополнительный запрос, чтобы получить новые данные — они доступны сразу в рамках одного DML.

➡️ SQL Ready | #практика
  • 👍 16
  • ❤ 10
  • 🔥 7
Post #1534 2.6K
☕️ CodeAbbey — тренажёр алгоритмического мышления!

Сайт с огромной коллекцией задач по программированию, от самых простых до тех, что реально заставят подумать.
Учиться можно на абсолютно любом языке. Отличный способ подтянуть логику, научиться писать аккуратный код и подготовиться к собесам.

📌 Оставляю ссылочку: codeabbey.com

➡️ SQL Ready | #ресурс
  • ❤ 18
  • 👍 13
  • 🔥 9
Post #1529 2.45K
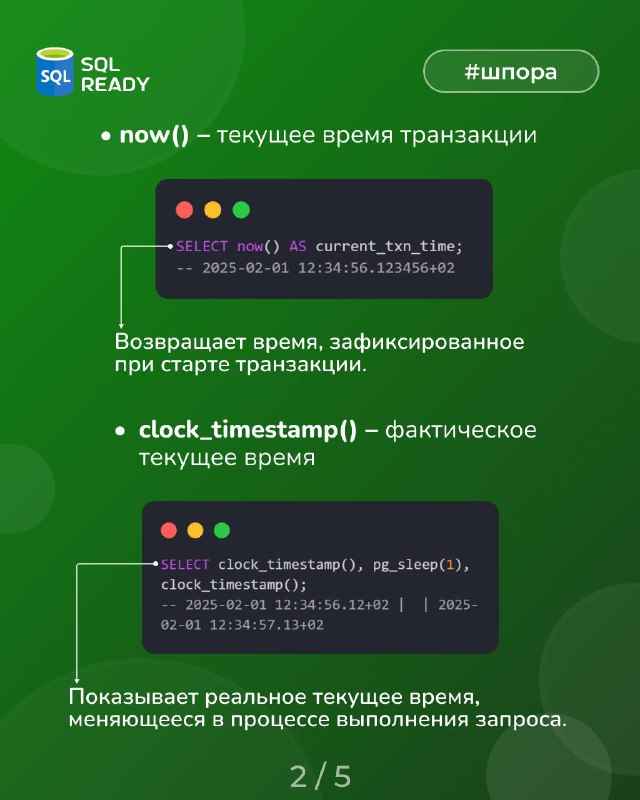
🖥 Методы для работы с датой и временем в PostgreSQL!

Эта шпаргалка охватывает наиболее используемые функции PostgreSQL для получения текущего времени, извлечения компонентов дат, расчета интервалов, округления временных меток и преобразования Unix-времени. Подходит для разработки систем, где критична точная и предсказуемая работа с временными значениями.

➡️ SQL Ready | #шпора
  • ❤ 14
  • 🔥 8
  • 👍 7
  • 🤝 2
Post #1527 2.12K
QUALIFY: фильтрация после оконных функций!

Иногда нужно фильтровать строки после вычисления оконных функций. В большинстве диалектов SQL для этого нужен подзапрос, но в ряде СУБД (Snowflake, BigQuery, Teradata, Oracle 23c) есть конструкция QUALIFY, позволяющая делать это напрямую.

Отбираем строки только с первым местом внутри категории:
SELECT id, category, score,
RANK() OVER (
PARTITION BY category
ORDER BY score DESC
) AS rnk
FROM results
QUALIFY rnk = 1;


Фильтруем строки, где разница с предыдущим значением больше 50:
SELECT id, value,
value - LAG(value) OVER (
ORDER BY id
) AS diff_prev
FROM metrics
QUALIFY diff_prev > 50;


Оставляем топ-3 самых больших заказов каждого клиента:
SELECT customer_id, order_id, amount,
ROW_NUMBER() OVER (
PARTITION BY customer_id
ORDER BY amount DESC
) AS rn
FROM orders
QUALIFY rn <= 3;


🔥 QUALIFY помогает писать чище и короче, избавляя от лишних подзапросов. Особенно полезен в аналитических задачах с большим числом оконных функций.

➡️ SQL Ready | #практика
  • 🔥 13
  • 👍 9
  • ❤ 7
  • 🤝 1
Post #1522 2.2K
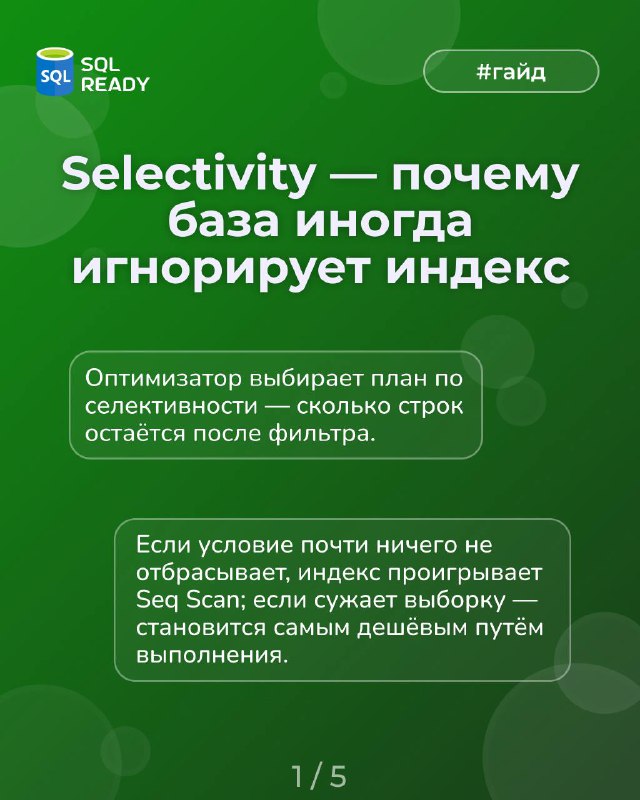
🖥 Selectivity — почему индекс может не сработать?

Селективность определяет, сколько строк проходит через фильтр, и именно по этому показателю оптимизатор выбирает план запроса.

Сегодня в гайде:
• Как селективность влияет на выбор плана;

• Почему один и тот же запрос может работать по-разному на разных данных;

• Как устаревшая статистика приводит к “не тем” решениям оптимизатора.


Эта тема, помогает понимать реальные причины поведения плана.

➡️ SQL Ready | #гайд
  • 👍 17
  • ❤ 7
  • 🔥 7
  • 🤝 1
Post #1520 2.31K
Как увидеть фрагментацию таблиц?

Часто производительность падает из-за накопления устаревших (dead) кортежей, которые остаются после UPDATE/DELETE до следующего VACUUM.

Посмотреть их реальный объём можно напрямую из системной статистики:
SELECT relname,
n_dead_tup,
n_live_tup
FROM pg_stat_all_tables
WHERE relname = 'orders';


n_dead_tup — количество устаревших кортежей, n_live_tup — актуальные строки.

Чтобы быстро найти самые “раздутые” таблицы, отсортируем по dead-tup:
SELECT relname, n_dead_tup
FROM pg_stat_all_tables
ORDER BY n_dead_tup DESC
LIMIT 10;


Хотите оценить степень фрагментации? Сравните dead/live в процентах:
SELECT relname,
n_dead_tup,
n_live_tup,
round(100.0 * n_dead_tup / (n_live_tup + 1), 2) AS dead_ratio
FROM pg_stat_all_tables;


🔥 Это позволяет быстро увидеть, где появляются накладные расходы на I/O и почему планы запроса деградируют.

➡️ SQL Ready | #совет
  • 🔥 15
  • 👍 9
  • ❤ 8
Post #1514 2.41K
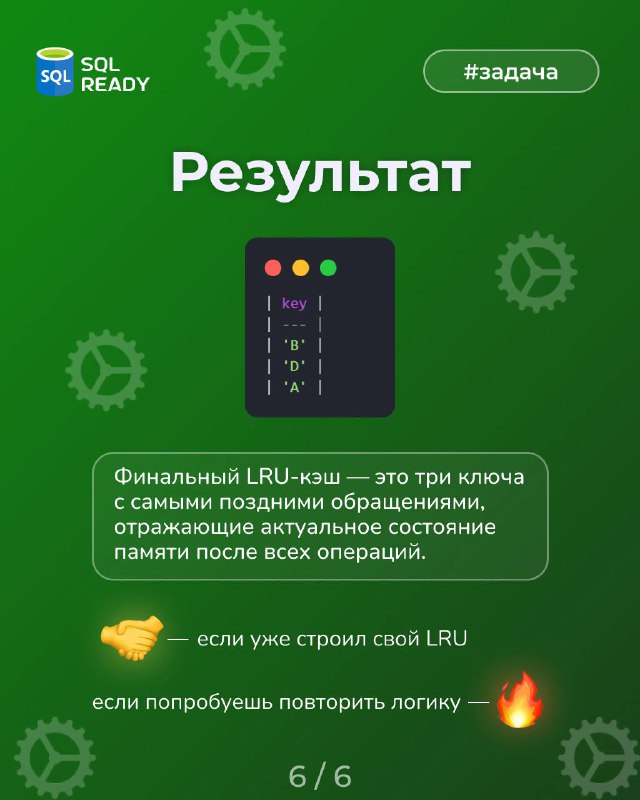
🖥 Как восстановить состояние LRU-кэша после серии обращений?

Возьмём последовательность обращений к ключам и с помощью SQL определим, какие из них “выжили” в памяти при ограниченном размере кэша.

Сегодня в задаче:
• Найдём последнее обращение к каждому ключу, определив его актуальность на момент завершения всех операций.

• Отсортируем элементы по “новизне” использования и применим ограничение capacity;

• Получим итоговое состояние LRU-кэша;


Такой подход позволяет анализировать поведение кэшей и логи обращений без процедурного кода.

➡️ SQL Ready | #задача
  • 👍 14
  • ❤ 8
  • 🔥 7
  • 🤝 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →