
Ти зрозумів нові моделі не так
На каналі я обіцяв окремо розповісти про Claude Fable 5 і GPT-5.6 Sol
Але сів писати й зрозумів, що не хочу ще раз переказувати бенчмарки, ціни й розміри контексту
Ці цифри вже показали, порівняли й пережували в кожному другому каналі
Хотілось знайти щось цікавіше
Не чергові 8% у бенчмарку, а що нове покоління моделей реально змінює у твоєму воркфлоу
І тут мій друг написав пост про власний досвід із цими моделями. Думка мене зачепила настільки, що я вирішив адаптувати її для каналу
Останні два тижні він щільно ганяв Fable 5 і GPT-5.6 Sol
І ледь не списав Fable з рахунків
Підійшов до неї як до просто розумнішої Opus 4.8:
Описав задачу
Написав детальну спеку
Перетворив її на план
Став над душею під час реалізації
Результат виявився гіршим, ніж з Opus
А потім він випадково відкрив Fable поза Claude Code - у Claude Design
Без звичних скілів, scaffolding і всього обвісу, який роками збирав навколо свого воркфлоу
Тому просто описав потрібний результат і окремо вказав місця, в яких сам не був упевнений
І модель раптом відпрацювала набагато краще
Проблема була не в моделі
Проблема була в процесі
Spec-driven development намагається ухвалити більшість рішень до початку роботи
Ти описуєш не лише проблему, а й маршрут до рішення. Але на старті можеш назвати тільки ті невідомі, про які вже знаєш
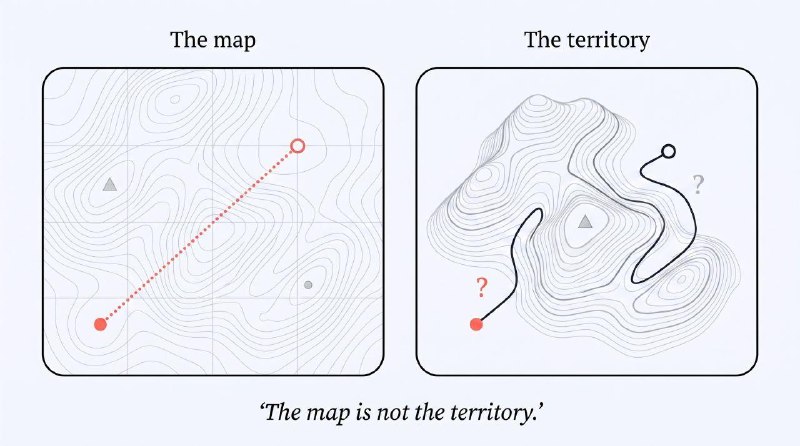
Спека - це карта. Чиста, акуратна й бажано з прямою дорогою з точки А в точку Б
А реальна задача - територія. Обмеження, тупики й сюрпризи, які стають видимими лише тоді, коли хтось починає нею йти
Карта не стала непотрібною
Вона просто перестала бути фінальною
Нові моделі вже не лише виконують маршрут. Вони досліджують територію й допомагають перемальовувати карту прямо під час роботи
Тому процес тепер більше схожий на серію коротких циклів:
Сформулював результат і межі
Дав моделі зробити крок
Подивився, що вона знайшла
Ухвалив наступне рішення
Записав нові невідомі й хибні припущення в памʼять
Продовжив
Останній пункт тут критичний
Якщо не записувати, що змінилось у твоєму розумінні задачі, модель знову й знову ходитиме тією самою територією й знаходитиме ті самі граблі
Ще один цікавий момент - effort level
Для більшості задач друг лишає High
На xhigh і особливо ultra модель інколи стає параноїком - перевіряє вже підтверджені рішення, сумнівається у власних висновках і продовжує думати, коли інформації вже достатньо для дії
Тому максимальні рівні - для глибокого ресерчу й справді неоднозначних задач
Більше reasoning не завжди означає краще судження
І ні, це не похорон спек
Acceptance criteria, обмеження й розуміння правильного результату нікуди не зникли
Змінився розподіл відповідальності:
Ти більше не описуєш кожен поворот маршруту
Ти задаєш точку призначення, межі й ухвалюєш рішення, коли зʼявляються нові невідомі
А ходити територією тепер може модель
Оце для мене й є головна зміна нового покоління
Не ще одна цифра в бенчмарку, а інша межа між людиною й агентом
Ти вже змінив свій воркфлоу під Fable 5 або GPT-5.6 Sol? Чи досі приносиш їм процес, який працював із попереднім поколінням?
Цей пост - адаптація поста мого друга з LinkedIn, оригінал тут. Його думка знову зачепила настільки, що не зміг не принести її сюди
@sololemonx
Post #1749
1.85K
- 👍 4
- 👎 1
- 🔥 1