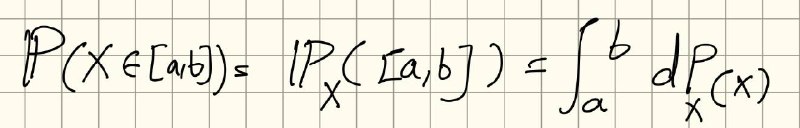نمونه گیری از توزیع گیبس
قسمت دوم: نمونه گیری در ابعاد بالا
خب بذارید کار رو با همونجایی که تموم کردیم شروع کنیم و بگیم که مفهوم حجم در ابعاد بالا خیلی عجیبه. از دبیرستان و کنکور به ما یاد دادن که حجم یه کره برابر pi *4/3* r^3 و این فرمولی بود که باید حفظش میکردیم تا جواب تست رو در کسری از ثانیه بزنیم و دل اقای کاظم قلمچی رو شاد کنیم. اما امیدوارم که در درس حسابان توی لیسانس یا بعدتر تونسته باشید مفهوم حجم رو با مفهوم انتگرالی اش بفهمید. ولی حتی اگه نفهمید نگران نباشید ما اینقدرش رو احتیاج داریم که در فضای n بعدی حجم ابرکره ما با شعاع به توان n رابطه مستقیم داره.
حالا با دونستن همین فکت ساده میتونیم یه مثال خیلی قشنگ بزنیم. بیاید در نظر بگیریم که در فضای n بعدی یه کره توپر با شعاع واحد داریم و یک پوسته نازک با ضخامت
5/n
رو ازش حذف میکنیم. به راحتی میشه نشون که اگه n بزرگتر مساوی ۵ باشه ۹۹ درصد حجم در همون نوار باریک چسبیده به پوسته قرار گرفته. توجه کنید که با بزرگتر کردن n همین طوری داره از ضخامت این گوشته کم و کمتر میشه ولی همچنان این ۹۹ درصد برقراره.
یه مثال دیگه اش اینه که شما اگه در یک بعد یه پاره خطی با طول ثابت داشته باشی و بیای این خط رو از دو طرف به همون اندازه بدی اهمیت اون پاره خط اولیه به اندازه یک سوم هست. حالا اگه همین کارو برای دو بعد انجام بدیم اهمیت اون مربع اولیه یک هشتم کل همسایگان ماست و در سه بعد یک بیست و هفتم.
این داستان در مورد کره هم برقراره شما اگه یه کره رو مثل شکل پایین در دو بعد در نظر بگیری و به اندازه ثابت به سمت داخل و خارج حرکت کنی میشه نشون داد که میزان حجم که خارج میفته به شدت بیشتر از میزان حجمی قرار میگیره که داخل میفته. انگار که حجم دارای این خاصیت هست که از مرکز فرار میکنه و میره خودشو در نقاط دورتری قایم میکنه.
ازین دست مثال های جالب و شگفت آور زیاد میشه در زمینه آمار/احتمال ابعاد بالا مطرح کرد که حتما در ادامه بعدا بهش میپردازم. اما این مثال ساده به ما اینو نشون میده که وقتی در ابعاد بالا میخوایم کار کنیم باید خیلی مراقب باشیم که منتظر چی هستیم. داستان اما مثل همیشه
از این شروع شد که چطوری از توریع گیبس نمونه برداری کنیم.
قضیه اینجا بود که ما از روش های Langevin-based خسته شدیم و رفتیم سراغ روش Hamiltonian Monte Carlo که بنظر روش بهتری میاد و در همین اثنی با ارائه آقای Bentancourt آشنا شدم که یهو یه تصویری رو نشون داد که کلا خشکم زد.
یکم که فک کردم دیدم او واقعا انگار چیز تعجب برانگیزی نیست پس چی شد که من انقدر تعجب کردم. این تصور اشتباه من دو علت اساسی داشت:
یکی شهود اشتباه در مورد مفاهیم هندسی در ابعاد بالا (که اینو تو این چند وقت اخیر سعی کرده بودم با خوندن کتاب HDP سعی کرده بودم برطرفش کنم) و اون یکی دید اشتباه بهینه سازی داشتن.
در مورد اولی یکم توضیح دادم در مورد دومی یکم منبر برم.
نکته اینه که برای نمونه گرفتن از توزیع گیبس ما داریم یه فرآیند شبیه بهینه سازی از نوع کاهش گرادیان رو انجام میدیم که حالا یکمی نویز هم قاطیش میکنیم. وبلاگی که تو پست منشن شده بهش ارجاع دادم تمام زورش رو میزنه که بگه که این نویز به ما کمک میکنه تا در اکسترمم های محلی گیر نکنیم و بتونیم اکسترمم اصلی رو پیدا کنیم و بله این دید میتونه درست باشه ولی تنها در یک بعد. نکته اینه که نمونه برداری در ابعاد بالا ما اصن نمیخوایم بریم و به نقطه اکسترمم تابع چگالی برسیم بلکه ما میخوایم دقیقا به نقاطی
برسیم که probability mass یا همون جرم احتمالی بالایی دارن. چرا؟
چون ما معمولا در آمار بیزی سعی داریم که مقدار Expected value یه تابعی رو حساب کنیم و برای این کار نقاطی که چگالی بالایی دارن مهم نیستن نقاطی که چگالی ضربدر واحد حجم رو دارن مهم هستن. حالا به همین علت اگه به probability mass توزیع گوسی نگاه کنیم(شکل بنفش) میبینیم که به سرعت حول یه نقطه ای متمرکز میشه و هی نازک نازک تر میشه این یعنی برای نمونه برداری کار سخت تر وسخت تر میشه چون باید خودت رو به یه نوار خیلی باریک برسونی.
این علتی بود که بحثمون رو در جلسه قبلی با تفاوت probability massو probability density شروع کردیم.
پس هدف اینجا بهینه سازی و یافتن بیشترین یا کمترین مقدار تابع نیست هدف تخمین زدن یه سری Expected value که برای چنین کاری بهترین نمونه ها در یک حلقه باریک در شعاع sqrt(d-1) جمع شدن و اونجا میتونی بهترین سمپل ها رو طوری پیدا کنی که مقدار متوسطشون به شدت بتونه خوب مقدار امیدریاضی رو تخمین بزنه و این همون چیزیه که در نظریه اطلاعات بهش میگن typical set.
و اما جواب سوال ها این بود که در سوال اول و دوم، تاثیر مساحت به نزدیک بودن به مرکز میچربه.
و در سوال سوم تاثیر چگالی احتمال میچربه دوباره.
@SingularThinker