TGViewer
Channel Public Channel
Симулейтив

Симулейтив

@simulative_official

Мы — образовательная платформа в сфере аналитики Симулейтив: simulative.ru

Создаём курсы-симуляторы, где обучаем на кейсах из реального бизнеса.

Канал по ML: @modprod
Наш уютный чат: @itresume_chat
Поддержка: @simulative_support
Subscribers
7.46K
Photos
2K
Videos
86
Links
1.6K

Showing posts older than #3116 · Back to latest

Older Posts 14 shown
Post #3115 901
♾ Задайте вопрос HR

На вебинаре-«прожарке» резюме мы объявили, что ответим на ваши вопросы на Q&A-сессии в соцсетях. И вот она, обещанная форма!

Напомним эксперта, который проведёт Q&A: это Наталья Рожкова, HR и карьерный консультант в Simulative. Ежедневно она помогает студентам с оформлением резюме и сопроводительных писем, а также сопровождает при трудоустройстве.

Если у вас есть вопросы по поиску работы и отдельным этапам скрининга, присылайте их в форму. 26 февраля Наталья выберет самые интересные и разберёт их здесь, в канале @simulative_official.

➡️ Можем разобрать также вашу индивидуальную ситуацию, но не забудьте приложить ссылки на резюме и портфолио.


➡️ Задать вопрос

📊 Simulative
  • ❤ 3
  • 🔥 3
Post #3114 925
Привет! Команда Simulative на связи 👋🏻

Рады представить вам нового ментора курсов «Аналитик данных» и «BI-аналитик» — это Евгений Буторин, руководитель отдела CRM-аналитики развития клиентской базы в Альфа Банке!

Несколько фактов о Евгении:

➡️ Более 5 лет в аналитике: прошёл путь от младшего аналитика до начальника отдела аналитики.

➡️ Выстраивал полный цикл взаимодействия с клиентом: от формирования реестра высокосклонных клиентов до построения аналитической воронки.

➡️ Принимал участие в интеграции BI-систем и BI отчётности — от создания витрин до построения дашбордов.

➡️ Развивал A/B-тестирование: вместе с командой разработал и внедрил стратификатор для выделения контрольных групп, эквивалентных целевой. Занимался интерпретацией результатов A/B-тестов.

➡️ Выступал заказчиком (описывал требования) для мониторинга качества данных.

➡️ Создаёт и развивает команду — от найма и онбординга до code review и взаимодействия с заказчиками.

Кроме того, Евгений — автор статей по аналитике в блоге Simulative.


❗️ Ментор — это тот, кто будет рядом на всём пути: проведёт установочную встречу, поможет на регулярных Q&A-сессиях, поделится реальным опытом и поддержит вашу мотивацию до результата.

🧡 Если хотите учиться у практиков, присоединяйтесь! Ближайший поток стартует 27 февраля: simulative.ru/data-analyst

📊 Simulative
  • 👍 4
  • 🔥 3
  • ❤ 2
Post #3113 1.07K
Какие задачи решает DL-инженер?

Привет! На связи Евгения Анкудинова, дата-сайентист в Avito и преподаватель курса «DL-инженер» 👋🏻

Вы могли слышать, что Deep Learning — это одно из направлений внутри Machine Learning. Часто может быть непонятно, чем же тогда отличаются друг от друга задачи, которые решают ML и DL-инженеры. Попробуем ответить на этот вопрос на примере стандартной задачи классификации.

DL-инженеры точно так же сталкиваются с этим типом задач. Однако детали реализации сильно зависят от того, какой тип данных необходимо классифицировать.

Допустим, вы хотите сделать маршрутизатор запросов в техническую поддержку: автоматически распределять вопросы пользователей по нужным сотрудникам. Запросы скорее всего приходят в виде текста — тогда вам подойдут NLP-модели, например, трансформеры.

😐 Хорошо, если у компании уже собрано достаточное количество данных (десятки тысяч), на которых вы можете обучить модель. Но что делать, если данных просто десятки? Тогда можно рассмотреть LLM и технику few-shot, которая позволит работать с тем набором данных, который вам доступен.

😐 Следующий шаг: LLM работают медленно. Вам может потребоваться оптимизация модели. Или можно сделать ход конём и сгенерировать данные для обучения при помощи LLM. Но как обучиться на этих ненастоящих данных так, чтобы на реальных модель работала хорошо?

Все эти вопросы и дилеммы составляют рутину решения задачи DL-инженером. Фактически ваш рабочий день состоит из разумного применения всей информации, которой вы обладаете, чтобы качественно выполнить поставленную вам задачу. И чтобы каждый пользователь всё-таки получил ответ на свой вопрос от технической поддержки 🙂

Благодаря нашему курсу «DL-инженер» вы узнаете, как подбирать архитектуру модели под вашу конкретную задачу, познакомитесь с основами оптимизации моделей и узнаете про различные подходы к решению классических и не только задач.


🔸 Записаться на курс: simulative.ru/dl-engineer

📊 Simulative
  • 🔥 4
  • ❤ 2
Post #3110 1.21K
Какие зарплаты у IT-специалистов?

Привет! На связи Мария Жарова, ментор курса «ML-инженер» 👋🏻

В своём канале я опубликовала долгожданное исследование Хабр Карьеры про зарплаты айтишников во второй половине 2025 года. Как всегда, можно посмотреть детализацию по языкам программирования, городам и направлениям, но отдельно про DS/ML снова не написали 😢

Если коротко:

😶 Интенсивный рост остановился — в совокупности во всём IT в Москве медианная ЗП поднялась на 4%; если брать все города — не более чем на 2%;
😶 В разрезе грейдов у джунов, стажёров и мидлов зарплата выросла, у сеньоров не особо, а у лидов упала. Надеюсь, те, кто выбыл из выборки, просто стали техническими директорами;
😶 Забавно, что у удалёнщиков-неджунов ЗП больше, чем у работающих в офисе! Подтверждение на последнем скрине;
😶 На графике динамики зарплат производная >0, правда уже не такая большая по модулю относительно прошлого года.

По другому свежему исследованию HH.ru, мы всё ещё сохраняем позиции в топе самых высокооплачиваемых профессий: Data Scientist занял второе место с медианной зарплатой 250 тыс. рублей после... сварщика с зарплатой 267 тысяч.

Пишите ваши варианты, что случилось с лидами и почему удалёнщики больше ценятся 😊


📊 Simulative
  • 😁 8
  • ❤ 6
  • 🔥 6
Post #3108 1.27K
Вебинар: как стать аналитиком данных к сентябрю и найти работу уже осенью 🧑‍💻

Мы знаем, что переход в новую профессию — это страшно. Поэтому приглашаем вас на вебинар, где разберём реальные бизнес-задачи, которые решает джун, и нарисуем чёткий план — что учить прямо сейчас, чтобы выйти на рынок к осени 2026.

Этот вебинар для вас, если:
😶 Вы давно смотрите в сторону аналитики, но не уверены, ваше ли это;
😶 Вы уже немного знаете SQL, но плаваете в системности и бизнес-задачах;
😶 Вы хотите понять, реально ли совмещать обучение с работой и не потерять доход;
😶 Вы планируете выйти на рынок труда к сентябрю и хотите знать точный маршрут.

🎙 Спикер: Евгений Буторин, ментор курса «Аналитик данных» — именно он поможет вам стартовать в профессии и сделать первый шаг!

Приходите, чтобы развеять страхи и уйти с понятным пошаговым планом. Увидимся в эфире!


➡️ Зарегистрироваться на вебинар

📊 Simulative
  • ❤ 6
  • 🔥 2
Post #3107 1.18K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 7
  • 🔥 4
  • 👍 1
Post #3106 1.16K
Вопрос от подписчика: насколько нужно разбираться в статистике и теории вероятностей, чтобы стать аналитиком?

Отвечает Мария Жарова 👇🏻

♾ Кстати, уже сегодня стартует поток курса «ML-инженер» с её менторской поддержкой! Присоединяйтесь: simulative.ru/ml-engineer


📊 Simulative
  • 🔥 5
  • ❤ 3
Post #3105 1.13K
Решаем задачи по SQL через пару часов

Евгений Буторин, ментор курса «Аналитик данных», ждёт вас на вебинаре, где мы посмотрим, в каких задачах студенты совершают ошибки чаще всего, и научимся собирать SQL-запросы за 30 секунд 🧡

➡️ Регистрируйтесь!

📊 Simulative
  • ❤ 8
  • 🔥 6
  • 👍 2
Post #3104 1.09K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 6
  • ❤ 4
  • 👍 2
Post #3100 1.14K
Как аналитики используют ИИ: 3 примера

Привет! На связи Марина Ермак, автор курса «ИИ для анализа данных» 🚀

Приведу несколько примеров, как можно использовать нейросети на реальных задачах аналитика, вместе с ответами нейросети в карточках:

1️⃣ Поиск и анализ по документу

Мы загружаем документацию/заметки со встречи/etc. в нейросеть, затем задаём вопросы по содержанию. Например:

Кластеризуй предложения со встречи по тематическим группам и приведи точные цитаты для каждой группы. Важно, чтобы все цитаты были упомянуты.

На основе прикреплённых файлов сделай саммари и найди все упоминания следующих трендов: <тренд 1>, < тренд 2>, … Приводи точные цитаты.


2️⃣ Генерация SQL-запроса по описанию базы данных и сути задачи

Описываем, какая у нас архитектура БД и таблиц, которые нам нужны в запросе, затем саму суть запроса. Например:

Напиши мне SQL-запрос под задачу:

Найдите максимальный возраст (количество лет) среди обучающихся 10 классов на сегодняшний день. Для получения текущих даты и времени используйте функцию NOW().

Схему БД прикрепляю на скрине.


3️⃣ Регулярное исследование трендов (ChatGPT)

Например:

Проведи исследование по современным трендам в мире финтеха и банкинга в России и в Европе/США.


Как видите, использовать нейросети можно в абсолютно разных задачах и процессах. Делитесь в комментариях, какие задачи вы бы хотели автоматизировать (или уже отдаёте ИИ) — в следующих постах разберём их подробнее ♾


📊 Simulative
  • 🔥 10
  • ❤ 5
  • 👍 1
Post #3099 909
4 признака, что ваша карьера аналитика зашла в тупик

Вы регулярно делаете однотипные отчёты, но зарплата и задачи не растут? Возможно, вы застряли в профессиональном тупике. Проверьте себя по этим 4 признакам:

1️⃣ Вы пользуетесь одним инструментом

Например, вы виртуозно работаете в Excel или пишете сложные SQL-запросы. Но стоит в вакансии увидеть Airflow или требования к настройке дашбордов в Power BI/Metabase — вы пролистываете её.

Проблема в том, что рынок всё реже ищет узких исполнителей — ему нужны универсалы, которые могут собрать пайплайн, проанализировать данные и визуализировать результат.


2️⃣ Вы не видите бизнес-задачу

Вам ставят ТЗ: «Сделайте выгрузку по продажам за квартал». Вы делаете, но зачем? Вы не спрашиваете и не знаете — вы исполнитель запросов, а не партнёр для бизнеса. Такой специалист не может влиять на решения и, как следствие, на свой доход.


3️⃣ Ваш анализ никогда не превращается во внедрение

Вы нашли инсайт, показали его руководителю — и на этом всё закончилось. Вы не умеете упаковывать анализ в работающее, регулярное решение. А значит, ваша ценность для компании остаётся низкой.


4️⃣ У вас нет целостного портфолио «под ключ»

Нет ни одного примера, где бы вы полностью прошли путь: настройка хранилища, сбор и обработка данных, анализ и визуализация, автоматизация отчёта. Именно такое портфолио сейчас убеждает работодателей больше, чем диплом.


🫸🏻 Как сломать потолок? Стать fullstack-аналитиком, универсальным специалистом, который закрывает весь цикл работы с данными. Именно таких мы готовим на нашем курсе.

За 17 месяцев вы не просто изучите стек, а выполните 90+ проектов, собрав готовое портфолио «под ключ». Вы научитесь:

➖ Видеть задачу от бизнес-вопроса до внедрения;
➖ Автоматизировать рутину и строить аналитические пайплайны;
➖ Говорить с бизнесом на его языке, предлагая решения.

🪟 Прорваться сквозь потолок: simulative.ru/fullstack-analyst

📊 Simulative
  • ❤ 4
  • 🔥 3
  • 👍 1
Post #3098 932
Симулейтив Мы готовы к «прожарке» резюме, а вы? Присоединяйтесь к вебинару 18 февраля, где HR-эксперт Наталья Рожкова разберёт ваши резюме и сопроводительные письма, оценит их глазами рекрутера и покажет, какие ошибки мешают получить оффер. На вебинаре вы: ➖ Посмотрите…
«Прожариваем» ваши резюме уже через 2 часа!

Вас ждёт полноценный разбор четырёх резюме и сопроводительных писем от подписчиков, а также общие ошибки и советы, которые помогут вам получить заветный оффер.

➡️ Регистрация на вебинар

📊 Simulative
  • ❤ 5
  • 🔥 3
Post #3093 1.1K
Как ускорить обработку больших датафреймов в pandas

Привет! На связи Мария Жарова, ментор курса «ML-инженер» 👋🏻

Представьте ситуацию: ваш DataFrame на несколько миллионов строк, и обычные операции вроде apply или groupby становятся ужасно медленными… Причина проста — обычный pandas работает только на одном ядре процессора. Но есть и хорошие новости — можно разогнать обработку данных в разы, если делать это параллельно!

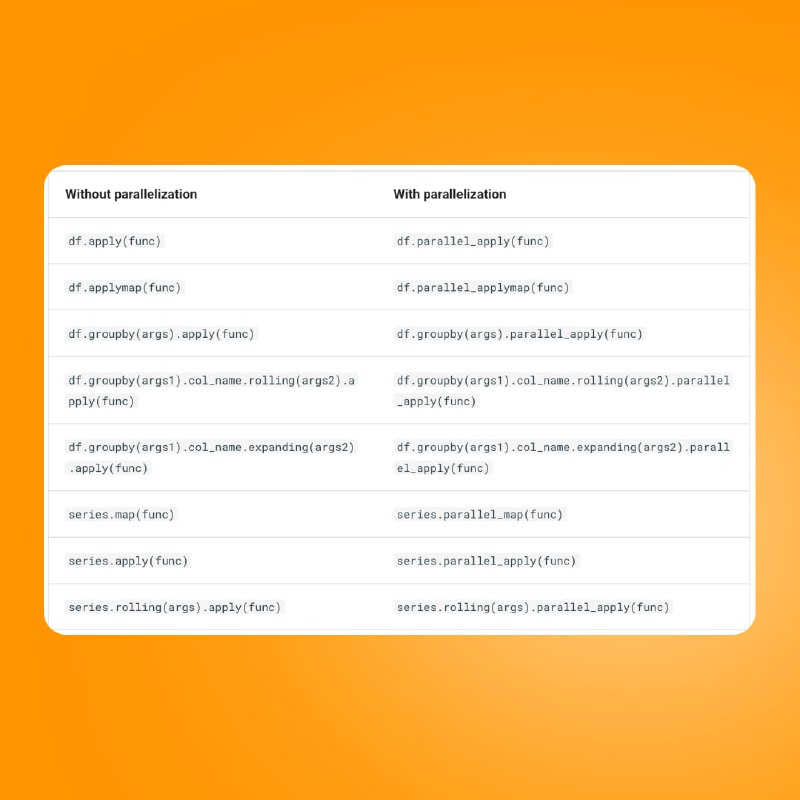
В этом поможет библиотека Pandarallel — она позволяет распараллеливать привычные методы pandas, задействуя все ядра вашего компьютера.

Что умеет Pandarallel:

🟠 Параллельный аналог apply — parallel_apply;
🟠 «Параллельная» версия map — parallel_map;
🟠 Ускоренный groupby через parallel_apply;
🟠 Ускоренный rolling также через parallel_apply.

Мы попробовали на тестовом датасете — и получили кратное ускорение, результаты смотрите на скринах. Или попробуйте сами:

# установка библиотеки
# pip install -q pandarallel

from pandarallel import pandarallel
import pandas as pd

# инициализация библиотеки
pandarallel.initialize(progress_bar=True)

# тестовый датасет
df = pd.DataFrame({
'A': range(1, 1000001),
'B': range(1000001, 2000001)
})

def add_columns(row):
'''тестовая функция для apply'''
return row['A'] + row['B']

df['C'] = df.parallel_apply(add_columns, axis=1)

def multiply_by_two(x):
'''тестовая функция для map'''
return x * 2

df['D'] = df['C'].parallel_map(multiply_by_two)


Официальная документация тут: Pandarallel 😎

А на последнем скрине оставлю весь список возможностей библиотеки и как их реализовать.

Ставьте ❤️, если было полезно — и сохраняйте, чтобы не потерять!

📊 Simulative
  • ❤ 12
  • 🔥 12
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →