


Привет! На связи Мария Жарова, ментор курса «ML-инженер» 👋🏻
Представьте ситуацию: ваш DataFrame на несколько миллионов строк, и обычные операции вроде
apply или groupby становятся ужасно медленными… Причина проста — обычный pandas работает только на одном ядре процессора. Но есть и хорошие новости — можно разогнать обработку данных в разы, если делать это параллельно!В этом поможет библиотека Pandarallel — она позволяет распараллеливать привычные методы pandas, задействуя все ядра вашего компьютера.
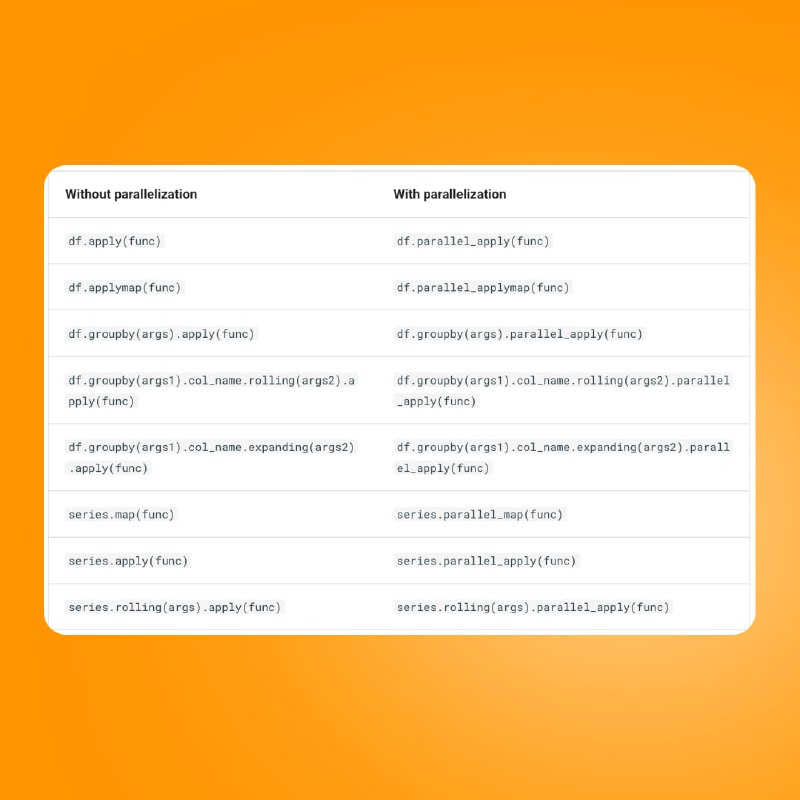
Что умеет Pandarallel:
🟠 Параллельный аналог
apply — parallel_apply;🟠 «Параллельная» версия
map — parallel_map;🟠 Ускоренный
groupby через parallel_apply;🟠 Ускоренный
rolling также через parallel_apply.Мы попробовали на тестовом датасете — и получили кратное ускорение, результаты смотрите на скринах. Или попробуйте сами:
# установка библиотеки
# pip install -q pandarallel

from pandarallel import pandarallel
import pandas as pd

# инициализация библиотеки
pandarallel.initialize(progress_bar=True)

# тестовый датасет
df = pd.DataFrame({
    'A': range(1, 1000001),
    'B': range(1000001, 2000001)
})

def add_columns(row):
    '''тестовая функция для apply'''
    return row['A'] + row['B']

df['C'] = df.parallel_apply(add_columns, axis=1)

def multiply_by_two(x):
    '''тестовая функция для map'''
    return x * 2

df['D'] = df['C'].parallel_map(multiply_by_two)
Официальная документация тут: Pandarallel 😎
А на последнем скрине оставлю весь список возможностей библиотеки и как их реализовать.
Ставьте ❤️, если было полезно — и сохраняйте, чтобы не потерять!
📊 Simulative