
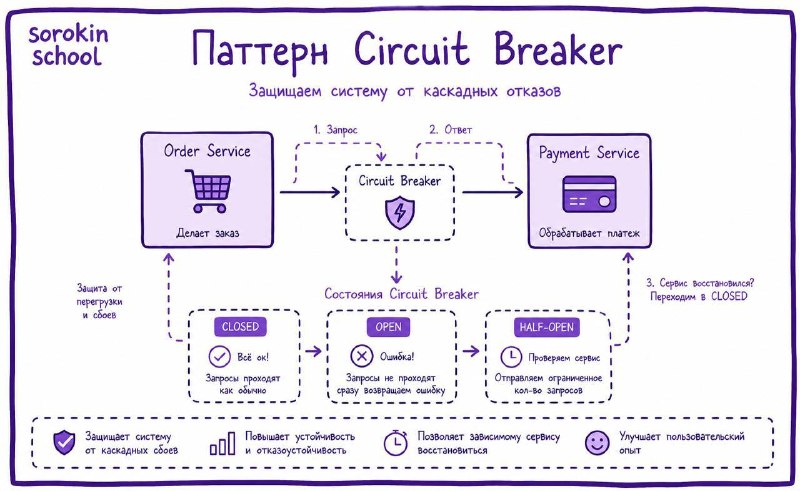
Мы чаще всего работаем с распределенной системой, и постоянно случаются проблемы - лег смежный сервис, ресурсы закончились, коннекты к базе уперлись, всплеск трафика, уборщик случайно задел кабель и отключил ДЦ от питания
Типичная ситуация:
«Мы просто кинем запрос в другой сервис по HTTP»
А потом этот сервис начинает отвечать не 100 мс, а 5 секунд. Потом вообще перестаёт отвечать. И если наш сервис продолжает стучаться в падающий сервис, то может быть ряд проблем из-за этого
1️⃣ Мы своими руками добиваем бедолагу
Сервис уже лежит, а мы такие: «Ну-ка, вставай» и добиваем его своими ретраями сверху. В итоге очередь запросов у него растет, нагрузка на него растет. Он пытается рестартануть и мы его снова добиваем
2️⃣ У нас забивается пул потоков
Пока мы ждем долгого ответа, у нас самих висят потоки и забиваются connection pool’ы. И все это время пока потоки висят - новые запросы-то не обрабатываются
И теперь наши клиенты начинают падать по timeout’ам
В итоге в системе один сервис упал, а через пару минут уже лежит вся система. Это называется каскадный сбой. Отказ одного компонента начинает приводить к отказам других частей
Например:
Order Service → Payment Service → Bank API
Если
Bank API начал тупить, Payment Service ждёт. Order Service ждёт Payment Service. Пользователь ждёт Order Service 😱😱😱❗️При таких ситуациях лучше вообще НЕ ходить по сети во внешний сервис, если мы точно знаем, что ему плохо
Если случайно упал один запрос из 1000, например сеть оборвалась, то это ОК, просто погрешность
→ просто делаем retry. Но если падает 50 из 100 запросов, то сервису явно плохо и нужно подождать его восстановления🟪 Circuit Breaker - это паттерн, который временно блокирует вызовы к нестабильному сервису, если тот начал часто падать или тормозить
По сути это просто предохранитель, который вырубает трафик, если замечает сбой
У Circuit Breaker обычно три состояния
🟣Closed - всё нормально. Запросы проходят во внешний сервис, а breaker просто считает кол-во ошибок
Order Service → Payment Service
🟣 Open - сервис явно болеет. Breaker «размыкается» и больше не пускает запросы во внешний сервис. Сразу возвращается ошибка, нет похода в сеть
❗️ Мы не тратим ресурсы на заведомо мертвый вызов и не добиваем сервис, который уже лежит
🟣Half-Open - тестовый режим
Через некоторое время breaker пропускает несколько пробных запросов. Если они успешные - возвращаемся в
Closed. Если опять ошибки - обратно в OpenПример состояний:
Closed → много ошибок → Open
Open → подождали → Half-Open
Half-Open → успех → Closed
Half-Open → ошибки → Open
Все эти переходы настраиваются. Мы сами задаем, какой процент ошибок считать критичным, сколько запросов смотреть в окне, сколько держать breaker в Open и сколько пробных вызовов пустить в Half-Open
🤔 А что делать, если сервис упал?
Ответ: деградировать 🙃
Систему стоит изначально проектировать с учетом, что запрос может отвалиться. Почти всегда лучше ответить хоть как-то, чем не ответить никак.
Что можно делать:
• Просто сказать клиенту «извини, вот держи
• Возвращать последний известный корректный результат, который система может вернуть из кэша LKG (last-known-good)
• Возвращать заглушки или успешно принимать запрос, но обрабатывать его позже асинхронно.
👉 Circuit Breaker часто используют в связке с retry паттерном
Retry: «попробуй ещё раз»
Circuit Breaker: «хватит пробовать, чудик»
Retry полезен при кратковременных сбоях: сеть моргнула, случайный timeout. Но если сервис реально лежит, retry только увеличит нагрузку
Поэтому нормальная схема обычно такая: timeout, ограниченный retry с backoff, circuit breaker и fallback.
❓ На собеседованиях по этой теме часто задают такие вопросы:
• что такое Circuit Breaker?
• какие у него состояния?
• зачем нужен Half-Open?
• чем он отличается от Retry pattern?
• что такое fallback?
• как он защищает от каскадных сбоев?
Накидай 🔥, если рассказать больше о паттернах, а в комментах напиши, какие из них вызывают больше всего вопросов