Мы уже разбирали
паттерны микросервисов, это часть 2
Есть ещё 5 ребят, без которых распределённая система тоже довольно быстро превращается в квест «почему вчера работало, а сегодня 502?»
🟣
API GatewayПока у тебя один сервис, всё просто: фронт знает один адрес и ходит туда
Но когда появляются
order-service,
payment-service и ещё несколько ребят, фронту внезапно нужно знать их адреса, правила авторизации и что делать, если один сервис переехал, тут и нужен
API GatewayКлиент ходит в одну точку, а Gateway сам роутит запрос дальше, туда же удобно вынести авторизацию, логирование и т.п
🆗
Плюсы: единая точка для общих инфраструктурных политик и скрытие топологии
🙅♂️ Цена: отдельный критичный сервис, если напихать бизнес-логику - получится монолит на входе
🟣
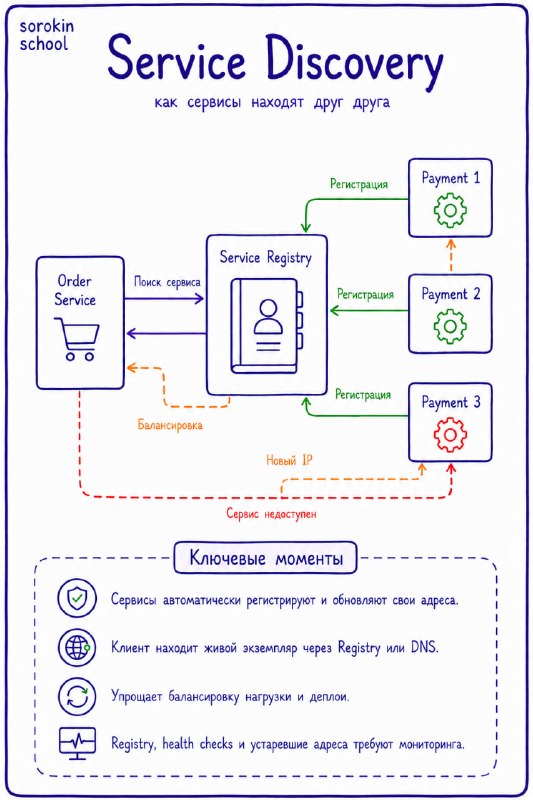
Service DiscoveryВ микросервисах сервисы постоянно появляются, масштабируются, переезжают на другие инстансы. Сегодня у
payment-service 2 экземпляра, через час - 5, один из них упал, другой задеплоился с новым IP. А
order-service всё ещё должен понимать, куда отправлять запрос
Поэтому нужен
Service Discovery - телефонная книга сервисов. В варианте с отдельным registry сервисы регистрируют свои адреса, а остальные получают их оттуда
Но если приложение работает в k8s, эту задачу обычно берёт на себя сам кубер: сервису даётся постоянное DNS-имя, а CoreDNS помогает найти его адрес. Экземпляры могут появляться, падать и менять IP - другим сервисам не нужно вручную отслеживать эти изменения
🆗
Плюсы: не прописываем IP руками, проще балансировать нагрузку и переживать деплои
🙅♂️
Цена: ещё один инфраструктурный слой, адреса могут устаревать, registry тоже надо мониторить
🟣
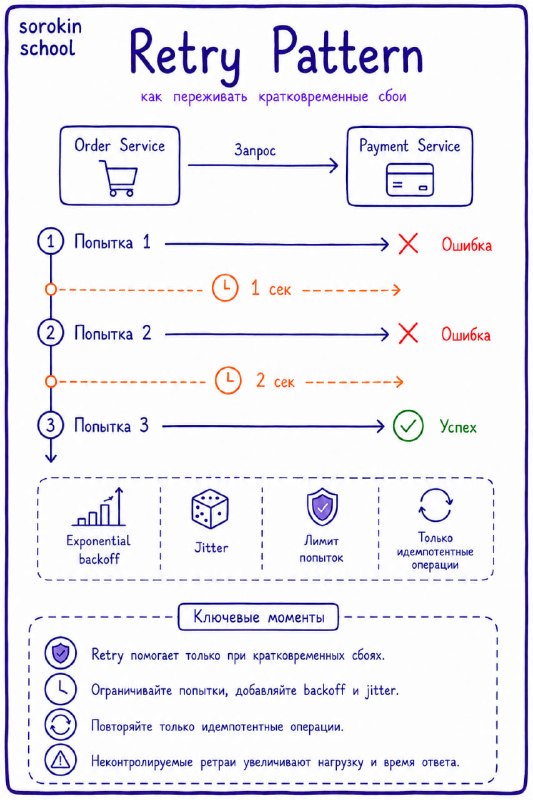
RetryЕсли запрос не проходит - попробуем ещё раз, ну логично же. Сеть моргнула, сервис кратко завис и повторный вызов действительно может спасти ситуацию, но если сервис уже лежит, а 1000 клиентов делает по 3 повтора, retry превращается в «давайте добьём его окончательно»
Поэтому этот паттерн надо использовать для коротких сбоев, а не как способ бесконечно верить в лучшее. Нормальный retry - это ограниченное число попыток, timeout,
exponential backoff и
jitter, я кстати подробно о нем рассказывал в этом
посте
❗️И ретраить можно ТОЛЬКО
идемпотентные операции, иначе повторно выполнится операция (
писал тут)
🆗
Плюсы: система переживает случайные флапы без ошибки для клиента
❌
Цена: лишняя нагрузка и более долгий ответ пользователю
🟣
Rate LimitingЕсть сервис, который может обработать 1 000 запросов в секунду. И тут приходит один очень мотивированный клиент, бот или просто фронт с багом и начинает присылать 20 000 запросов
На публичном API и тяжёлых операциях вроде логина или построения отчётов это вопрос не «если», а «когда это случится». И тогда rate limiting говорит:
Больше N запросов за период не принимаем
Ограничивать эти запросы можно по IP, пользователю, API key или конкретному endpoint’у. Кстати, в моём курсе по Redis на
YouTube мы пишем свой rate limiter
✅
Плюсы: один клиент не съест все ресурсы, нагрузка становится предсказуемее
❌ Цена: нужно решить, кого ограничивать, можно случайно задеть нормального пользователя
🟣
BulkheadНазвание пришло из кораблей, где его делят на герметичные отсеки: если один затопило, то весь корабль не обязан идти ко дну
В сервисе то же самое, например,
order-service ходит в платёжку, доставку и рекомендации→ рекомендации начали отвечать по 20 секунд и забили общий пул потоков→ в итоге перестали создаваться заказы
Когда один сервис зависит сразу от нескольких внешних систем, а падение одной не должно валить остальные, нужен Bulkhead. Он выделяет каждой зависимости отдельный пул потоков, очередь или лимит запросов
🆗
Плюсы: частичная авария не превращается в полную
🙅♂️
Цена: больше ресурсов и сложнее настройка, если неправильно нарезать пулы - можно сделать новые бутылочные горлышки
Все эти паттерны появляются, когда система уже успела сделать что-то ну очень неприятное. Кстати, я готовлю большой материал по микросервисам, напиши, какие вопросы по ним возникают
#хардовая_польза