NVIDIA вот-вот выпустила новую опенсорс модель для транскрипции Nemotron Speech ASR, спроектированную с нуля под low-latency сценарии, вроде голосовых агентов.
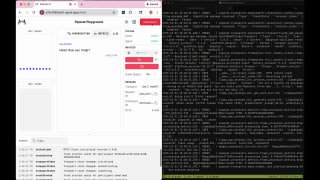
Вот пример голосового агента, собранного на этой модели. Финализация транскрипции занимает 24 мс, а общее voice-to-voice время инференса меньше 500 мс.
Этот агент на самом деле использует сразу три open source модели от NVIDIA:
- Nemotron Speech ASR
- Nemotron 3 Nano 30GB в 4-битной квантизации (вышла в декабре)
- превью-чекпойнт будущей модели Magpie для text-to-speech
Все эти модели реально открытые: доступны веса, обучающие данные, код обучения и код инференса. Это важно. Вчера на CES Дженсен сказал, что в этом году open source модели догонят проприетарные по ряду направлений. NVIDIA явно делает ставку на то, чтобы это произошло. Как говорил Алан Кей, лучший способ предсказать будущее — это изобрести его.
Код самого агента тоже open source. Его можно задеплоить в прод через cloud от modal и pipecat_ai или запускать локально на nvidia DGX Spark или RTX 5090.
Вот
технический разбор голосового агента из видео выше: как он устроен, какие три модели NVIDIA используются, как выкатить это в прод и какие есть интересные оптимизации, если гонять всё локально на одной GPU.
Весь код здесь:
тутЗадеплоить эти модели в cloud от modal можно очень просто. (DX у Modal реально приятный.)
Для локального запуска придется собрать Docker-контейнер — ну, потому что bleeding edge vLLM, llama.cpp, CUDA под Blackwell и всё такое. Но Dockerfile в репозитории должен без проблем заводиться на DGX Spark и RTX 5090.
👉
@PythonPortal PY