TGViewer
Channel Public Channel
About Python [ru]

About Python [ru]

@python_tesst

Пишем на Python, создаём нейросети и ИИ-агентов.
Алгоритмы, задачи и вайбкодинг.

Личный блог автора - @just_genych
По вопросам рекламы или разработки: @g_abashkin
Subscribers
6.45K
Photos
470
Videos
13
Links
2.1K

Showing posts older than #2767 · Back to latest

Older Posts 20 shown
Post #2766 416
⁣Паттерн Saga: распределённые транзакции без двухфазного коммита

Двухфазный коммит (2PC) в микросервисах приводит к блокировкам, единой точке отказа и проблемам с масштабированием. Saga заменяет его цепочкой локальных транзакций с компенсирующими действиями на каждый шаг.

Хореография против оркестрации

Хореография — сервисы сами общаются через события. Просто, но сложно трассировать цепочку. Оркестрация — выделенный координатор управляет шагами (через RabbitMQ, Kafka или HTTP). Для production выбирайте оркестрацию: она проще в отладке и масштабировании.

Типичная ошибка

Компенсации часто реализуют как простой rollback. Но в микросервисах отменить факт записи в базу без side-эффектов невозможно. Компенсация — это бизнес-логика, а не техническая отмена. Пример: отмена брони отеля должна послать запрос на освобождение номера, а не вызывать SQL rollback.

Production-пример и код

Рассмотрим бронирование отеля и авиабилета. Шаг 1 — бронь отеля, шаг 2 — билет. Если билет не прошёл, отменяем бронь отеля. Вот урезанный пример координатора:

class SagaCoordinator:
def __init__(self, steps: list["Step"]):
self._steps = steps
self._executed: list["Step"] = []

async def run(self):
for step in self._steps:
try:
await step.action()
self._executed.append(step)
except Exception:
for executed in reversed(self._executed):
await executed.compensation()
raise


Код не готов к production: нет идемпотентности, ретраев, durable storage. В реальном проекте состояние координатора хранят в PostgreSQL или Redis с сохраняемыми очередями.

Инженерные trade-offs

Saga — это eventual consistency. Какое-то время данные могут быть несогласованными. Если клиент прочитает частичный результат (например, отель забронирован, а билет нет), будет баг. Нужна либо read-side согласованность, либо флаг временного состояния.

Практический совет

Компенсации делайте идемпотентными на уровне бизнес-логики: два вызова отмены брони не должны создавать двойную запись. Для внешних API добавляйте timeout и fallback. Если компенсация упала, используйте dead letter queue и ручной джобу для доотмены.

Предупреждение

Главный подвох: компенсации тоже могут падать. Без retry и DLQ данные зависнут в неконсистентном состоянии. Не забывайте про мониторинг состояния Saga и алерты на долгие цепочки.

Вывод: Saga — это практичный паттерн для микросервисов, требующий тщательной реализации компенсаций, идемпотентности и durable состояния координатора для избежания неконсистентности.
Post #2763 447
⁣Профилирование async-генераторов: GC-latency, HWM и паттерны утечки корутин в high‑load FastAPI‑сервисах

В продакшене async-генераторы часто воспринимаются как идеальный механизм для стриминга больших данных. Но при анализе p99 latency я обнаружил, что основной источник задержек — не медленные запросы к БД, а скрытые проблемы с утечками корутин и сборкой мусора.

Проблема 1: GC-latency при разрыве соединения

Когда клиент прерывает соединение, async-генератор продолжает висеть с циклическими ссылками. Поколенческий сборщик мусора начинает аварийные сборки, и latency может улетать за секунду.

async def stream_data():
for i in range(10**6):
yield await fetch_chunk(i)


Утечка: клиент ушёл, но генератор не завершён. Решение — finally с aclose() или обёртка через @contextlib.asynccontextmanager. Правило: если ты не контролируешь время жизни генератора, контролируй очистку.

Проблема 2: HWM (high water mark) и резервирование стека

Каждый async-генератор резервирует стек корутины при создании. В проде с тысячами одновременных запросов это даёт ощутимый overhead. Для профилирования используйте gc.get_objects() с фильтром на AsyncGeneratorType:

import gc, types
from collections import Counter

gen_count = Counter()
for obj in gc.get_objects():
if isinstance(obj, types.AsyncGeneratorType):
gen_count[type(obj).__name__] += 1


Рост счётчика — явный признак утечки. HWM можно оценить через sys.getsizeof(), но лучше фокусироваться на количестве живых генераторов.

FastAPI-specific паттерны утечек

На ревью часто вижу три типичные ошибки:
- Тайм-ауты: FastAPI отменяет задачу, но aclose() не вызывается.
- Циклические ссылки: генератор держит request-объект, GC в тупике.
- SSE-генераторы, висящие вечно, если клиент не закрыл соединение.

В продакшене включаю PYTHONASYNCIODEBUG=1 для ловли Task was destroyed but it is pending. В тестовых средах — gc.set_debug(gc.DEBUG_LEAK). Для стриминга FastAPI использую шаблон с aclosing:

from contextlib import aclosing

async def safe_stream():
async with aclosing(async_generator()):
async for item in async_generator():
yield item


Практический совет: всегда оборачивайте async-генераторы в контекстный менеджер с гарантированным вызовом aclose(). Это снижает p99 latency на сотни миллисекунд.

Вывод:
Один забытый async-генератор в high-load FastAPI-сервисе способен превратить стриминг в источник неконтролируемых задержек, поэтому профилирование GC и утечек корутин — обязательный шаг при оптимизации latency.
Post #2762 415
⁣asyncio зависает без ошибок? TaskGroup, timeout-декораторы и context vars для надежного трейсинга

Когда asyncio-задача “зависает”, стектрейс часто пуст или уводит в Event Loop. В production с многотысячными коннектами это тихая катастрофа: задача не падает, но и не завершается, ресурсы утекают. Разбираем три приёма, которые превращают отладку из гадания в детерминированный процесс.

TaskGroup и asyncio.timeout: границы времени жизни
С asyncio.TaskGroup (Python 3.11+) каждая задача имеет явный контекст. Комбинируя его с asyncio.timeout, получаем детектор зависаний:

async def safe_polling():
async with asyncio.TaskGroup() as tg:
async with asyncio.timeout(5.0):
task = tg.create_task(long_pipeline())


Плюс: при превышении лимита – TimeoutError с отменой корутины. Минус: нужно явно оборачивать каждую группу.

Timeout-декоратор: защита на уровне функции
Для всех внешних вызовов (API, базы, очереди) декоратор автоматически ставит таймаут:

import asyncio
from functools import wraps

def timeout(max_time: float):
def decorator(coro):
@wraps(coro)
async def wrapper(*args, **kwargs):
try:
return await asyncio.wait_for(
coro(*args, **kwargs), timeout=max_time)
except asyncio.TimeoutError:
log.warning(f"{coro.__name__} exceeded {max_time}s")
raise
return wrapper
return decorator

@timeout(3.0)
async def fetch_external_data(): ...


asyncio.wait_for корректно отменяет корутину, не оставляя её в состоянии “in progress”.

Context Vars для трейсинга: кто вызвал задачу
contextvars.ContextVar хранит идентификатор запроса или таски. При таймауте логгер выводит полную цепочку:

request_id = contextvars.ContextVar('request_id', default=None)

async def handler(call_id: str):
request_id.set(call_id)
async with asyncio.TaskGroup() as tg:
tg.create_task(process())


В логах видно request_id зависшей задачи — это ключ к поиску в трейсинге (OpenTelemetry, Jaeger).

Что ещё проверить

* Блокирующий синхронный код (requests.get вместо aiohttp)?
* Забытый await – asyncio пускает корутину без ошибки.
* Обилие таймаутов на разных уровнях: один для HTTP, другой для всей группы.

Вывод:
Замороженные asyncio-задачи отлавливаются только комбинацией явных границ времени (TaskGroup + timeout) и трейсинга исполнения (context vars), а не надеждой на “авось завершится”.
Post #2761 412
⁣Многопоточная обработка in-memory данных с нулевым копированием: memoryview и буферы numpy

Когда несколько потоков читают одни и те же данные, первое, что приходит в голову — скопировать каждый кусок отдельно. Потом смотришь на профилировщик и видишь, что 40% времени ушло на эти копирования. В production это убивает производительность в задачах обработки видео, аудио или бинарных протоколов.

Буферный протокол и memoryview

Memoryview и буферный протокол numpy позволяют читать одни и те же данные из разных потоков без единого лишнего байта. Берём bytearray на миллион байт, создаём memoryview, режем на куски и отдаём потокам. Каждый поток через np.frombuffer получает ndarray, который смотрит ровно в ту же память.

import numpy as np
import threading

shared_data = bytearray(1_000_000)
shared_view = memoryview(shared_data)

def process_chunk(offset, size):
chunk = np.frombuffer(shared_view[offset:offset+size], dtype=np.uint8)
chunk[:] = (chunk * 2 + 10) % 256

threads = []
chunk_size = 100_000
for i in range(0, len(shared_data), chunk_size):
t = threading.Thread(target=process_chunk, args=(i, chunk_size))
threads.append(t)
t.start()

for t in threads:
t.join()


Ключевой момент: GIL снимается, когда numpy вызывает C-код. Поэтому CPU-bound задачи с numpy действительно ускоряются в потоках, и не надо сразу лезть в multiprocessing.

Ограничения и типичная ошибка

Memoryview работает только с contiguous буферами. Если массив со stride — приходится делать np.ascontiguousarray, а это уже копия. По опыту, чаще всего данные из файлов или сети идут подряд, так что проблема не смертельная. Типичная ошибка — забыть проверить, что буфер contiguous, и получить неявную копию.

Оптимизация для numpy

Если данные уже лежат в numpy, можно не создавать memoryview. У ndarray есть буферный протокол, и np.frombuffer скушает его напрямую. Меньше телодвижений, но проверка на contiguous всё равно нужна.

Где это выстреливает в production

Это реально ускоряет: обработка видео в реальном времени, аудиофреймы, высокочастотные тикеры, разбор бинарных протоколов, чтение больших HDF5 и FASTQ. Везде, где данных много, а копировать их больно.

Вывод:
Нулевое копирование через memoryview и буферы numpy — ключ к ускорению многопоточных in-memory задач, но только с contiguous буферами и пониманием, что GIL снимается в C-коде.
Post #2759 401
⁣Clock Skew в распределённых Python-системах: NTP не панацея

Время в распределённой системе — штука хитрая. Даже если на всех узлах крутится NTP, погрешность в локальной сети легко даёт 1–50 мс. В облаке может быть хуже. И это не баг, а особенность: clock drift накапливается. Проблема в том, что time.time() и datetime.now() — это по сути случайные числа, когда нужно упорядочить события с разных машин. Сравнил два timestamp с разных узлов и получил бороду.

Логические часы Лэмпорта
Первый вариант — каждый узел хранит счётчик, инкрементит на каждом событии. Просто, дёшево, но от физического времени отрываешься полностью. Иногда это ок, но для многих сценариев (например, метрик с временными метками) нужна привязка к реальному времени.

Гибридные логические часы (HLC)
Более живой вариант — скрещиваешь физическое время с логическим счётчиком.

class HLC:
def __init__(self, node_id, max_drift=50e-3):
self.node_id = node_id
self.max_drift = max_drift
self.l = 0
self.pt = time.time()

def now(self):
now_pt = time.time()
if now_pt > self.pt + self.max_drift:
self.l = 0
self.pt = now_pt
else:
self.l += 1
return (self.pt, self.l, self.node_id)

def receive(self, msg_time):
now_pt = time.time()
if now_pt > self.pt and now_pt > msg_time[0]:
self.l = 0
self.pt = now_pt
else:
self.l = max(self.l, msg_time[1]) + 1
self.pt = max(self.pt, msg_time[0])


Ключевая идея: если физическое время ушло вперёд больше чем на max_drift — сбрасываешь счётчик. При получении сообщения берёшь максимум из локального времени и времени отправителя. Работает как в Cassandra, Spanner.

Как измерять skew
Типичная ошибка — полагаться на time.time() без мониторинга. Бери ntplib, дёргай общий пул, смотри разброс. Или используй tcpdump на RTT между узлами. На одном узле — time.monotonic() для интервалов, чтобы не зависеть от перевода часов.

Практический совет: вычитай медиану skew из всех меток. Для критичных операций — голосование за "истинное время", как TrueTime в Spanner.

Когда без этого никак
Детерминированное воспроизведение событий в отладке, conflict resolution в CRDT на основе timestamp, синхронизация транзакций в многомастерной репликации. В production это разница между "работает" и "работает надежно".

Вывод: Clock skew — не баг, а инженерная задача, которую решают гибридные логические часы и мониторинг смещения, а не слепая вера в NTP.
Post #2758 405
⁣Zero-Copy инференс ONNX в Python: убиваем лишние копирования

При развертывании ONNX-моделей в production каждая микросекунда на счету. Часто узким местом становится не сам инференс, а оверхэд на передачу данных между Python и C++ рантаймом ONNX Runtime. Решение — zero-copy тензоры.

По умолчанию ONNX Runtime (ORT) делает копию входных тензоров из numpy-массивов в свой внутренний формат. Для больших батчей это может добавить 10-30% времени к инференсу. Я наступал на эти грабли: модель считает 5 мс, а общее время запроса — 7 мс, и ты гадаешь, куда утекает.

Как работает zero-copy с OrtValue

Вместо ort_session.run(None, {'input': numpy_array}) можно передавать OrtValue напрямую:

import onnxruntime as ort
import numpy as np

input_data = np.random.randn(1, 3, 224, 224).astype(np.float32)
ort_input = ort.OrtValue.ort_value_from_numpy(input_data)

session = ort.InferenceSession('model.onnx')
results = session.run_with_ort_values({'input': ort_input})
output_tensor = results[0].numpy()


Тут есть нюанс: run_with_ort_values возвращает OrtValue, и .numpy() может вернуть view на те же данные с нулевым копированием, если тензор выровнен.

Переиспользование буфера для максимальной производительности

Чтобы минимизировать оверхэд еще сильнее, можно выделить буфер один раз и переиспользовать его:

buffer_np = np.empty((1, 3, 224, 224), dtype=np.float32)
buffer_ort = ort.OrtValue.ort_value_from_numpy(buffer_np)

# В цикле инференса
np.copyto(buffer_np, new_input_data)
results = session.run_with_ort_values({'input': buffer_ort})


Замерил на batch_size=1, 1000 запросов, ONNX Runtime 1.18:
- Стандартный run: 2.1 мс на запрос (включая 0.3 мс на копирование)
- Zero-copy с OrtValue: 1.8 мс (копирование 0 мс)
- + предварительная аллокация: 1.7 мс

Zero-copy дает около 15% ускорения. Для высоконагруженных сервисов это уже заметно.

Типичная ошибка: когда zero-copy не сработает

Если входной тензор не выровнен (non-contiguous) — ORT сделает copy. Спасает np.ascontiguousarray(). Если модель меняет форму тензора на входе — копирование неизбежно, тут ничего не поделать.

Рекомендации для прода

- Используйте OrtValue.ort_value_from_numpy() вместо run().
- Переиспользуйте OrtValue-буферы.
- Включайте ort.SessionOptions().enable_cpu_mem_arena = True.

Не ждите чуда, но 15% выньете просто так.

Вывод:
Zero-copy с OrtValue и переиспользование буферов — простой и надежный способ снизить latency инференса ONNX-моделей на 10-15% без изменения архитектуры.
Post #2757 411
⁣Конфиг, который не ломается: строгая типизация, секреты и валидация runtime-параметров

В production конфиг часто выглядит как мешанина os.environ с копипастой и опечатками в именах переменных. Это прямой путь к ошибке при старте или утечке секрета в лог через config.dict(). Pydantic Settings v2 решает это одним классом — с типизацией, дефолтами и валидацией на этапе инициализации.

Контроль типов и дефолтов

Вы описываете структуру конфига, и если переменная не задана без дефолта — приложение не запустится. Это исключает runtime-сюрпризы. SecretStr прячет секреты в repr: даже при выводе объекта в лог api_key отображается только звездочками.

class AppConfig(BaseSettings):
model_config = SettingsConfigDict(env_file=".env", extra="ignore")
database_url: str
api_key: SecretStr
max_connections: int = 10
debug: bool = False

@field_validator("max_connections")
@classmethod
def ensure_positive(cls, v):
if v <= 0:
raise ValueError("must be positive")
return v

@field_validator("database_url")
@classmethod
def validate_scheme(cls, v):
if not v.startswith("postgresql://"):
raise ValueError("Only PostgreSQL supported")
return v


Бизнес-логика на уровне конфига

Валидаторы проверяют не только типы, но и бизнес-правила. Для data pipeline, требующего только определенный диалект SQL, это задается в одном месте, а не размазывается по модулям. Такой подход делает код читаемее и проще в поддержке.

Типичная ошибка: лишние переменные из .env

Без extra="ignore" случайная строка в .env вызовет ошибку. Другая проблема — путаница с env_prefix в подмодулях, когда конфиги перекрывают поля друг друга. Включите env_nested_delimiter для плоских переменных с вложенными моделями, чтобы избежать лишней вложенности.

Production-ready: кэшируем и расширяем

Для однократного создания конфига используем lru_cache, а дальше можно миксовать с аргументами командной строки через CliSettingsSource. С одним источником истины для env, файлов и флагов приложение становится проще тестировать и развёртывать.

Вывод: Инкапсуляция конфига через Pydantic Settings — это не просто типы, а гарантия, что приложение не стартанёт с неправильными данными, а секреты не утекут из-за банального логирования.
Post #2756 404
⁣ExceptionGroup + Rich: как читать production traceback, когда падает не одно, а всё сразу

В production с asyncio или concurrent.futures стандартный traceback — это простыня, где последняя ошибка съедает все предыдущие. Вы видите только финал, а корень теряется. Особенно когда цепочка задач падает каждая со своим исключением, и вы не понимаете, что именно пошло не так и в каком порядке.

Проблема: traceback теряет контекст
Обычный traceback показывает только последнюю ошибку. Если у вас 10 задач и 5 упали с разными исключениями, вы получите только одно. Всё, что было до него, исчезает. Для asyncio.gather() или concurrent.futures это катастрофа: ошибка может быть не в последней задаче, а в первой, но её уже нет.

Решение: ExceptionGroup + Rich
Python 3.11 ввёл ExceptionGroup (PEP 654). Он группирует несколько исключений в одно, сохраняя полную структуру. Но сам по себе он неудобен для чтения. Rich решает это: он рендерит ExceptionGroup с цветами, вложенностью и локальными переменными для каждого исключения.

import asyncio
from rich.console import Console
from rich.traceback import install

install(show_locals=True)
console = Console()

async def task(id: int):
if id % 2 == 0:
raise ValueError(f"Even ID: {id}")
raise RuntimeError(f"Odd ID: {id}")

async def run():
errors = []
for i in range(4):
try:
await task(i)
except Exception as e:
errors.append(e)
if errors:
raise ExceptionGroup("Tasks failed", errors)

try:
asyncio.run(run())
except ExceptionGroup as eg:
console.print_exception(show_locals=True)


Что даёт такой подход в production
Три вещи, которые превращают stack trace из мусора в actionable insight:
* визуальная группировка: видно, какие ошибки относятся к одному запуску задач, а не размазаны по логу;
* локализация: Rich показывает локальные переменные на момент падения для каждого исключения — не нужно гадать, какое значение было у id;
* иерархия: если у вас вложенные ExceptionGroup, структура не теряется, и вы видите, где какая ошибка возникла.

Практический совет
Добавляйте в ExceptionGroup метаданные — время, id запроса, контекст выполнения. Тогда по логу сразу понятно, что именно сломалось и при каких условиях. Для Python < 3.11 используйте пакет exceptiongroup — он работает аналогично и ставится через pip.

Типичная ошибка
Пытаться обработать ExceptionGroup как обычное исключение через except Exception. Это сломает логику: вы потеряете все вложенные ошибки. Используйте except* (PEP 654) или явно перехватывайте ExceptionGroup.

Trade-off
ExceptionGroup добавляет накладные расходы на сбор ошибок, если их много. Используйте только для задач, где ошибки реально могут быть множественными (batch processing, фоновые воркеры), а не для одиночных вызовов.

Вывод:
ExceptionGroup вместе с Rich превращает traceback из хаоса в структурированную карту боя, где каждая ошибка видна со своим контекстом, и вы не гадаете, что сломалось на самом деле.
  • 👍 1
Post #2755 396
⁣Circuit Breaker для gRPC и HTTP: как остановить каскадный сбой одним паттерном

Когда сервис падает, retry-механизмы без ограничений начинают долбить его снова — соединения висят, треды блокируются, нагрузка перекидывается на соседей. В production это приводит к каскадному обрушению, которое могло быть предотвращено. Частая ошибка — полагаться только на таймауты и надеяться на авось.

Как работает паттерн

Три состояния: Closed — нормальная работа, Open — запросы не отправляются, ошибка возвращается мгновенно, Half-Open — после таймаута пробуется один запрос. Если успешен — снова Closed, иначе — возврат в Open.

Пример для aiohttp

import aiohttp
from pybreaker import CircuitBreaker, CircuitBreakerError

breaker = CircuitBreaker(fail_max=3, reset_timeout=30)

async def call_external(url):
try:
with breaker:
async with aiohttp.ClientSession() as session:
async with session.get(url) as resp:
return await resp.text()
except CircuitBreakerError:
return {"error": "Service temporarily unavailable"}


Три ошибки подряд — breaker переходит в Open. Через 30 секунд Half-Open пробует восстановиться. Ресурсы не тратятся на мёртвые запросы.

gRPC: то же, но с нюансами

import grpc
from pybreaker import CircuitBreaker

breaker = CircuitBreaker(fail_max=5, reset_timeout=60)

async def call_grpc(stub, request):
try:
with breaker:
response = await stub.GetData(request)
return response
except CircuitBreakerError:
return default_response # fallback


Здесь нужно учитывать: gRPC при проблемах с доступностью шлёт статус UNAVAILABLE. Исключение внутри with-блока тоже считается как сбой, поэтому добавляйте логику отлова специфичных ошибок — иначе сломаете Half-Open.

Типичные ошибки

* Один breaker на все сервисы. Если gRPC-вызов уронил breaker, то HTTP к другому эндпоинту тоже заблокируется. Создавайте отдельный breaker для каждого внешнего сервиса.
* Игнорирование Half-Open. Без мониторинга вы не увидите, сколько раз breaker пытался восстановиться и снова падал.
* Слишком малый reset_timeout. При частом переходе между состояниями breaker начинает дёргаться и теряет смысл — выбирайте таймаут, достаточный для восстановления сервиса.

Вывод: Circuit Breaker — минимальная инженерная защита от каскадных сбоев, которая экономит ресурсы и сохраняет стабильность системы при отказах внешних зависимостей.
  • ❤ 1
Post #2754 415
⁣GIL в threading — это боль, которую многие просто принимают как данность

До Python 3.13 альтернатив не было: multiprocessing с оверхедом и морокой передачи данных, или asyncio, бесполезный при CPU-bound задачах. Реальные кейсы — обработка данных, парсинг, криптография — где threading кажется логичным, но GIL заставляет ядра простаивать, а однопоточный код обгоняет многопоточный.

Кейс из продакшна: пул потоков без прироста

Я написал пул потоков для обработки пакетов данных: каждый поток выполнял CPU-bound трансформацию. GIL не отпускался, прирост 0%. Переписал на multiprocessing — 3x, но память выросла в 4 раза. Типичная ошибка: думать, что threading даст параллелизм для чистых вычислений.

Free-threaded Python 3.13: сборка без GIL

В 3.13 появился флаг --disable-gil. Потоки наконец работают параллельно. На четырех ядрах прирост по CPU-bound задачам — 3-4x. Пример теста:

# threading с GIL (стандартная сборка)
import threading, time

def work():
for _ in range(10**7):
x = 1 + 1

threads = [threading.Thread(target=work) for _ in range(4)]
start = time.time()
for t in threads: t.start()
for t in threads: t.join()
print(f"С GIL: {time.time() - start:.2f}s")
# Вывод: ~2.5s (почти как последовательно)


# free-threaded (сборка без GIL)
# Тот же код — результат ~0.8s (на 4 ядрах)


Практический совет и предупреждение

Совет: если проект уперся в GIL, соберите Python 3.13 с --disable-gil, прогоните тесты. Но учтите trade-offs:
* однопоточный режим проседает на 10%
* C-расширения (numpy, pandas) без пересборки падают — они завязаны на GIL
* стабильная поддержка обещана только в 3.14

Типичная ошибка: кидаться пересобирать всё сразу. Начните с изолированного модуля, проверьте совместимость библиотек.

Вывод: Free-threaded Python 3.13 — это первая реальная альтернатива multiprocessing, но применяйте её осознанно, с пониманием просадки однопоточного режима и готовностью к экспериментам.
Post #2753 403
⁣Cache stampede в Python-сервисах: singleflight, jitter и stale-while-revalidate без героического тушения latency spike

Cache stampede возникает, когда популярный ключ истёк, и сотни запросов одновременно пересчитывают одно значение: SQL-агрегацию, внешний API или ML inference. Частая ошибка - считать, что обычный TTL сам по себе защищает production.

Singleflight: один refresh на ключ
Для одного cache_key в момент времени должен работать один пересчёт, остальные ждут или получают stale.

Внутри процесса подойдёт asyncio.Lock на ключ, но это не защита для нескольких uvicorn/gunicorn workers или pod’ов. Там нужен Redis SET NX PX, lease-lock, PostgreSQL advisory lock или singleflight поверх общего хранилища.

lock = locks.setdefault(key, asyncio.Lock())

async with lock:
item = await cache.get(key)
if item and item["expires_at"] > time.time():
return item["value"]

value = await fetch()
await store(cache, key, value)


Jitter: не синхронизируйте истечение
Если после деплоя прогреть 50k ключей с ttl=60, через минуту они начнут истекать пачкой.

Практичнее так:

ttl = 60
ttl = ttl + random.uniform(0, ttl * 0.15)


Особенно важно для агрегатов, feature flags, кэша внешних API и scheduled prewarm jobs.

Stale-while-revalidate: старое лучше лавины
Формат записи:

{
"value": value,
"expires_at": expires_at,
"stale_until": expires_at + 300,
}


Логика простая:
- свежий TTL жив - отдаём кэш;
- TTL истёк, но stale_until жив - отдаём stale и обновляем в фоне;
- stale-окно истекло - ждём refresh или возвращаем controlled error.

Production-нюансы
- lock обязан иметь TTL, иначе упавший воркер заблокирует refresh;
- refresh должен иметь timeout, retry budget и circuit breaker;
- stale нельзя бездумно включать для балансов, прав доступа и лимитов;
- метрики обязательны: cache_hit, stale_hit, lock_wait_seconds, refresh_errors.

Вывод:
Защита от cache stampede - это не один lock, а согласованный дизайн TTL, singleflight, jitter, stale-окон и отказоустойчивого refresh.
Post #2752 440
Миграции БД без даунтайма в Python-сервисах: Alembic, expand/contract и совместимость версий кода

Zero-downtime миграции важны там, где сервисы деплоятся rolling-ом: API, workers, async jobs. Частая ошибка - считать, что alembic upgrade head перед релизом решает совместимость схемы и кода.

Expand/contract
Схему меняем не одним ударом, а фазами:

* expand - добавляем новое так, чтобы старый код не сломался
* деплоим код, совместимый со старой и новой схемой
* делаем backfill, dual-write, переключение чтения
* contract - удаляем старое только после ухода всех старых инстансов

В Kubernetes, Nomad или systemd rolling deployment в проде какое-то время живут две версии сервиса. Миграция должна быть совместима минимум с текущим и следующим кодом.

Пример: first_name/last_name -> full_name
Плохой вариант: добавить full_name NOT NULL, удалить старые колонки и выкатить код. Старая версия сервиса начнет писать в удаленные поля и упадет.

Нормальный expand:

from alembic import op
import sqlalchemy as sa

def upgrade():
op.add_column(
"users",
sa.Column("full_name", sa.Text(), nullable=True),
)
with op.get_context().autocommit_block():
op.create_index(
"ix_users_full_name",
"users",
["full_name"],
postgresql_concurrently=True,
)


Новый код сначала живет в переходном режиме:

def get_display_name(user) -> str:
return user.full_name or f"{user.first_name} {user.last_name}"

user.first_name = first_name
user.last_name = last_name
user.full_name = f"{first_name} {last_name}"


Практические правила
* backfill делайте отдельным job, батчами, с лимитами, паузами и метриками
* не запускайте тяжелые data migration внутри DDL-миграции Alembic
* DROP COLUMN, RENAME COLUMN, SET NOT NULL и смену типа выносите в contract
* NOT NULL добавляйте после заполнения данных и проверки консистентности
* Alembic в проде должен запускать один контролируемый runner, а не каждый инстанс приложения

Вывод:
Zero-downtime миграция - это не SQL-команда, а протокол совместимости между схемой, кодом, деплоем и данными.
  • ❤ 1
Post #2751 507
SQLAlchemy 2.0 pool под нагрузкой: где ломается и как не уронить PostgreSQL

Типичная ошибка - считать pool_size=20 ускорителем. В production API это лимит конкурентных DB-соединений на один процесс, и при 8 workers база уже видит до 160 соединений без учета overflow.

Пул должен делать backpressure
Его задача - не выжать максимум, а дозировать давление на PostgreSQL: поставить запрос в очередь или быстро отказать.

engine = create_engine(
dsn,
pool_size=10,
max_overflow=0,
pool_timeout=2,
pool_recycle=1800,
pool_pre_ping=True,
connect_args={"options": "-c statement_timeout=5000"},
)


Считайте глобальный лимит
Формула для сервиса:

workers * pool_size + workers * max_overflow

Это число должно быть меньше бюджета PostgreSQL по соединениям. Не забудьте миграции, фоновые задачи, админские сессии и другие сервисы.

Осторожно с max_overflow
Overflow под всплеском часто создает stampede: приложение «помогает» базе, открывая еще больше конкурирующих запросов. Для latency-sensitive API безопаснее max_overflow=0: лишние запросы дождутся pool_timeout и упадут в приложении, а не добьют БД.

Таймауты решают разные задачи
* pool_timeout - сколько ждать свободное соединение из пула
* statement_timeout - сколько PostgreSQL выполняет SQL-запрос

Не ставьте pool_timeout=30 без причины: worker может 30 секунд просто ждать коннект. Часто 1-3 секунды надежнее длинной очереди.

Stale connections
pool_pre_ping=True защищает от мертвых соединений после рестарта PostgreSQL, NAT/LB idle timeout или сетевого разрыва. pool_recycle ставьте меньше idle timeout вашей инфраструктуры, например 1800 при лимите 60 минут.

Вывод:
Пул соединений - не ускоритель, а предохранитель, который ограничивает давление на PostgreSQL и делает отказ контролируемым.
Post #2750 474
Детерминированная сборка Python-контейнера: это когда образ из одного и того же коммита сегодня и через месяц получает один и тот же набор зависимостей.

pip install -r requirements.txt сам по себе такого не обещает. Может уехать транзитивная зависимость. Может появиться другой wheel под вашу платформу. Может внезапно собраться sdist. Может поменяться Python в base image или состояние package index.

Рабочая схема выглядит так:

1. pyproject.toml описывает намерения.
2. uv.lock фиксирует конкретное разрешение зависимостей.
3. wheelhouse фиксирует installable-артефакты.
4. Runtime-стадия ставит зависимости без доступа к индексу.

Пример Dockerfile:

FROM python:3.12-slim AS wheels

COPY --from=ghcr.io/astral-sh/uv:latest /uv /usr/local/bin/uv

WORKDIR /app
COPY pyproject.toml uv.lock ./

RUN uv export \
--frozen \
--no-dev \
--no-hashes \
--format requirements-txt \
-o requirements.txt

RUN python -m pip wheel \
--requirement requirements.txt \
--wheel-dir /wheelhouse \
--only-binary=:all:

FROM python:3.12-slim AS runtime

WORKDIR /app

COPY --from=wheels /wheelhouse /wheelhouse
COPY --from=wheels /app/requirements.txt /requirements.txt

RUN python -m pip install \
--no-index \
--find-links=/wheelhouse \
--requirement /requirements.txt \
&& rm -rf /wheelhouse

COPY . .

CMD ["python", "-m", "app"]


На что я бы тут смотрел в первую очередь.

uv export --frozen не обновляет lock-файл. И это хорошо. Если pyproject.toml и uv.lock разъехались, сборка должна упасть, а не молча «починить» зависимости прямо внутри Docker build.

wheelhouse убирает из runtime-сборки режим «сходить в интернет и скачать что получится». Вместо этого pip ставит заранее подготовленные артефакты. Runtime-слой уже не зависит от PyPI, зеркала, yanked-релизов и сетевых флуктуаций.

--only-binary=:all: тоже не случайная опция. Она запрещает внезапную сборку из sdist. Если пакет требует компиляции, лучше явно вынести это в controlled build-стадию, чем потом ловить разные wheel из-за версии компилятора, системных библиотек или base image.

Что ещё помогает против дрейфа:

- коммитить uv.lock;
- в CI проверять установку через uv sync --locked или сборку через uv export --frozen;
- не запускать uv lock внутри Docker build как часть обычной сборки;
- пиновать base image не только по тегу, но и по digest;
- собирать wheelhouse под тот же Python minor, ABI и семейство образа, что и runtime;
- финальную установку делать с --no-index;
- хранить wheelhouse как CI-артефакт или собирать его строго из lock-файла.

Я это обычно делю на два слоя. Lock-файл защищает resolution layer: какие версии выбрали. Wheelhouse защищает artifact layer: какие именно файлы потом установили. Если нужен не «примерно воспроизводимый» контейнер, а контролируемая сборка, нужны оба уровня.
Post #2749 468
Backpressure в async Python-сервисах: как bounded queues, лимиты конкуренции и таймауты останавливают cascading failure

Это не микрооптимизация, а механизм выживания backend-сервиса под нагрузкой. В production проблема часто появляется на медленном downstream: таски плодятся, память растет, клиенты ретраят, и падает уже цепочка сервисов.

Очередь не должна быть бесконечной

asyncio.Queue() без maxsize часто превращает память процесса в скрытый буфер аварии. Делайте очередь bounded и решайте, что делать при переполнении: ждать, вернуть 429/503 или отбросить низкоприоритетную работу.

Лимитируйте конкуренцию

Async не означает “можно запустить 100k запросов к API или базе”.

queue = asyncio.Queue(maxsize=1000)
limit = asyncio.Semaphore(50)

async def submit(item):
try:
queue.put_nowait(item)
except asyncio.QueueFull:
raise Overloaded()

async def worker():
while True:
item = await queue.get()
try:
async with limit:
await asyncio.wait_for(
process(item),
timeout=2.0,
)
finally:
queue.task_done()


Здесь Queue(maxsize=1000) ограничивает память, Semaphore(50) защищает downstream, а timeout не дает зависшим операциям держать слоты навсегда.

Типичная ошибка

Плохая стратегия - принять все, сложить в память и надеяться “потом разгребем”. Под нагрузкой надежнее явно деградировать: 429/503, bounded wait, circuit breaker, durable queue для допустимых сценариев.

Что измерять

Минимум: размер очереди, время ожидания, rejected/dropped, saturation семафоров и пулов, timeout rate, latency downstream и retry rate. Без этих метрик backpressure превращается в догадку.

Вывод:
Надежный async-сервис ограничен по памяти, конкуренции и времени ожидания, иначе он становится усилителем cascading failure.
Post #2748 525
Совет на ближайшие годы — изучайте ВАЙБ-КОДИНГ

ИИ уже пишет код, чинит баги, генерирует тесты, документацию и помогает запускать продукты быстрее, чем это делали классические команды разработки. И это уже не "будущее когда-нибудь", а реальность, которая меняет рынок уже сегодня

И те, кто научится вайбкодить сейчас, будут увереннее конкурировать на рынке и зарабатывать больше тех, кто по-прежнему делает всё вручную.

Стартовать с нуля поможет канал Вайб-кодинг. Там ребята круглосуточно мониторят более 320 российских и зарубежных источников и публикуют только главное: релизы, инструменты, гайды, курсы и практические кейсы.

Подписывайтесь, нас уже 45 тысяч: @vibecoding_tg
  • ❤ 4
Post #2747 524
Утечки памяти в долгоживущих Python-сервисах: как отличить retention leak от native allocations и поведения аллокатора

В production рост RSS у API, воркера или data pipeline не всегда означает забытый объект в списке. Частая ошибка - смотреть только на график памяти и сразу чинить GC, не выяснив, кто реально удерживает или выделяет память.

1. Начинайте с tracemalloc

tracemalloc хорош для Python-level аллокаций: кэши без eviction, глобальные dict/list, closures, task-и, references из metrics/tracing.


import tracemalloc

tracemalloc.start(25)
base = tracemalloc.take_snapshot()

def dump_memory_diff():
global base
cur = tracemalloc.take_snapshot()
for stat in cur.compare_to(base, "lineno")[:10]:
print(stat)
base = cur{}


Практический совет: в сервисе повесьте такой dump на admin endpoint, signal handler или debug job и сравнивайте snapshot-ы после прогрева, а не сразу после старта.

2. Подключайте Memray для native слоя

Если RSS растёт, а tracemalloc почти стабилен, смотрите C/Rust extensions: numpy, pandas, cryptography, grpc, драйверы БД, compression libs.


memray run -o memray.bin python -m app
memray flamegraph memray.bin
memray table memray.bin{}


tracemalloc отвечает: какие Python allocation sites выросли. Memray помогает увидеть, где выделялась память, включая native allocations.

3. Не путайте leak и аллокатор

CPython может освободить объекты, но RSS не обязан сразу упасть: pymalloc, arenas, pools и system malloc держат память для повторного использования.

Проверка гипотезы:


PYTHONMALLOC=malloc python -m app
PYTHONMALLOCSTATS=1 python -m app{}


Предупреждение: если при PYTHONMALLOC=malloc профиль резко меняется, это может быть fragmentation / allocator behavior, а не retention leak.

Порядок диагностики

* зафиксируйте RSS, heap, GC stats, размеры кэшей, очередей и pools;
* воспроизведите сценарий: прогрев - стабильный traffic - подозрительный endpoint или job;
* сравните tracemalloc, Memray и метрики приложения;
* чините конкретный owner памяти, а не абстрактный “memory leak”.

Вывод:
Надёжная диагностика утечек начинается не с GC, а с разделения Python retention, native allocations и поведения аллокатора.
  • ❤ 1
  • 😁 1
Post #2745 632
Structured concurrency в asyncio: TaskGroup, отмена задач и graceful shutdown без «осиротевших» корутин

Частая ошибка в asyncio-коде: раскидать asyncio.create_task() по разным углам приложения и надеяться, что при shutdown всё само закроется.

Обычно не закрывается.

Задача живёт отдельно от места, где её запустили. Потеряли ссылку, забыли await, подавили отмену — и на выходе получаем фоновые корутины с открытыми соединениями и Task was destroyed but it is pending!.

Structured concurrency предлагает правило: если конкурентная работа создана внутри scope, она должна завершиться внутри него же.

В Python 3.11 для этого есть asyncio.TaskGroup:

async with asyncio.TaskGroup() as tg:
tg.create_task(worker("a"))
tg.create_task(worker("b"))
tg.create_task(worker("c"))


Вышли из блока — все дочерние задачи завершены. Если одна упала, остальные будут отменены, а наружу прилетит ExceptionGroup.

Главное отличие от хаотичного create_task(): у задач появляется владелец и понятная граница жизни.

Пример graceful shutdown:

import asyncio
import signal

async def worker(name: str):
try:
while True:
print(f"{name}: tick")
await asyncio.sleep(1)
except asyncio.CancelledError:
print(f"{name}: cleanup")
# close connections, flush buffers, release locks
raise # не проглатываем отмену

async def main():
stop = asyncio.Event()
loop = asyncio.get_running_loop()

for sig in (signal.SIGINT, signal.SIGTERM):
loop.add_signal_handler(sig, stop.set)

try:
async with asyncio.TaskGroup() as tg:
tg.create_task(worker("w1"))
tg.create_task(worker("w2"))

await stop.wait()
raise asyncio.CancelledError

except asyncio.CancelledError:
print("shutdown complete")

asyncio.run(main())


Что происходит:

1. Воркеры запускаются внутри TaskGroup.
2. Приложение ждёт сигнал завершения.
3. При shutdown отменяется родительский scope.
4. TaskGroup отменяет дочерние задачи.
5. Каждый worker получает CancelledError, делает cleanup и пробрасывает исключение дальше.
6. asyncio.run() завершает loop без потерянных фоновых задач.

CancelledError — это не просто ошибка, а сигнал управления жизненным циклом задачи. Если поймать его и не сделать raise, можно сломать нормальную отмену.

Плохо:

try:
await something()
except asyncio.CancelledError:
log.info("cancelled")
# забыли raise


Лучше:

try:
await something()
except asyncio.CancelledError:
log.info("cancelled")
raise


Для cleanup используйте try/finally, async context managers или ловите CancelledError, но не подавляйте его без очень веской причины.

TaskGroup также даёт fail-fast поведение. Если одна задача упала, остальные связанные задачи часто не должны продолжать работу на старом состоянии. Например, consumer потерял соединение с брокером — группа отменяется, а родитель решает: перезапустить её или завершить сервис.

Типовая схема:

async def run_service():
async with asyncio.TaskGroup() as tg:
tg.create_task(consume_events())
tg.create_task(flush_metrics())
tg.create_task(healthcheck_server())


Практические правила:

• Не создавайте «вечные» задачи через create_task() без владельца.
• Используйте TaskGroup для связанных фоновых задач.
• На shutdown отменяйте родительский scope, а не каждую задачу вручную.
• Не проглатывайте CancelledError.
• Освобождайте ресурсы в finally и async context managers.
• Помните про ExceptionGroup: несколько ошибок могут прийти вместе.
• Если задача должна пережить текущий scope, это отдельный lifecycle, а не случайный create_task() в середине функции.
  • 👍 2
Post #2743 790
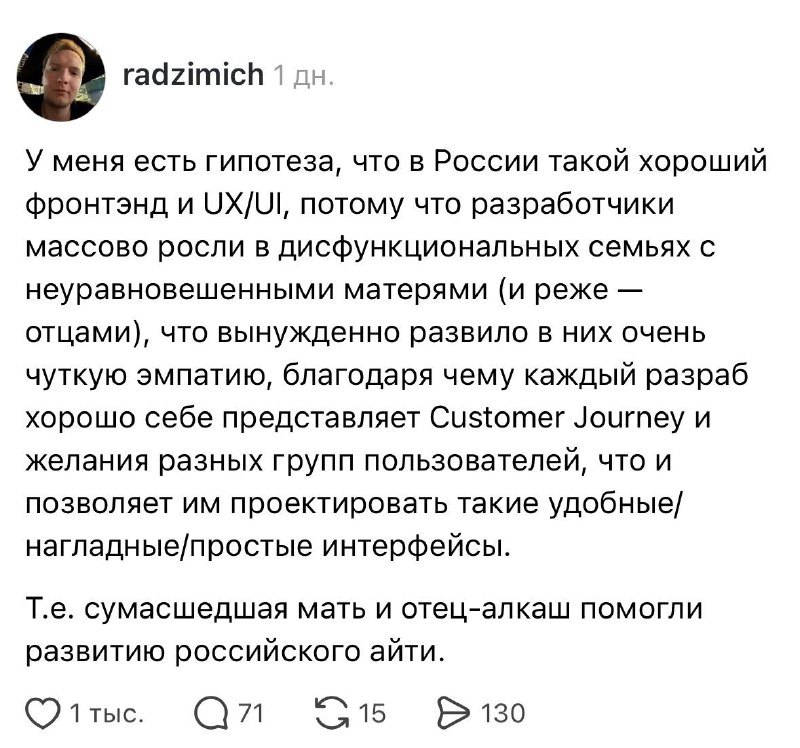
Страшная тайна российского айти

✖️ xCode Journal
  • 😁 4
Post #2741 804
⁣Что такое calibration модели и зачем она нужна

Многие смотрят на модель
только через:

👉 accuracy
👉 F1
👉 ROC-AUC

Но есть проблема.


Даже модель с хорошими метриками
может очень плохо оценивать вероятности.


И иногда это критичнее самой классификации.

Интуитивный пример

Представь две модели.

Обе предсказывают одинаково хорошо.

Но первая говорит:

👉 «вероятность дефолта 95%»

и оказывается права только в половине случаев.

А вторая:

👉 «вероятность дефолта 95%»

и реально попадает примерно в 95 случаях из 100.


Вторая модель calibrated.
Первая — нет.


Что вообще означает calibration

Calibration отвечает на простой вопрос:


«Можно ли доверять вероятностям модели?»


Если модель говорит:

👉 0.8 probability

то примерно в 80% таких случаев
событие действительно должно происходить.

Почему это важно

Особенно там,
где решение зависит именно от вероятности.

Например:

👉 кредитный скоринг
👉 медицина
👉 fraud detection
👉 ranking
👉 ad systems


Бизнес часто работает не с классом,
а с risk score.


Какие модели calibrated хуже

Некоторые модели
по природе оценивают вероятности хуже других.

Например:

👉 Logistic Regression обычно калибрована неплохо
👉 Gradient Boosting часто слишком overconfident
👉 deep learning любит завышенную уверенность

Почему ROC-AUC тут не спасает

Очень частая история:

👉 ROC-AUC отличный
👉 а вероятности мусорные

Почему?


ROC-AUC оценивает ranking,
а не качество probability estimates.


Модель может:

👉 идеально ранжировать объекты
👉 и ужасно оценивать сами вероятности

одновременно.

Как проверяют calibration

Обычно используют:

👉 calibration curve
👉 reliability diagram
👉 Brier score

Если calibration плохой,
применяют:

👉 Platt Scaling
👉 Isotonic Regression
👉 temperature scaling для нейросетей

Почему это недооценивают

На Kaggle calibration почти никого не волнует.


Там главное — leaderboard.


Но в реальном проде вероятность:

👉 0.97
👉 0.12
👉 0.83

часто становится бизнес-решением.

Например:

👉 выдать кредит
👉 заблокировать транзакцию
👉 отправить на ручную проверку

Главная мысль


В какой-то момент оказывается,
что качество вероятностей
важнее красивого ROC-AUC.
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →