
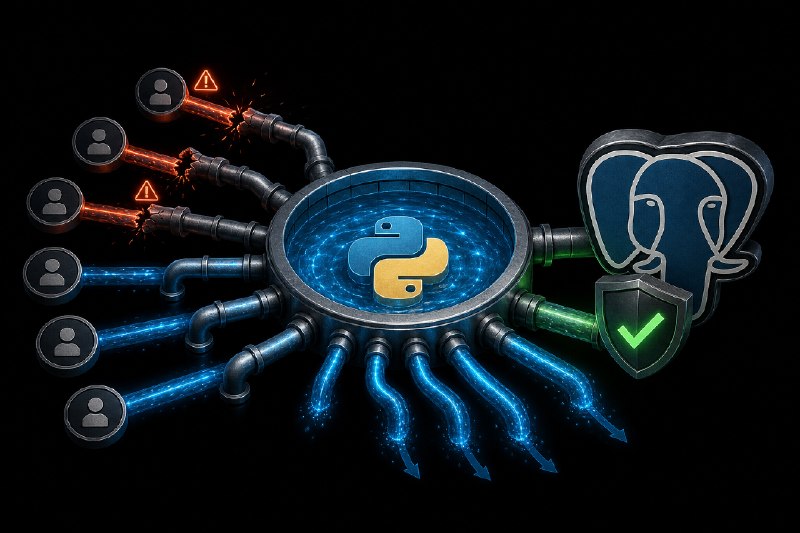
Типичная ошибка - считать
pool_size=20 ускорителем. В production API это лимит конкурентных DB-соединений на один процесс, и при 8 workers база уже видит до 160 соединений без учета overflow.Пул должен делать backpressure
Его задача - не выжать максимум, а дозировать давление на PostgreSQL: поставить запрос в очередь или быстро отказать.
engine = create_engine(
    dsn,
    pool_size=10,
    max_overflow=0,
    pool_timeout=2,
    pool_recycle=1800,
    pool_pre_ping=True,
    connect_args={"options": "-c statement_timeout=5000"},
)
Считайте глобальный лимит
Формула для сервиса:
workers * pool_size + workers * max_overflowЭто число должно быть меньше бюджета PostgreSQL по соединениям. Не забудьте миграции, фоновые задачи, админские сессии и другие сервисы.
Осторожно с max_overflow
Overflow под всплеском часто создает stampede: приложение «помогает» базе, открывая еще больше конкурирующих запросов. Для latency-sensitive API безопаснее
max_overflow=0: лишние запросы дождутся pool_timeout и упадут в приложении, а не добьют БД.Таймауты решают разные задачи
*
pool_timeout - сколько ждать свободное соединение из пула*
statement_timeout - сколько PostgreSQL выполняет SQL-запросНе ставьте
pool_timeout=30 без причины: worker может 30 секунд просто ждать коннект. Часто 1-3 секунды надежнее длинной очереди.Stale connections
pool_pre_ping=True защищает от мертвых соединений после рестарта PostgreSQL, NAT/LB idle timeout или сетевого разрыва. pool_recycle ставьте меньше idle timeout вашей инфраструктуры, например 1800 при лимите 60 минут.Вывод:
Пул соединений - не ускоритель, а предохранитель, который ограничивает давление на PostgreSQL и делает отказ контролируемым.