😅 Спидран комбайна в Power BI. Ускорил, дополнил, доделал.
Теперь турбокомбайн работает идентично в Excel и Power BI:
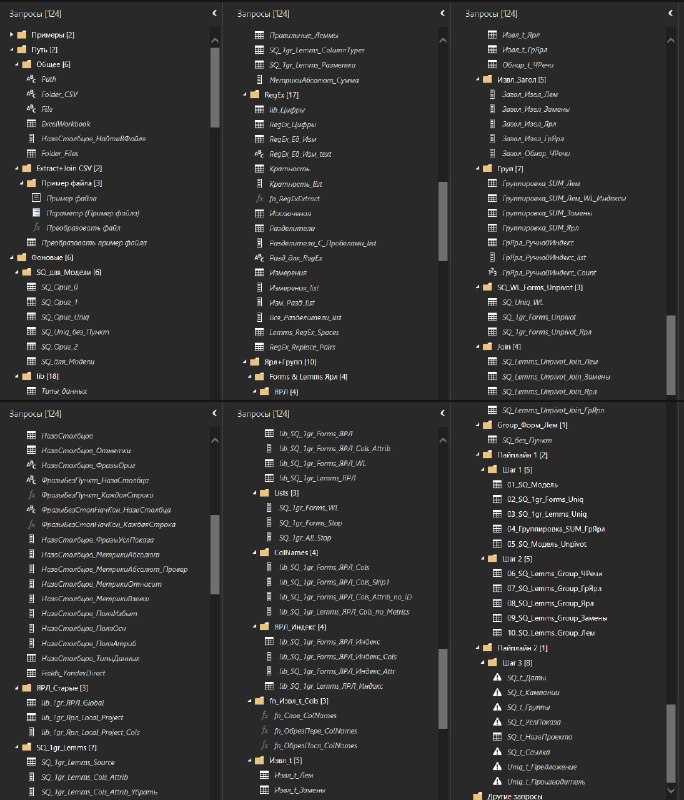
— 120 запросов (скрины 1–2).
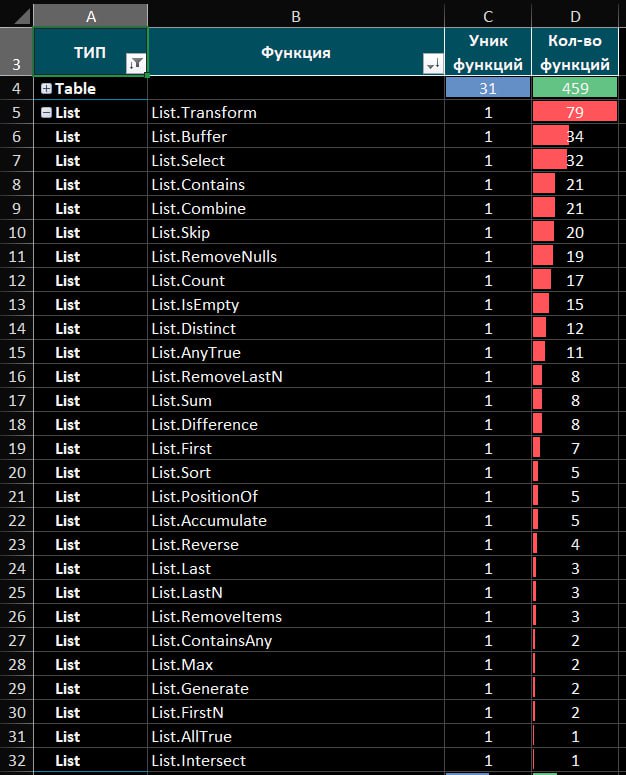
— 1023 функции в пайплайне (скрины 5–8).
— 94 уникальные функции.
— Одинаковая модель данных (скрин 3).
— 4500 уникальных строк кода.
— 88 листов А4 кода (скрин 4).
✅ Пользовательские значения и библиотеки заполняются в одном файле.
✅ Дальше в Excel и Power BI обработка данных идентична.
✅ Идентичная структура запросов в Excel и Power BI, отличия только в подключении к источнику.
✅ Отличия скорости:
— в 2 раза: Power BI обновляет запросы параллельно, Excel — последовательно.
— в 3 раза: если в Power BI не обновлять схему модели данных, а только данные, что нельзя отдельно сделать в Excel.
Из 76.000 неочищенных фраз получаем ~4000 чистых сгруппированных:
⏱️ В Power BI:
— 12:29 — только обновление данных.
— 17:08 — схема модели + данные.
⏱️ В Excel:
— 34:10 — схема + данные.
2 месяца сидел в коде ежедневно по 15 часов. Переделал десятки версий, добавил функционала, искал способы оптимизации. Ускорил на 20%, но это лишь погрешность. Больше всего на скорость обновления влияет объём данных. Самая медленная операция — чтение данных.
Нашёл и протестировал лучшие практики экспертов BI-индустрии, спецов со статусом MVP от Microsoft, авторов книг, курсов, блогов по Power BI, прошерстил справку по Power Query, перепробовал для оптимизации запросов сотни промптов в нейросетях, в т.ч. на платных тарифах.
Это привело лишь к незначительному приросту производительности либо вовсе к замедлению. С пайплайном из 1000+ функций всё сложно. Ускорения х50–500 не будет. Новые попытки тратить время на оптимизацию никогда себя не окупят.
Я всё это выстрадал за вас, чтобы не пришлось страдать вам.
Добавил:
✅ Параметризацию всех обрабатываемых объектов: полей, их количества, значений, списков, фильтров, сортировок, группировок и др.
✅ Три метода автогруппировки семантики. Можно использовать 1, 2 или 3 способа одновременно. Разница — в приоритете, чистоте и детализации. Каждый выбирает сам, в каком срезе использовать какой метод группировки.
✅ 50+ универсальных правил разметки униграмм.
✅ Тысячи замен синонимов на единые написания.
✅ Десятки тысяч значений в глобальной библиотеке для разметки.
✅ 100+ регулярных выражений для разметки.
✅ Регулярки извлекают значения, ряд правил заменяет их на единые написания для унификации и универсализации разметки, фильтрации, приоритизации, сортировки, группировки и избегания излишнего дробления кластеров.
✅ Поддержка пользовательской библиотеки для разметки униграмм. Изменяешь разметку в локальной библиотеке по текущему проекту — пересчитывается весь пайплайн.
✅ После фильтрации семантики вайтлистом обрабатываются и группируются только целевые сегменты, мусор не обрабатывается вовсе для повышения производительности.
✅ Изменён приоритет библиотек при разметке:
— Локальная (по текущему проекту).
— Глобальная (по всем проектам).
— Универсальные правила.
— Регулярки.
✅ Теперь регулярки обрабатывают в сотни раз меньше данных после фильтрации 50 правилами, проходя по остаткам того, что не обработано правилами. В разных проектах это могут быть как сотни, так и сотни тысяч уникальных значений. Разница в производительности на таких массивах — огромна.
Также добавлены:
✅ Введение пользовательских значений для гибкого управления комбайном.
✅ Автоприоритизация сегментов.
✅ Автоконсолидация статистики по неявным дублям.
✅ Автоопределение по показателям самой частотной словоформы каждого неявного дубля.
✅ Автопересчёт показателей на разных уровнях группировки данных.
✅ Универсализация схемы нейминга вычисляемых полей.
✅ Автосоздание и автопересчёт вычисляемых полей.
✅ Автозамена синонимов на единые написания с последующим обновлением всего пайплайна, автовычислением приоритета сегментов и их перегруппировкой.
Что дальше:
⚡️ Автосборка РК для Гугла и Яндекса.
⚡️ Автодобавление в РК новой семантики.
⚡️ Морфологический анализ на Python, встроенном в Power BI, для фильтрации и группировки семантики.
✅ Читать продолжение.
via @ppc_bigbrain
Post #1679
2.32K