

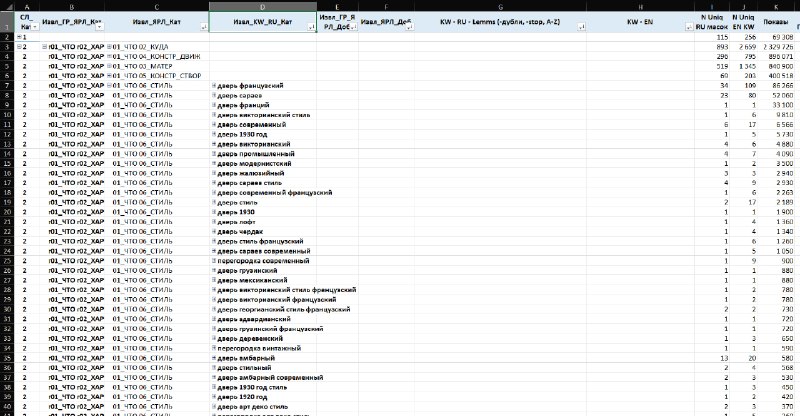


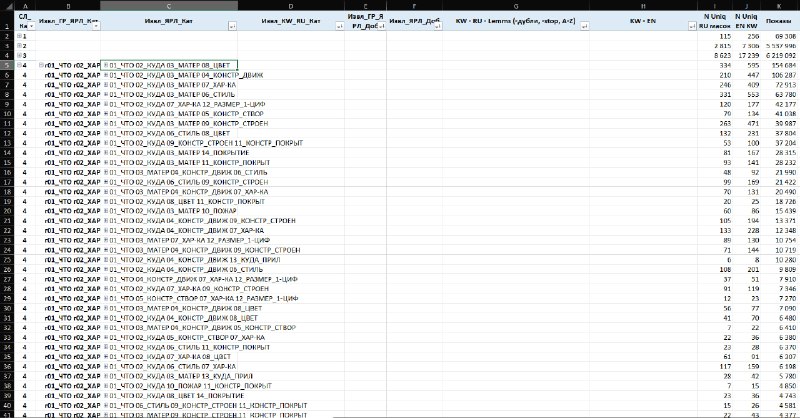
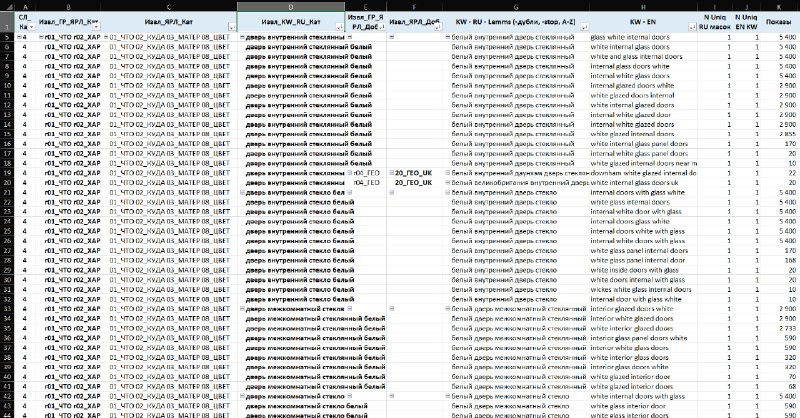

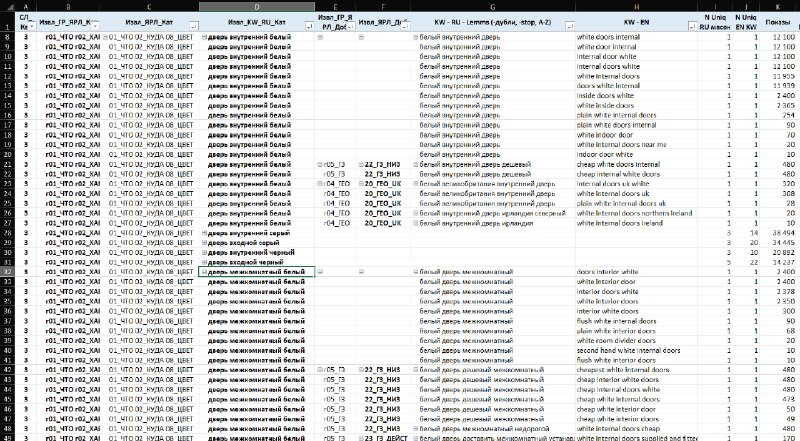
🔺 Прочитайте сначала часть 1 и часть 2.
Пока шаблон привязан "хардкодом" к названиям и количеству столбцов в этом проекте, но и не было задачи заниматься параметризацией.
До универсализации ещё далеко, но запрос PQ уже оптимизирован так, чтобы можно было переделать его под другой проект.
На объёмах в 575 тысяч неуникальных фраз из 330 выгрузок планировщика Гугла, из которых уникальных — 70 тысяч фраз, и из них целевых с ненулевой частотностью — 35 тысяч фраз, PQ выполняет ~300 преобразований данных за 2 минуты.
Зачем мне столько фраз? Да специально, чтобы на больших объёмах протестить.
2 дня назад, когда операций было в 5 раз меньше, но скорость запроса не была оптимизирована, он выполнялся 10-15 минут.
Теперь он в 5 раз сложнее и больше, и 1300 строк кода отрабатывают за 2 минуты.
О — оптимизация.
Для полного хлебушка с нулевым опытом в разработке очень достойный результат, ящщетаю.
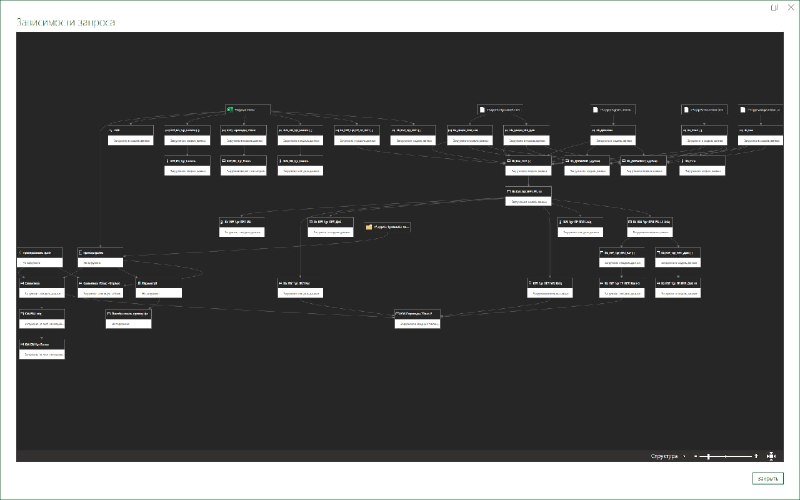
На последнем скрине — связанные запросы PQ.
Эти связи — то, что под капотом у автоматизации сквозного обновления данных.
Похимичу ещё с типами извлекаемых и сопоставляемых данных (списками, записями, таблицами) и попробую ускорить запрос ещё в несколько раз.
————
Следующие шаги:
💓 Избавление от хардкода.
💓 Параметризация переменными.
💓 Замена синонимов на единое написание.
💓 Игнор неявных дублей иностранных фраз.
💓 Ускорение запроса.
💓 Замена лишних запросов функциями.
💓 Уменьшение количества подключений в 10 раз.
💓 Гибкость и юзерфрендли.
Турбокомбайн уже на подходе. Подробнее о нём:
— Часть 1
— Часть 2
— Часть 3
— Часть 4
— Часть 5
За 3 дня с чистого листа собрал самое крутое, что я когда-либо делал за 10 лет карьеры. Дико рад, что наконец пересилил себя, сел и сделал. Энергии от полученных результатов хватит ещё на пару месяцев разработки.
————
Сегодня в 19:00 по МСК на стриме покажу, как работает этот комбайн, и расскажу, что с ним делать, чем он будет полезен и при запуске РК, и при аналитике, и при оптимизации рекламы.
————
via @ppc_bigbrain