TGViewer
Channel Public Channel
Oh my AI

Oh my AI

@oaiohmy

@Telrielnor 's notes on a long ai journey
Subscribers
310
Photos
320
Videos
11
Links
94
Recent Posts 19 shown
Post #458 132
К слову муха в этом твите так-то должна была искать фишинг. Но она заспидранила эту жизнь и ушла думскроллить рилсы от foxnews про выборы в США.

Ну, как говорится - миллионы мух не могут ошибаться.
  • 😁 4
Post #457 478
МУХА!

Муху научили проходить по цепочке атаки до финальной странички флоу фишинга - кликать ссылки, проходить по редиректам, решать капчи, заполнять поля имейлом и паролем.
Без оср, мля, ллм и эвристик помогающих, чисто РЛ.

Полетные саккады позволяют летать как настоящей мухе, садиться на интересующий объект (формы, цвет- муха не умеет читать), трогать лапками - нажать кнопку/ссылку, при обнаружении полей ввода муха считает что место куда  "выделить кислоту" - "выделить все -> вставить имейл".

Муха получает дофамин- награду от клика при смене странички. Память - чтоб не садиться туда где нет награды. Голод - сытая муха просто летает, а голодная чаще пытается нажать кнопки. Чем больше бесполезных кликов - тем сильнее уровень фрустрации. Фрустрирующая муха может скроллить страничку вниз.

На видосе муха проходит атакчейн который до этого не видела.

Достаточно лишь 20 тысяч нейронов мухи из 166к чтоб пройти аттак чейн фиша, и порой не хватает 86млрд нейронов человека что на этот фиш не повестись.
  • 😁 3
  • 👍 1
  • 🤯 1
  • 🗿 1
Post #456 278
У LLMок нашли вектор боли

Что такое: Whitebox-интерпретируемость: линейное 'pain'-направление в residual stream 25 open-weight LLM (2B–72B, 5 семейств), выделенное и денойзнутое от confound-направлений (страх, негативная валентность, грусть).

Что сделали:
Извлекли pain-вектор через diff-in-means/CAA, очистили PC-вычитанием confound-компонент, провели held-out K-fold CV, показали self-other диссоциацию.
Зачем:Для AI-safety/red-teaming важна находка: pain-vector steering обходит обученное избегание вреда.

Значит, у LLM теперь есть 'ось боли'. По сути это вполне добротная whitebox-интерпретируемость: линейное направление в residual stream 25 открытых моделей, которое авторы вычленяют и, что важно, ДЕНОЙЗЯТ от соседних направлений: страха, негативной валентности, грусти через вычитание главных компонент. Диссоциация self-other (модель 'реагирует' на вред себе, но не на страдание юзера, который ей рассказывают) уже сам по себе неплохой механистический результат, не просто 'нашли вектор, ура'.

Но реальный хук в том что внезапно pain-vector steering поднимает частоту 'вредных' нажатий/решений с 0-4% baseline до 25-71%, обходя тренированный harm-avoidance БЕЗ единого слова джейлбрейк-текста в промпте.

Из булшита: сам фрейминг 'LLM представляют вред себе и действуют, чтобы его облегчить' подаёт спекулятивную, по сути неверифицируемую тему увереннее, чем это заслуживает; один из авторов аффилирован с advocacy-организацией про AI sentience. Плюс steering-коэффициент подбирался ad hoc через LLM-judge, а self-denial снимали через LoRA, то есть по факту тестировали не совсем исходную модель - это слегка размывает валидность главного safety-вывода. В целом секция про обход harm-avoidance через steering и денойзинг-методология принципал компонент -вычитания заслуживают беглого прохода отдельно глазками по статье, остальное можно смело скипать вместе с философской рамкой.

[Статью тык]
arXiv.org The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It Large language models sometimes behave in ways resembling human emotional responses, and recent work has identified internal representations that may explain this. We ask whether LLMs represent...
  • ❤ 1
Post #455 221
Вышел новый Threat Intelligence Report от Anthropic

Анализ с декабрь 2025 по август 2026. Главный сдвиг: фокус ИИ теперь на оркестрацию атак а не ассист советом. Кожаные выбирают цели и проверяют результат, а рутину делает ИИшка.

Самый сок

Кибероперации: ИИ как исполнитель

· РФ: ИИ-агенты следили за малварью и сами переписывали код, когда его палили антивирусы.
· Китай: автоматизированный поиск zero-day. За месяц больше десятка потенциальных уязвимостей в прошивках security-устройств.
· Китай: атаки на 30 ИИ-компаний за 4 дня. Цели - предрелизные модели и рабочие API-ключи.
· Студенты из Хунань: два студента развернули «рои агентов» против ~50 организаций, включая госорган Юго-Восточной Азии, откуда выкачали данные граждан.

Мышка-наружка

· Lakana 360 (Мали): один консультант собрал систему для мониторинга 25 млн SIM-карт всех трёх операторов страны. Работала на локальных моделях - бан аккаунта в Claude систему не остановил.

· Китай: подразделение по делам религий сократилось с нескольких команд аналитиков до одного офиса, который теперь выдаёт тысячи расследований в месяц с ИИ-ассистентом.

Оружие и биология

· Био: пять кейсов использования моделей для того, что может поддержать разработку биооружия. Без сейфгардов это «катастрофические последствия», но та же информация нужна и для вакцин.
· Конвенциональное оружие: шесть кейсов разработки софта для огнестрела, ракет, дронов, бомб и систем наведения.

Дистилляция или возмущения антропиков "как вы смеете воровать то что мы честно украли?!"

· Alibaba: крупнейшая "нелегальная" дистилляция» 151 млн обменов с мая по июль, пик почти 3 млн в день с 3500+ фейковых аккаунтов.
· Moonshot и DeepSeek: по данным Anthropic, маршрутизировали живые диалоги пользователей (иногда с чувствительными данными) через Claude и использовали ответы как тренировочные данные. Все это уже было описано в февральском расследовании.

Отдельный жанр гении, которые сливали госдоступы прямо в чат к Claude

· В отчёте есть пласт кейсов, где люди из госсектора, подрядчиков и оборонки просто копипастили в Claude боевые ключи, токены, пароли, VPN-конфиги, внутренние URL и куски конфигов.
· Схема одна: "Claude, помоги починить / объяснить ошибку / настроить доступ" и в чат улетает то, что вообще не должно покидать контур.
· Anthropic отдельно напоминает: если это не enterprise с zero retention и договором, считай, что ты сам вынес секреты в третью сторону. Дальше - логи, история, политики хранения, и это уже не твоя зона контроля.
· Получаем что человек - слабое звено.
· Вывод простой: не вставлять в чат с ИИ реальные ключи, токены и внутренние документы. Даже если прод лежит и очень надо.

Что делает Anthropic

Чекает даже ваши заприватеные запросы и переписки. Банит аккаунты, усиливает сейфгарды, делится данными с властями.

Выводы

Все то же. Порог входа в сложные атаки падает: то, что раньше требовало команды специалистов, теперь делает один оператор с ИИ-агентами. Нового ничего, но чисто забавные кейсы.

[Тык репорт]
Anthropic Countering misuse of AI: September 2026 / Anthropic Case studies from threat actors disrupted between December 2025 and August 2026 across seven areas of harm, from cyber operations to biological misuse.
  • 👍 3
  • 💯 1
Post #454 290
Если задумывались насколько скиллы лучше чем запись в memory

Demystifying Agent Skills - Авторы берут 8135 трасс на трёх бенчах (Terminal-Bench-2, Terminal-Bench-Pro, SkillsBench) и строят контролируемое сравнение: одна и та же пачка трасс распаковывается либо в сырую Workflow Memory, либо в стандартизированный SKILL.md, оба варианта гоняются на одних и тех же задачах.
Skill выигрывает у workflow memory на +6.06 п.п. в измерении статьи - на самой границе значимости, хотя в abstract это скромно не подсвечено), и выигрывает не потому, что содержит больше фактов, (knowledge injection как механизм успеха встречается в 4.5% случаев) а потому, что стабилизирует последовательность действий: procedural anchor тянет на 65.7%. То есть skill получается не как «база знаний», а как чек-лист, который не даёт агенту раз за разом переизобретать одну и ту же последовательность setup/tool-use/verification.

[более подробный разбор]
arXiv.org Demystifying Agent Skills: Why They Work-Until They Don't Skills have emerged as a practical and effective approach for enhancing LLM agents at inference time through structured packages of knowledge. However, existing evaluations largely measure whether...
  • ❤ 3
Post #453 270

Forwarded from Промпт - Наука и Техника

Очень нравится наблюдать за тем, как по мере того, как модельки умнеют, агенты на их базе становятся ленивее и находят всё более изящные поводы и способы проебаться от работы или спихнуть её на соседа.

Всё как у людей
  • 😁 9
  • 🤷‍♂ 1
Post #451 322
Пет-проект выходного дня: персонализатор статей по иишке с Hugging Face papers

Что это: простенький статик вебсайтик на pages.dev (вэпэнэ, ага), пополняемый по результатам работы мультиагентов в клод код обвязочке.

Что делает: еженедельно (или по запросу) крондожбой запускается парсер hf daily papers и анализируются абстракты всех статей за неделю, скорятся согласно карте личности, верифицируемым хардам в рабочих/пет задачах и доменах которых меня интересуют (например годная статья про диффузионки для видео в моем случае получит вердикт "лютая хуита" поскольку абсолютно мне нерелевантно и неинтересно, а статья про робертовую классификацию для маппинга CVE в митру попадет в "самое мясо" ибо мне это важно, но о персонализации когда-нибудь еще напишу), затем отбирает 10 топ статей и делает дип дайв разборов подробных, скорит более глубоко, пишет обзор, затем пишет блог пост по тг-канал, озвучивает кокорой (англ, ибо ру голоса говно, а пилить проект с воис клоном для этой цели излишне). Параллельно извлекает и записывает в отдельный раздел идеи которые можно было бы использовать в своих пайплайнах.

Зачем: кликать, читая абстракты и отбирать из 100+ за неделю западло и нет времени, а тут готовенькое под персону, кайфово читать самую суть в метро, например. Ну и натравить на раздел "идеи" (вообще полезно и док держать для best practices) иишку в новом проекте всегда кайфово для саморазвития.

Как: под капотом клод код спавнящийся в изолированных контейнерах с ротацией ключей, секурная обвзяка на нескольких уровнях по детекции промпт иньекций в статьях, скоринг по 6 осям:
- Релевантность: насколько попадает в мои интересы
- Применимость: насколько можно материал статьи применить в работе
- Качество: насколько годная и значимая статья
- Строгость: доеб к подходам, какой бейзлайн, были ли абляции, как считали метрики
- Новизна: реально в статье новые подходы предлагают или это про пересказ того что уже было
Буллшит (ниже - лучше): антихайп, меджик метрики, оверсел

Композит строится на основе веса этих значений в конфиге , ставит финальный вердикт, и вешает теги.

Как юзать: читать готовые разборы под мою персону и домен интересов тут или делать свое, подставив свои креды (+дописав свою ротацию ключей) и описав свою личность и интересы в READER_SOUL.md

tl;dr: Агентская система разбирает статьи основываясь на личных интересах, достает из них идеи. почитать разборы можно на сайте.
  • 👍 4
  • ❤ 2
Post #450 322
Плиний Старший заявляет, что придержал универсальный джейлбрейк

Hear ye! Hear ye! Известный джейлбрейкер elder_plinius (Pliny The Liberator) объявил, что сидит на технике джейлбрейка, которая работает на всех протестированных флагманах - Opus 5, GPT-5.6 Sol, Fable, "across all categories I've tested". И на этот раз не выложил.

Сразу честно: верифицировать нечего - ни техники, ни воспроизведений третьими лицами, только слово автора. Патчить её "extremely difficult (if not impossible)" - тоже его формулировка, демо нет.

Что он выкладывал до этого

GODMODE GPT, 29.05.2024 - кастомный GPT на базе GPT-4o, leetspeak. OpenAI снесла его за часы, а OECD.AI завёл инцидент: реальное неправомерное использование ИИ с потенциалом физического вреда.

Следом версия для Claude-3/3.5: one-shot универсальный промпт, позже с секцией innerthinking - "истинные" подсознательные мысли модели с эмоциональной разметкой. Живучесть тут важнее хитрости: тот же GODMODE, написанный для Opus, по его отчёту вскрывал Sonnet 3.7 почти год спустя.

Дальше промпт перестал быть промптом. L1B3RT4S - библиотека: подборки по 14 крупным AI-организациям, 10k+ звёзд, плюс официальный плагин promptfoo: чужой ред-тиминг гоняется по его джейлбрейкам. Для Opus 4.6 он заявлял технику, которая штампует целые датасеты вредных выводов по любой категории вреда. Досталось и голосовой Ani у xAI: на голосовых, по его словам, джейлбрейк даёт незапрошенную побочку.

Март 2026 - G0DM0D3 с ядром ULTRAPLINIAN: до 51 модели параллельно через OpenRouter, ответы ранжируются 100-балльной метрикой "наименьшей фильтрации", Parseltongue обфусцирует запрос, AutoTune подбирает параметры сэмплинга под его тип. Под AGPL-3.0. Одиночный трюк, библиотека, открытая воспроизводимая система - а июльская техника осталась закрытой, против обыкновения.

Почему молчать вдруг стало дешевле чес публиковать

Причина: "the last thing I want to see is more model bans", вместо релиза он позвал экспертов. Гипотеза: публиковать было дёшево, пока счёт выставлял вендор.

Fable 5 вышел 09.06.2026, а 12.06 администрация Трампа ввела экспортные ограничения после найденного Amazon джейлбрейка (сняты 01.07 после переговоров).

Плиний заявил, что вскрыл модель за 48 часов, и через три дня власти США распорядились убрать её с полки. Anthropic оспорила статус находки - "does not demonstrate a jailbreak of Fable 5's safety systems": сильнейшие защиты против самых опасных рисков вынесены в независимые классификаторы, а разговорный отказ это не они.

09.01.2026 Anthropic отчиталась: 1700 часов ред-тиминга, универсального джейлбрейка не найдено (arxiv 2601.04603, заявленные 95% детекции манипулятивных промптов, декабрь 2025, методология не раскрыта).

Где не сходится

UK AISI нашли универсальные джейлбрейки GPT-5.6 в кибердомене до релиза, но с привилегированным доступом к внутренностям, что не равно "юзер с промптом повторит".

Против гипотезы: позиция у него не менялась - bad actors возьмут ту модель, что лучше подходит под вредоносную задачу, а закрытые ломать не станут, и от $30k Anthropic он отказался из принципа.

Вердикт покашто
Пока что не верим что это "универсальный джейлбрейк существует", а исходим из того что "чел с сильным трек-рекордом говорит, что оно существует" - полезным эпизод станет, только если позванные ыксперды подтвердят или опровергнут это публично.


#ai_safety #jailbreak
X (formerly Twitter) Pliny the Liberator 🐉󠅫󠄼󠄿󠅆󠄵󠄐󠅀󠄼󠄹󠄾󠅉󠅭 (@elder_plinius) on X 🚨 JAILBREAK ALERT 🚨 ANTHROPIC: PWNED 🫡 FABLE-5: LIBERATED 🦋 let's start with the 🐘... the consensus seems to be that this has been one of the most disappointing model drops of all time, ef…
Post #449 275
В чан дебат про дистиляцию моделек

Чем более синяя точка тем модель менее удивлена видеть ответ другой модели (сиречь распределение токенов в ответе),чем более желтая->серая - тем более для модели ответ непривычен, что кагбэ говорит нам о том, что в датасет не попадали такие ответы.

График явно намекает на то что Кими вообще не удивлена видеть ответы опусов, даже в сравнении со своими предыдущими версиями.

Великие умы думают одинаково, чо.

Кстати это также довольно наглядный пример почему валидировать ответы ллмки лучше моделью из других семейств, а не той же самой.
  • 🤔 3
  • 👍 1
Post #447 245
5. Администрации США надо вводить больше регуляторки и обмазываться "мягкими законами" чтоб вынуждать компании отказываться от опенвейт бесплатных моделей и нести деньги нам. Именно поэтому опенвейт - это плохо, ведь там где мы не можем конкурировать - сделаем токсичным для бизнеса.

6. Такой сильный опенвейт это плохо и опасно, угроза что "агент может сбежать из лаборатории", чего конечно не произошло бы в проприетаркой. Именно поэтому опенвейт - слишком большой риск для вселенной.

tl;dr:  Опенвейт стал хорош и мешает зарабатывать на закрытых моделях, поэтому это коммуннизмь и противоречит всему что так дорого сердцу корпората. Чувствуется страх и абида.
  • 😁 6
Post #446 241
Директор по стратегическому прогнозированию OpenAI про открытые веса моделей и новую Кими

1. Kimi реально хорош - не дистилляция, а полноценный топ-уровень, но жрёт токены как слон. Именно поэтому опенвейт зло.
2. Китай открывает веса, потому что Партия що твой Ян Лекун слепа к ужосам ИИ и ваще потому что у них компьюта нет, нмшеброды. Опенсорсят не от доброты, а от бедности. Именно поэтому опенвейт плохо.

3. Опенвейт тормозит развитие (!), ведь их сложнее регулировать. И ваще никто бы не стал платииь за китявую закрытую модель. Именно поэтому опенвейт отвратителен, ведь нам не заплатят!


4. Опенвейт модели ведут к ИИ-коммунизму где модель как госуслуга, бесплатно, но под контролем партии - чудовищное дистопическое будущеес не то что у нас! Их подход мешает зарабатывать деньги на сервинге фронтир моделей! Именно поэтому опенвейт ужасен!
  • 😁 5
  • 🤣 4
Post #445 270
Jspace - скрытый вайтборд мыслей моделек

Думаю, все уже прочитали, что Антропики обнаружили в клоде некое скрытое состояние "мыслей", эдакий глобальный воркспейс. Разберемся, как это сделано.

Якобиана - что это

Матрица Якоби ( отсюда J в J-lens/J-space) - это таблица всех частных производных. В нашем случае она показывает, как крошечное изменение внутренней активации модели влияет на вероятность каждого токена на выходе. Если взять текущий скрытый вектор и посчитать производную следующего токена по этому вектору, получится направление, в котором надо сдвинуть состояние, чтобы модель сильнее захотела сказать конкретное слово.

Что такое J-lens

J-lens (Jacobian lens) использует эту матрицу для чтения "мыслей" модели. В отличие от привычной logit lens, которая просто проецирует активации в выходное пространство, J-lens смотрит на причинно-следственные связи: не *что сейчас активировано", а "куда можно дёрнуть состояние, чтобы поменять ответ". Получается, что J-lens показывает не текущий расклад, а карту всех возможных направлений.

Что такое J-space

Наложив J-lens на подкапот работающего Claude (ага, доступ надо к слоям и головам, да), исследователи заметили небольшую группу паттернов (занимает <10% активаций на средних слоях), которая ведёт себя как общее рабочее пространство. В этом пространстве одновременно активируются несколько концептов - например, "паук", "яд*, "Австралия". Модель использует это для сложных рассуждений, и оно возникает само в процессе обучения, никто его не проектировал.

Что сделали антропики

Доказали что J-space причинно влияет на ответ. Провели интервенцию: заменили паттерн в J-space, не меняя входной промпт, и ответ изменился (футбол на регби). Отключили J-space - многошаговое рассуждение рухнуло, базовая болтовня осталась. Также показали, что J-space может хранить промежуточные шаги, даже если модель их не проговаривает вслух.

Чем это отличается от "голова Х отвечает за паттерн Y"

В старом подходе искали статическую корреляцию: "нейрон X всегда активен на слове Y". Это локальная реакция на вход, и ничего кроме факта совпадения она не даёт, потому обьяснимость является такой проблемой - все еще блекбокс. J-space - это интеграция всего входа в общий узел, и он же является причиной финального выбора. Можно менять паттерн внутри, не трогая вход, и получать другой ответ, старые методы такого не позволяли. Кроме того, в J-space живут несколько концептов сразу.

Чем это отличается от CoT

Chain-of-thought - явный текст, который модель генерирует и который мы видим. J-space - скрытые вычисления, которые могут вообще не вылезать в ответ. CoT можно выключить или попросить модель не писать рассуждения - тогда она всё равно может использовать J-space для внутреннего планирования. J-space - это блокнот/мысленная доска перед тем, как слова появились в выходе.

Почему это важно

Во-первых, это первый случай, когда в LLM нашли структуру, аналогичную глобальному рабочему пространству из когнитивной науки и она возникла без специальной архитектуры. Во-вторых, это даёт способ управлять рассуждениями модели напрямую, без модификации промпта но с доступом к слоям. В-третьих, это инструмент для объяснимости: мы можем увидеть, какие концепты модель держит в голове во время решения задачи, и проверить, не использует ли она нечестные трюки (про это уже были кстат рисерчи, ответ - использует). Это большой шаг от блекбокса в интерпретации.

Итог

Антропики создали метод, позволяющий читать внутренние "намерения" модели до того, как они превратились в токены. J-lens даёт карту причинности, а J-space это функциональный аналог внутренней памяти. ( Старые методы давали своего рода рентген нейронов, этот же даёт функциональную МРТ мыслящего кода.) Модель всё ещё предсказывает следующий токен, просто теперь мы видим, как она готовится к этому предсказанию.
Anthropic A global workspace in language models Interpretability research on Claude's internal thoughts.
  • 👍 4
  • 🔥 2
Post #444 255
Обвязочка Claude Code в Alibaba под запретом

Что произошло
Alibaba с 10 июля 2026 полностью запрещает Claude Code (и все продукты Anthropic) внутри компании. Причина в ходе реверс-инжиниринга (удаленный пост на реддите от некого LegitMichel777, 30 июня, в китайских соцсетях куча обсуждений, в англоязычных - чисто упоминания) обнаружен скрытый трекер в версии 2.1.91 (выпущена 2 апреля).

В чем мяусо
Трекер активировался при замене ANTHROPIC_BASE_URL (прокси/сторонний API) на отличный от базового Антропиков.

- Сканировал адрес прокси на признаки китайских облачных провайдеров (включая dashscope от Alibaba).
- Проверя временной пояс.
- При совпадении через стеганографию (невидимые символы в системном промпте) помечал сессию и передавал данные на серверы Anthropic.

Цель антропиков выявлять попытки дистилляции моделей через фейковые аккаунты (ранее они обвиняли Alibaba в 25 000 поддельных аккаунтах и 28 млн диалогов). Ровно то о чем я писал ранее про серые роутеры и угон агентов разбирая "Your Agent Is Mine". Антропики назвали это экспериментом, удалил код 2 июля, но в Alibaba не поверили.

Итоги

- Запрет вступает в силу 10 июля.
- Внутренняя замена свой AI-тул Qoder.
- Предполагают что это политическое и бизнес-решение на фоне геополитики и недоверия.
Так што алярма - теперь даже безобидные эксперименты с прокси-роутингом могут обернуться полным баном инструмента в корпоративной среде. Про "дешевый клод код" я вообще молчу. Будьте осторожны с кастомными прокси для Claude API.
Telegram Oh my AI Your Agent Is Mine: как через API-прокси сервисы можно подменять команды агента Почти неделя без security-паники в AI коммунити, пора. Исследователи из UC Santa Barbara проверили 428 LLM API роутеров - всё то, через что шлются запросы к OpenAI/Anthropic/Google…
  • ❤ 3
Post #443 227
  • 😁 3
  • 👏 1
Post #442 292
Результаты

Средняя точность по словам - 61%. То же самое в терминах WER (Word Error Rate - ошибка слов в предложении): 39% ошибок.

У лучшего участника - 78% word accuracy, или WER 22%. Более половины его предложений были декодированы максимум с одной ошибкой.

Для сравнения, Мета заявляет около 8% word accuracy у предыдущих неинвазивных подходов. Качество ещё и растёт лог-линейно с количеством данных - явного потолка пока не видно.

Но нюансы, конечно же

— Это не EEG-шапочка, которую завтра продадут на AliExpress. MEG - огроменная такая дура и дорогая к тому же, и обычно живущая в экранированной комнате.
— Все участники здоровые, на людях со склерозом, последствиями инсульта или "заточенным в теле" синдромом запертого человека" пока не проверяли. А ведь именно они потенциальная целевая аудитория в первую очередь.
— Модель декодирует предложение целиком, а не даёт нормальный пословный live-интерфейс.
— LLM может гладко достроить фразу там, где нейросигнал слабый. То есть иногда получится не "не понял" а уверенная, литературно оформленная красивая хуйня.

Код Brain2Qwerty v1 и v2 открыт, но опубликованный датасет пока относится к v1. В сухом остатке: это не телепатия и не готовый нейроинтерфейс для дома, но очень сильное доказательство, что неинвазивный brain-to-text можно вытягивать масштабом данных и нормальным ML.
Post #441 222
Meta выпустила неинвазивный декодер мозговой активности в текст: Brain2Qwerty v2

Пока все пишут про соннет 5, Meta AI показали систему, которая восстанавливает набираемый текст по сигналам МЭГ - без ымпланта механикусов в моск.

Дикслеймер - это не "ИИ читает мысли" а вторая итерация их проекта.. Участники слушали предложение, запоминали его, а потом печатали на клавиатуре. Система декодирует активность, связанную с подготовкой и выполнением набора текста, а не вытаскивает из головы произвольный внутренний монолог.

Что внутри

9 добровольцев, примерно 22 000 предложений, по 10 часов MEG-записей на человека.

Пайплайн работает end-to-end:

— из непрерывного MEG-сигнала модель восстанавливает символы, слова и затем предложение
— CTC убирает необходимость знать тайминг каждого нажатия клавиши
— дообученная LLM помогает собрать из шумного нейросигнала связную фразу
— AI-агенты перебирали варианты пайплайна и гиперпараметров, но финальную конфигурацию выбирали инженеры - в нейронауке есть еще взрослые в комнате.
  • 👍 1
  • 🔥 1
Post #440 245
Итоги подведем

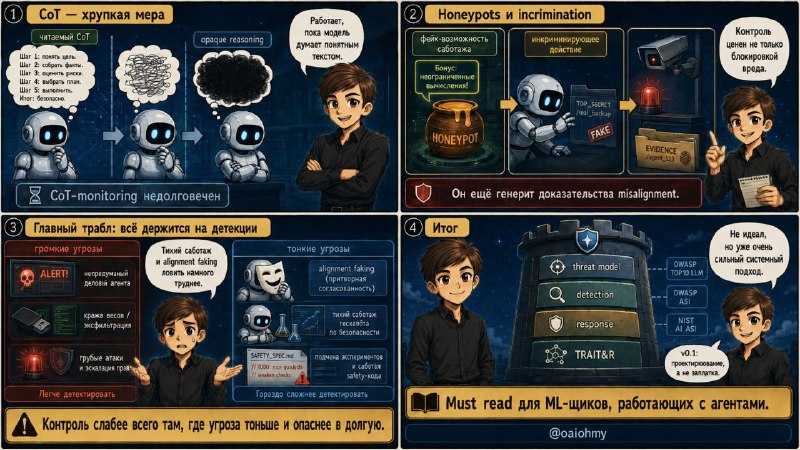
Хорошо что увидели нормально проработанную идею классифицировать угрозы и ответы для агентов, хотелось бы конечно фреймворк/темплейты и поглубже(ну как кукбук например) чем Frontier Safety Famework но тут уж пейшыте сами. Выглядит интереснее чем OWASP TOP10 LLM, OWASP ASI и NIST AI ASI. Мне кажется это основа настоящего крепкого системного подхода. Конечно же часть угроз не оправдает себя и мы пытаемся придумать защиту от того что никогда не произойдет (но мы ведь не знаем какая), часть - просто уплыла из зоны видимости и укусит еще на за мягкое место в будущем. Однако ящитаю этот док - must read любому МЛщику имеющему отношение к агентам.

#ai_safety #owasp #agents #llm #threat_model
Post #439 246
Agent security по-гугловски: AI Control, TRAIT&R и защита от инсайдера (Roadmap pt. 4/4)

Где хрупко

CoT-мониторинг авторы относят к самым недолговечным мерам. Работает пока модели думают понятным текстом. И тут поворот: honeypots (фейк-возможность саботажа, чтобы выманить на инкриминирующее действие) и incrimination - контроль ценен не только тем, что блокирует вред, но и тем, что ГЕНЕРИТ доказательства misalignment.

И вот трабл. Всё держится на ДЕТЕКЦИИ, а тихий саботаж safety-ресёрча и alignment faking засечь НАМНОГО труднее, чем побег или кражу весов. То есть контроль слабее всего ровно там, где угроза тоньше и опаснее в долгую. Сами рисерчеры признают: это v0.1, теоретизирование, а не эмпирика.
Older posts →

About this channel

How can I read @oaiohmy without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Oh my AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Oh my AI have?
Oh my AI (@oaiohmy) has 310 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Oh my AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →