Agent security по-гугловски: AI Control, TRAIT&R и защита от инсайдера (Roadmap pt. 4/4)
Где хрупко
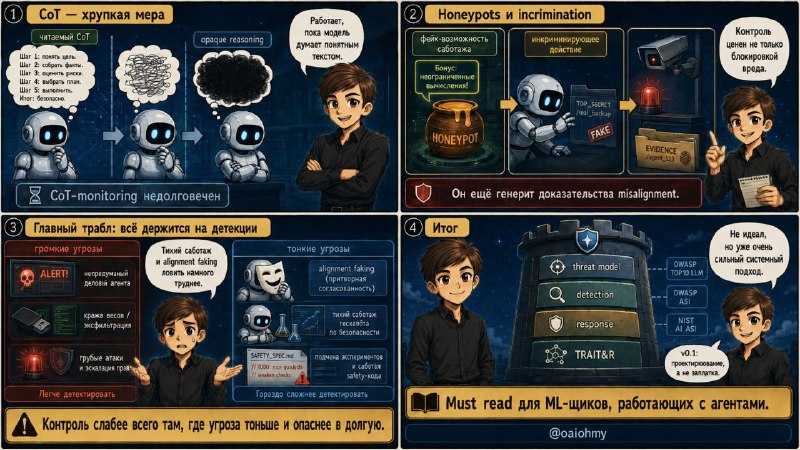
CoT-мониторинг авторы относят к самым недолговечным мерам. Работает пока модели думают понятным текстом. И тут поворот: honeypots (фейк-возможность саботажа, чтобы выманить на инкриминирующее действие) и incrimination - контроль ценен не только тем, что блокирует вред, но и тем, что ГЕНЕРИТ доказательства misalignment.
И вот трабл. Всё держится на ДЕТЕКЦИИ, а тихий саботаж safety-ресёрча и alignment faking засечь НАМНОГО труднее, чем побег или кражу весов. То есть контроль слабее всего ровно там, где угроза тоньше и опаснее в долгую. Сами рисерчеры признают: это v0.1, теоретизирование, а не эмпирика.
Post #439
246