TGViewer
Channel Public Channel
Николай Тузов

Николай Тузов

@ntuzov

Go Developer, автор YouTube канала по Go: https://www.youtube.com/@nikolay_tuzov

Live канал: @ntuzov_live
AI News: @tuzov_ai_lab
Go Digest: @golang_digest

Обратная связь: @justskiv

Поддержать:
https://boosty.to/nikolay.tuzov/
https://t.me/ntuzov/126
Subscribers
16.9K
Photos
270
Videos
19
Links
341
Recent Posts 20 shown
Post #930 7.64K
Дописал самый большой кусок статьи про Go 1.27 — раздел про постквантовые подписи.

В 1.27 приехал пакет crypto/mldsa и вся обвязка вокруг него (сертификаты, TLS). Обмен ключами добавили ещё в 1.24, а теперь очередь дошла до аутентификации — то есть на чистом Go наконец-то полностью собирается постквантовый хендшейк 🎉

Обычно этому разделу в обзорах уделяют незаслуженно мало внимания — многие плохо понимают в чём тут суть, и кажется, что это касается каких-то мифических "специалистов по безопаности". А те кто разбираются чуть лучше, думают что чесаться ещё рано, потому что достаточно мощных квантовых компьютеров ещё не существует. Но на самом деле, это касается всех нас уже сейчас.

В новом разделе я написал подробный ликбез про постквантовую криптографию, а также объяснил почему это актуально уже сейчас.

Также я там рассказал:

- Почему главная проблема ML-DSA — размер, а не скорость
- Зачем в crypto.Hash появилось значение MLDSAMu (которое хеш-функцией не является)
- Что со всем этим делать прямо сейчас

Сниппеты, как обычно, запускаются прямо со страницы статьи на актуальном go1.27. Можно сгенерировать ML-DSA-ключ, подписать сообщение и посмотреть, во что превращается минимальный самоподписанный сертификат: почти четыре килобайта против 217 байт у Ed25519. Бюджет TLS-хендшейка я нарисовал отдельным наглядным виджетом 🦄

Да, статья всё ещё не дописана, работаю над ней прямо сейчас. Остались рантайм, net/http, SIMD, тулинг и раздел про то, что может сломаться при апгрейде.

————

Возился с этим разделом дольше, чем с любым другим в статье: криптография — не та область, где можно писать по памяти, каждый абзац сверялся со стандартами, документацией и т.п.. Надеюсь, вам понравится ❤️

Начал писать про один пакет, а закончил рассказом про алгоритм Шора и решётки 😩

Кстати, если хочется отдельного разбора — как вообще устроены обмен ключами, подписи и шифрование, напишите в комментариях. Если тема востребована, сделаю. Ну и про постквантовую криптографию можно подробнее рассказать, раз уж я в это погрузился.
GoLang Guides Go 1.27: большой интерактивный разбор Разбор Go 1.27 по draft release notes: дженерик-методы, движок encoding/json/v2, пакет uuid в stdlib, постквантовые подписи crypto/mldsa и профиль утечек горутин в pprof.
  • 👍 26
Post #929 7.5K
Николай Тузов 😐 Ультимативный разбор... Go 1.27? Честно, не знаю зачем я это сделал, но я сделал.. Ну почти. https://golang.guide/go-1-27/ Сначала я решил просто написать базовый обзор релиза. Но потом я увлёкся и не смог вовремя остановиться. Мне хотелось не просто…
Нельзя мне браться за обзоры релизов... Вместо небольшого раздела по постквантновые подписи в Go 1.27, я написал по небольшой гайд постквантовой криптографии...

Сегодня-завтра постараюсь обновить статью и опубликовать этот раздел.

Ну ладно, зато было весело 👍
  • 🔥 92
Post #927 17.8K
😐 Ультимативный разбор... Go 1.27?

Честно, не знаю зачем я это сделал, но я сделал.. Ну почти.

https://golang.guide/go-1-27/

Сначала я решил просто написать базовый обзор релиза. Но потом я увлёкся и не смог вовремя остановиться.

Мне хотелось не просто сухо рассказать об изменениях, а добиться глубокого понимания читателя — причины этих изменений, какие проблемы они решают, как реализовано, почему именно сейчас, какая история стоит за самыми интересными фичами. При этом, я старался писать так, чтобы всё это читалось интересно и легко.

В итоге, работа над статьёй так сильно затянулась, что когда она выйдет, сам релиз уже никому не будет интересен. Поэтому я решил опубликовать ту её часть, которая уже готова — это примерно 60%, и туда вошло всё самое интересное и важное:

- Дженерик-методы, которые десять лет обещали не добавлять
- Новый движок JSON v2
- Пакет uuid наконец-то в стандартной библиотеке
- Детектор утечек горутин, который переиспользует сборщик мусора — на мой взгляд, самое красивое, что есть в этом релизе

Во вторую половину войдут: постквантовые подписи, рантайм, net/http, SIMD и тулинг. Это я дописываю прямо сейчас, оно появится в той же статье.

Все код-сниппеты запускаются прямо из статьи на актуальном go1.27. Каждый из них можно редактировать и экспериментировать — не нужно открывать отдельный плэйграунд. А ещё я подготовил для вас наглядный виджет с демонстрацией механики работы детектора утечки горутин.

Я потратил на эту статью ОЧЕНЬ много времени. Возможно, стоило потратить на более фундаментальный гайд — тот же GC, над которым я также сейчас работаю. Но надеюсь, вам всё же понравится ❤️
Стоит ли писать подобные обзоры про новые релизы?

————

А ещё я прикрутил к сайту email-рассылку (и письмо про Go 1.27 туда ушло сильно раньше этого поста) и комментарии к статьям. Если вдруг заметите какие-то баги, пишите в комментариях, постараюсь оперативно поправить.

И не хулиганьте в комментариях на сайте!
👍

#article #go1_27
  • 🔥 85
  • 👍 1
Post #924 12.6K
👴 Посоветуйте хорошего бухгалтера на аутсорс в Казахстане, в идеале в Астане

Рынок у нас маленький, и хороших специалистов найти сложно. При этом, сейчас многие разработчики работают по ИП, и наверняка часто делегируют ведение бухгалтерии профильным специалистам.

Если у вас есть на примете хорошие проверенные специалисты, поделитесь контактом, пожалуйста.

Можно в ЛС: @justskiv
  • 👍 1
  • 🔥 1
Post #915 20.9K
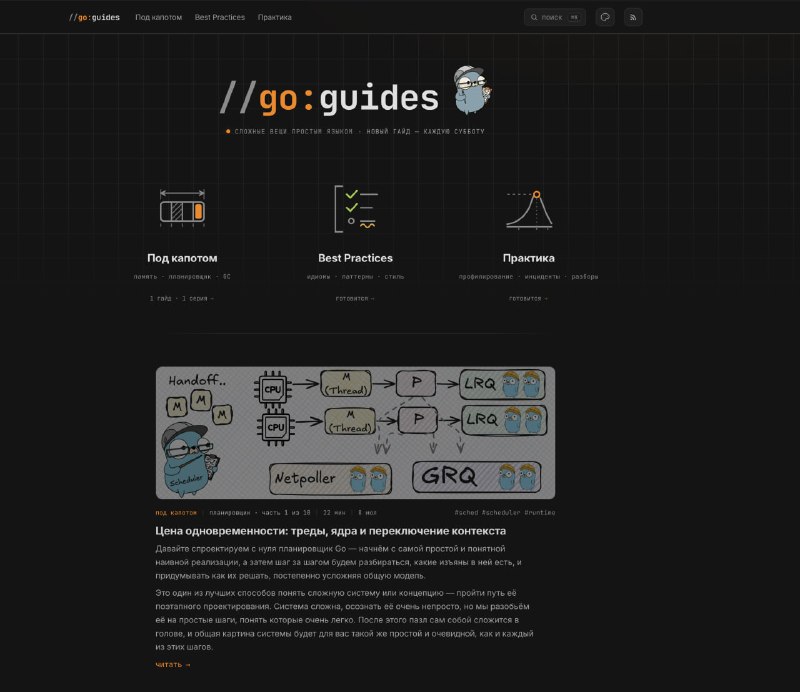
🦄 Опубликовал платформу для гайдов и первую статью

https://golang.guide/

Надеюсь, вам понравится, я очень старался ☀️

Там всего один единственный гайд — первая часть серии статей про Планировщик. Даже если вы читали оригинальную статью, или смотрели ролик, всё равно советую перечитать — тут полный ремастер и режисёрская версия с интерактивом 👍

Остальные статьи уже в работе. Буду выпускать их по мере сил.

Советую читать с десктопа — там пока больше фич, чем на мобилке.

Если заметите какие-то баги или проблемы — пишите, поправлю.
GoLang Guides Сложные вещи простым языком
  • 🔥 410
Post #914 13.6K
Николай Тузов 🦄 Платформа для гайдов, о которой я давно мечтал Видение того, как должен выглядеть сайт с гайдами / курсами у меня сложилось довольно давно, и все эти годы продолжало эволюционировать. Но вот в чём проблема — видение то было, но возможности реализовать…
В последние дни работаю чуть ли не по 16 часов над этим проектом — мой перфекционизм не даёт мне покоя. Делаю одну правку, и тут же ещё десяток идей возникает в голове.

Сейчас мне всё более-менее нравится, второстепенное отложил на потом.

Планирую сделать релиз завтра в первой половине дня. Ну, я надеюсь на это 😩
  • 👍 238
  • 🔥 73
Post #912 15.8K
🦄 Платформа для гайдов, о которой я давно мечтал

Видение того, как должен выглядеть сайт с гайдами / курсами у меня сложилось довольно давно, и все эти годы продолжало эволюционировать.

Но вот в чём проблема — видение то было, но возможности реализовать его не было, потому что:

- Из меня ужасный дизайнер — я могу объяснить чего и как хочу, и сказать "красиво" или "не красиво, но сделать красиво самостоятельно не получается

- Я далёк от фронтэнда — что-то знаю, но опыта мало. На полноценный проект уйдёт много времени, а результат будет плохой

- Свободного времени было так мало, что лучше потратить его на что-то более приземлённое

Нанять настоящего верстальщика и дизайнера я бы не потянул, т.к. все мои проекты строятся на чистом энтузиазме, и почти не монетизируются.

Что ж, времени у меня теперь сильно больше, а дизайнера и верстальщика мне заменил Claude — с недавних пор он стал в этом невероятно хорош. Все блокеры сняты, наконец-то можно свободно творить. И я сотворил 👍

————

Как должна выглядеть "платформа моей мечты", чего мне все эти годы не хватало:

- 💅Дизайн строго по моему вкусу — я очень падок на визуал, и крутой дизайн очень меня мотивирует. Словами мне это сложно описать, чуть позже сами увидите.

- Лёгкая сборка — статичный сайт, который собирается из md-файлов — в идеале, Hugo, конечно же. Сайты получаются очень лёгкие и их поддержка почти ничего не стоит.

- Наличие интерактивных виджетов и пошаговой анимации. Часто бывает так, что какую-то концепцию проще "показать", а не описать словами и ли нарисовать. Дать читателю это "пощупать", поиграться. Это может заметно сократить размер статьи, и при этом сделать её понятней, интересней, наглядней. Мне этого очень не хватало, когда я писал статью про планировщик.

- Удобная работа с "сериями" статей. Опять же, на Хабре и других платформах таких механизмов нет вовсе, и поэтому мне проще написать монолитную статью, чем делать из неё неудобный сериал. Но наличие такого механизма сильно упростило бы жизнь как мне, так и читателям.

- Интерактивное содержание (TOC) — такое уже много где есть, но вот на Хабре, увы, нет. В случае больших статей без него вообще ни как.

- Минимализм. Да, после всего вышеперечисленного кажется, что слово "минимализм" тут неуместно. Но я под этим подразумеваю, что на сайте должно быть только то что действительно улучшает пользовательский опыт, и ничего лишнего

Это основные моменты. Кроме них, есть ещё множество мелочей, которые суммарно дают огромный вклад — удобный быстрый поиск по материалам, несколько цветовых тем на выбор (не всем удобно читать только на белой/черной теме), режим "фокусирования" (когда на экране нет ничего лишнего, кроме текста статьи) и др.

————

Что ж, на днях я полностью закончил разработку такой платформы, и сейчас активно наполняю её контентом.

Для начала, я хочу перенести в неё мои имеющиеся материалы — разбор планировщика, написание grpc / rest api сервисов, а также разбор каналов и map (по ним статей ещё нет, только ролики — теперь будут).

Все эти материалы я попутно актуализирую и дополняю — за годы я многому научился, есть что добавить. Кроме того, теперь мне не мешают "технические ограничения" других платформ.

Короче, мои старые работы скоро получат "режиссёрскую версию" 👴

Релиз первой статьи будет примерно на днях, а пока можете полюбоваться красивой заглушкой 💅

#анонс
  • 🔥 171
  • 👍 32
Post #909 20.8K
☀️ Мой путь в IT — статья

https://tuzov.dev//posts/my-way-to-it/

Наконец-то закончил очередную переработку одной из своих серий постов в большую статью. Как и в прошлый раз, я не просто склеил посты, а проработал текст намного лучше.

❤️Хороший повод прочитать или перечитать, если вам нравится такой жанр

В посте упоминается, что я перенёс все свои старые детские программы в веб. Мне надо чуток причесать это дело, после этого опубликую и напишу отдельным постом.

#статья #live
Николай Тузов - блог Мой путь в IT Итак, впервые я увидел и пощупал настоящий персональный компьютер в гостях у родственников. Это было примерно в 2000-м году, и в наших краях ПК был той ещё диковинкой. Мне показали как пользоваться клавиатурой, мышью и оставили одного. Я был безумно счастлив!…
  • 🔥 26
Post #907 19K
Tuzov AI Lab 🤖 LLM под капотом: трансформер. Часть 2 Серия #llm_internals В прошлом посте мы разобрались, как промт превращается в набор векторов и потом прогоняется через стопку блоков, обновляясь под контекст. На выходе у нас та же последовательность векторов, но числа…
В последнее время меня всё больше беспокоит одна вещь — все эти разговоры про применение LLM похожи на гадание на хрустальном шаре. Мы пытаемся с умным видом рассуждать о моделях, при этом всё что мы о них знаем — то что они каким-то хитрым образом рожают нам ответ. Колдунство, не иначе.

На старте, когда всё это только зарождалось, оно так сильно не беспокоило. Сейчас же мы выстраиваем очень сложные воркфлоу работы, делаем далеко идущие выводы, сравниваем модели, рассуждаем об их применимости — "большой контекст это плохо" (почему?), "это модель сильнее" (почему?),"с этой моделью правильно работать вот так" (почему?).

Ну то есть, мы машем руками, смотрим как эта штука себя ведёт, а дальше начинаем чувствовать себя экспертами, "специалистами в AI-инженерии". Мне кажется, это довольно опасная дорожка.

Поэтому я в последнее время стараюсь всё сильнее углубляться во внутреннее устройство LLM, чего и вам советую. Не обязательно становиться экспертами ещё и в этой области, но какое-то базовое понимание иметь стоит.

По мере моего погружения, буду стараться вводить и вас в курс дела такими вот постами. Как допишу серию, соберу её уже в большую статью.

————

🟢Это не упрёк к кому-либо, а просто мой личный дискомфорт. Возникают ли у вас такие же мысли?
  • 🔥 106
  • 👍 52
Post #906 13.6K

Forwarded from Tuzov AI Lab

🤖 LLM под капотом: трансформер. Часть 2

Серия #llm_internals

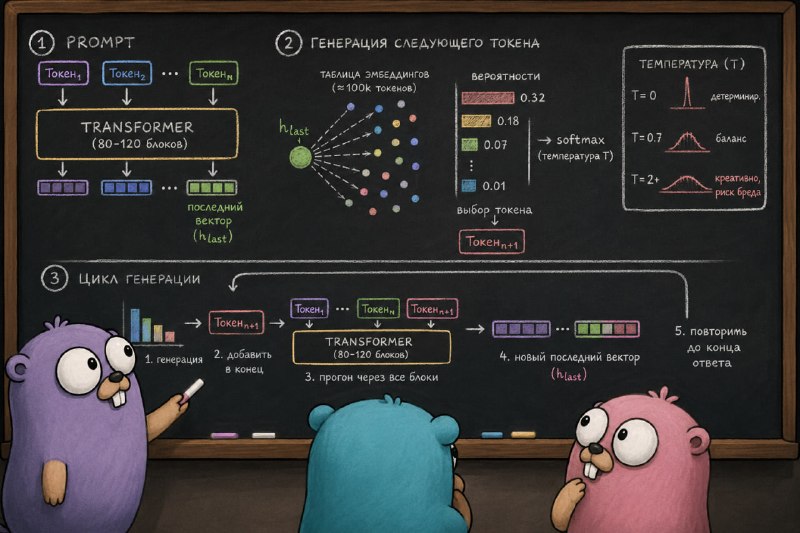
В прошлом посте мы разобрались, как промт превращается в набор векторов и потом прогоняется через стопку блоков, обновляясь под контекст. На выходе у нас та же последовательность векторов, но числа в каждом — уже совсем другие. Особенно интересен последний — в нём «спрессована» информация обо всём промте.

Теперь обсудим самое главное — как из этого вектора рождается следующий токен

Шаг 3. Генерация следующего токена

Итак, у нас есть исходная последовательность токенов из промта, и мы хотим сгенерировать следующий токен. Как это сделать?

На самом деле, у нас уже всё для этого есть — модель просто берёт наш последний вектор (соответствующий последнему токену промта) и сравнивает его со всеми векторами таблицы эмбеддингов. Грубо говоря, она перебирает все известные ей токены, и смотрит насколько близки их вектора к нашему последнему вектору.

В итоге, в качестве следующего токена, она выберет какой-то случайный — но чем ближе его вектор к нашему, тем выше его шансы.

Чтобы окончательно уложить это в голове, давайте снова упростим картину.

Вернёмся к нашему 3-мерному пространству. Представьте, что в нём раскиданы 100 точек — это таблица эмбеддингов модели. А ещё где-то в этом пространстве висит особая точка — это наш последний вектор после всех преобразований. Модель измеряет, насколько он близок к каждой из 100 точек таблицы. И чем ближе точка из таблицы к нашему вектору, тем выше её шансы стать нашим следующим токеном.

В реальности — пространство 12000-мерное, точек около 100k, но принцип тот же.

Итак, у нас есть оценка близости к нашему вектору для всех токенов словаря. Дальше из этого набора выбирается итоговый токен. По умолчанию — самый вероятный (то есть, ближайший).

Но можно специально внести случайность — за это отвечает параметр «температура».

На температуре 0 модель всегда берёт самый вероятный токен (детерминированный режим). Чем выше температура — тем чаще модель отклоняется от очевидного варианта в сторону менее вероятного. На 2+ это уже почти полная фантазия — повышается риск генерации полного бреда, зато ответы интереснее и креативнее 👍

Что дальше?

А дальше — повторяем цикл:

1. Выбрали следующий токен (генерация)
2. Добавили его в конец промта
3. Снова прогнали всё через все блоки (преобразования)
4. Получили новый последний вектор
5. Возвращаемся к п.1
....
И так до конца ответа.

То есть, для каждого нового токена ответа модель проделывает колоссальный объём вычислений:

1. Перебирает все токены словаря (генерация — сравнение с последним)

2. Прогоняет новый токен через все 80-120 блоков — это нужно, чтобы подготовить его вектор для следующей итерации. В каждом блоке attention сравнивает его со всеми предыдущими токенами — а их с каждым шагом всё больше.

И чем длиннее ответ — тем дороже становится генерация следующего токена. Именно поэтому большие LLM такие дорогие в инференсе.

————

Что ж, вот и весь трансформер. Оказывается, не так уж и сложно 👍

В следующем посте детально разберём сам механизм attention. Та самая операция, ради которой эта серия и пишется.

#llm_internals
  • 🔥 23
  • 👍 3
Post #905 12.6K
📆Где я узнаю актуальные новости про AI

Новые модели и ИИ-инструменты выходят так часто, что стоит пару дней не следить за новостями, и всё — ты безнадёжно отстал.

Без преувеличения скажу, что AI for Devs — мой любимый новостной канал этой тематики. Я подписан на многие подобные каналы, но только здесь я до сих пор не отключил уведомления.

Читаю его довольно давно, канал авторский, все посты строго по делу, отличная подача (инженерный минимализм, ничего лишнего), и всегда свежие актуальные новости.

@ai_for_devs

🫶 Не реклама, честная рекомендация
Telegram AI for Devs По сотрудничеству пишите в личные сообщения канала. Канал для разработчиков про AI. Модели, ИИ-агенты, практические кейсы и новости из мира AI. Всё, что можно применить в работе.
  • 👍 28
  • 🔥 13
Post #903 16K
🥂Новый сайт подкаста GoGetPodcast

Наконец-то я его доделал 😩

Я давно вынашивал множество интересных идей для сайта, но времени катастрофически не хватало. Сейчас же в компании ИИ-агентов, да ещё после увольнения, я в кои-то веки смахнул пыль со своего длиннющего бэклога, и началось...

Итак, что там нового и интересного:

1. Он наконец-то выглядит прилично!

Раньше это была просто топорная тема для блога на VuePress. Выглядело очень грустно, но изначально меня хватило только на "работает и ладно..". Нужен был хоть какой-то кривой-косой лэндинг для проекта.

Теперь же это полноценная платформа, заточенная именно под подкаст.

Ну и в целом, там очень много мелочей, над которыми я долго работал. Например:

- Встроенный плеер со всем необходимым функционалом, включая переход между главами
- Несколько тем внешнего вида (не только светлая и тёмная, чтобы угодить всем эстетам)
- Детально проработанные превьюшки для соц. сетей при шаринге ссылок

И многое другое. Всё это я описываю на странице обновлений (но я начал её вести только позавчера)

2. Полный список всех ресурсов, которые обсуждались в выпуске

Это ОЧЕНЬ не хватало.

Порой у нас в разговоре проскакивали буквально десятки разных сервисов, книг, проектов и других ресурсов. И слушатели постоянно просили собрать их в одном месте. Но в описание под роликом такое не впихнёшь, писать каждый раз отдельный пост в Telegram не хочется, да и просто читать глазами огромный текстовый список мало кому интересно.

Теперь у каждого выпуска есть удобная страница ресурсов — с фильтрами, поиском, сортировкой, пояснениями о том, кто и в каком месте что упомянул. К каждому ресурсу прилагается комментарий и ссылка на главу, в которой он обсуждался.

3. Разбор сложных понятий из выпуска

Это то, чего мне самому очень не хватает в других подкастах.

Список карточек с самыми интересными и сложными понятиями из выпуска, с разбором, пояснениями и комментариями. Эдакий конспект, который хочется перечитать, не переслушивая весь выпуск заново.

4. Статистика и аналитика 🦄

Честно — это больше баловство, но мне нравится ✨

Можно посмотреть, кто из спикеров больше всех говорил, насколько больше, посмотреть разные графики, метрики.. Полезного в этом мало, зато прикольно.

Для всего вышеперечисленного построен удобный пайплайн, благодаря которому я могу делать всю обвязку для новых выпусков в день их выхода.

Я планирую развивать его и дальше. Например, объединить ресурсы в большую библиотеку, а понятия в общую "энциклопедию" подкаста (хз как ещё это назвать 🗿), и добавлять новые фичи.

————

Списки ресурсов и понятий я формирую полуавтоматически: первые этапы выполняет LLM, а дальше я допиливаю всё руками, чтобы результат был интересным и полезным.

🟠Времени это занимает прилично, поэтому пока они доступны только для нескольких последних выпусков. Постепенно буду заполнять и остальные.

На сайте наверняка ещё есть баги и просто кривые места, особенно в мобильной версии, но я буду постепенно всё это допиливать.

#gogetpodcast
GoGetPodcast GoGetPodcast — подкаст о Go, разработке и инженерии Подкаст о Go и разработке: разборы выпусков, темы, ресурсы и аналитика.
  • 🔥 69
  • 👍 5
Post #902 21.4K
🥂Большой выпуск про PaaS — как Avito и Plata строят платформу для разработки / GoGetPodcast

- Видео
- Ссылки на аудио-площадки

Когда-то давно я часто ходил на IT конференции, и один из немногих запомнившихся мне докладов был про PaaS Авито. Очень впечатлило, как у них там по нажатию одной кнопочки происходят сложные автоматизации процессов.

К сожалению, поработать у них и пощупать это руками мне так и не довелось, поэтому я решил пообщаться с лидом команды DevSupport их платформы — Владом. А чтобы было ещё интересней, мы с моим бывших коллегой Ильдаром сравнили всё это с начинаниями в Plata, которая тоже активно строит свою платформу.

Участники:

- Владислав Сикач, тимлид команды DevSupport в Авито
- Ильдар Карымов  , инженер команды Developer Experience в Plata

🟢Все ссылки, упомянутые в выпуске, и разборы сложных понятий есть на сайте подкаста

#gogetpodcast
YouTube Тысячи сервисов и одна платформа — PaaS в Avito и Plata Большой выпуск про PaaS — Platform as a Service. Как Avito и Plata строят внутренние инструменты, которыми каждый день пользуются сотни инженеров. В Avito зрелая и большая платформа, а Plata — молодой банк, который делает первые шаги в эту сторону. Все ссылки…
  • 🔥 26
  • 👍 1
Post #901 15.6K
Николай Тузов Вот как выглядел наш маршрут 8 дней, ~70км, ~5км набор высоты Я сам записывал трек через Relive, так что это не общий рендер, это именно мой путь 🏃 Самый сложный маршрут в моей жизни - огромные наборы и сбросы высот, длительные переходы каждый день, суровые…
🏔Большая Алматинская Кругосветка — собираем группу

Я планирую ещё раз сходить в поход по горам Алматы, по тому же маршруту (подробнее здесь). В этот раз пойдём группой из одних только гоферов 🔨 (не считая гида). Группа практически собрана, осталось 2-3 свободных места.

🟢Если хотите присоединиться, оставьте заявку здесь

Когда: ориентировочно начало или середина августа. Точные даты согласуем вместе, когда группа полностью соберётся.

Да, маршрут довольно сложный. Без подготовки будет тяжеловато, но если ты в хорошей физической форме, то пройти его вполне реально. Специально готовиться не обязательно, но лишним точно не будет — меньше придётся страдать по пути 😩

В любом случае, с нами будет крутой опытный гид, который отлично знает этот маршрут. Во все свои горные походы я ходил только с ним.

Экипировку придётся покупать / искать самостоятельно, но мы с этим поможем — будет общий чат, плюс перед выходом вместе сходим в туристический магазин в Алматы и купим все необходимое. Из дорогого — палатка, хороший рюкзак и спальный мешок. Что-то из этого можно будет взять в аренду у гида, будем смотреть по ситуации.

Особенно будем рады местным алматинцам, которые тоже хорошо знают этот маршрут ❤️

Если есть вопросы, пишите в комментариях, отвечу.

————

БАК — это мой самый сложный, но самый любимый маршрут из всех, которые я прошёл. Дошёл с трудом, т.к. почти не готовился. Но это первый маршрут, который я очень хочу повторить.

Лучший способ отдохнуть от новостей, от работы и от ИИ, вдали от цивилизации. Связи там практически нигде не будет, так что информационный детокс получится добровольно-принудительный ✨
  • 🔥 48
  • 👍 3
Post #900 16.2K
Николай Тузов Chat Опять пошел новый цикл на чем валить на собесах, скоро будет ассемблер и книги кнута, новую мапу и бит манипуляции и новый сборщик уже все зазубрили же, как отклонить 999 откликов из 1000?
По мотивам комментариев
  • 🔥 55
Post #898 16.1K
🖥 Виртуальная vs Физическая память

Продолжаем говорить про память. В прошлых постах мы спроектировали Stack и Heap. Но то была картина изнутри программы. Теперь поднимемся на уровень выше и посмотрим, как всё это выглядит со стороны ОС.

————

Снова надеваем каску инженера. Наша команда проектирует операционную систему, и нам поручили разобраться с менеджментом памяти — нашей ОС доступен определённый её объём, и его нужно каким-то образом распределять между процессами.

Попытка 1: Нарезаем RAM — прямой доступ

Самое простое решение — поделить физическую RAM на кусочки: программе A отдадим адреса 0x0000–0x1000, программе B — 0x1000–0x2000, и так далее.

На первый взгляд, всё работает, но... Сразу же вылезает огромный букет проблем.

1. Безопасность: Что мешает Программе А обратиться к адресу программы Б и прочитать пароли из её памяти? Ничего. А если она туда что-то запишет, то Программа Б просто сломается.

2. Изоляция и адресация: Компилятору нужно заранее знать, по каким адресам будут лежать переменные, чтобы скомпилировать код. Но мы не можем заранее знать, какие физические адреса будут свободны в момент запуска программы 🗿

🟢Очевидно, что напрямую пускать процессы к железу нельзя. Думаем дальше.

Попытка 2: Иллюзия одиночества — базовый адрес и граница

Что ж, забираем у программы прямой доступ к адресам. Мы всё ещё будем присваивать ей какую-то область, но адресуем сами. То есть, каждая программа будет думать, что ей доступна вся доступная память: от 0x0000 до capacity. К примеру, [0x0000, 0x1000]. Мы же просто добавляем соответствующее смещение и следим, чтобы программа не вылезала за свои пределы.

Допустим мы выдали программе диапазон [0x3000, 0x4000]. Сама она при этом работает с адресами [0x0000, 0x1000]. Когда программа обращается к ячейке 0x0050, мы просто добавляем к ней смещение +0x3000 и получаем адрес: 0x3050. А если она просит больше, чем ей доступно, выдаём ошибку.

Это уже лучше! Но вылезает ещё более коварная проблема — фрагментация.

Представьте, что у вас 1гб памяти, и вы запустили 500 мелких программ, которым нужно ~2мб. В итоге, ваш гигабайт будет нарезан на 500 мелких кусочков.

Далее мы закрываем половину этих программ, чтобы освободить место для одной тяжёлой программы. И вот проблема: мы освободили 250 кусочков по 2мб, но они разбросаны рандомно по всему пространству! И у нас нет ни одного свободного промежутка хотя бы в 100мб:

[== Физическая память 1 ГБ ==]

1. Память забита (по 2 МБ):
|█|█|█|█|█|█|█|█|█|█|█|█|█|█|█|

2. Закрыли половину (ДЫРЫ):
|█| |█| | |█|█| |█| |█| | |█|█|
^ ^ ^ ^ ^ ^ ^
2мб 2мб 4мб 2мб 2мб 4мб 2мб

(Суммарно места много, но оно
разбито на мелкие куски)

3. Нужен цельный кусок 100 МБ:
Требуется: |██████████|
Результат: ОШИБКА! Не влезает...


Попытка 3: Страничная организация (Paging)

Очевидно, нам нужно уметь из мелких кусочков собирать большие. Давайте будем нарезать память на одинаковые мелкие кусочки — страницы (обычно по 4 КБ), а затем маппить запрошенные программой адреса с реальными через специальную таблицу (Page Table).

То есть, ОС будет вести полный учёт — кому какая страница принадлежит и правильно сопоставлять адреса с помощью таблицы

Программа же не догадывается об этой машинерии — она всё так же работает в своём виртуальном диапазоне, [0x0000,0x2000]. Например:

1. Программа пишет по адресу 0x1050

2. ОС смотрит в таблицу и сопоставляет: виртуальный адрес 0x1050 с физическим 0x8A3050

Что это нам даёт?

Безопасность: у каждой программы своя таблица страниц — свой изолированный мир. До чужой памяти физически не дотянуться, а попытка вылезти за пределы своего пространства — ошибка. Привет, Segmentation fault! 👍

Дефрагментация: виртуальные страницы программы могут идти строго по порядку, одна за другой. А вот в физической памяти ОС может раскидать их как угодно по любым свободным промежуткам.

Готово?! Да, концептуально оно работает, но есть нюанс.. 👀

На практике мы замечаем, что наша ОС жутко тормозит — топорный программный поиск по таблице, это слишком тяжёлая операция. В следующем посте будем это оптимизирвать.

#guide #memory
  • 🔥 113
  • 👍 36
Post #896 12.8K
Как там дела с новыми роликами?

Как я уже писал, после увольнения я решил отдохнуть месяцок, заставляя себя вообще ничего полезного не делать. После этого я жестко подсел на вайбкодинг Agentic Engineering. Ох и страшная штука.. Затягивает сильнее, чем Дота. Если интересно, как-нибудь позже расскажу про свои проекты (у меня там много всего, от простеньких игр, до собственной IDE).

Когда меня немного отпустило, я снова взялся за сценарий ролика про GC. Но в какой-то момент я понял, что некоторые "ликбезы" настолько серьёзные, что их проще вынести в отдельные ролики, которые не будут уступать по объёму.

Раз уж у меня теперь много времени на создание контента, я решил что начну с фундамента, после которого материал про GC будет восприниматься сильно легче — Memory Model, Memory Layout, аллокатор и др.

В общем, планов много, работа кипит. Работаю я теперь даже больше, чем раньше — потому что интересно.

Когда ждать? Не скоро. Для меня, как и прежде, качество важнее количества. Буду прорабатывать сценарий до тех пор, пока он меня полностью не устроит. Кроме того, есть и другие важные проекты.

Надеюсь, что за 1-2 месяца справлюсь с ближайшим видео 😩

Но пока я им занимаюсь, буду по традиции писать сюда короткие гайды, которые подготовят вас к просмотру 🫶
  • 🔥 146
  • 👍 28
Post #894 15.2K

Forwarded from Николай Тузов - Live

☣️ Озон попросил меня отправить тухлятину через 2 страны СДЭКом (но СДЭК отказался)

Не могу не поделиться этой историей. Если вы думаете, что в вашей компании процессы выстроены абсурдно, то прочитайте сначала этот пост 💅

Недавно я писал про то, как я получил от Озона вместо мыши за 10 тыс рублей пустую коробку, а в ПВЗ у меня отказались принимать возврат. Окей, деньги в итоге вернули — с натяжкой можно предположить, что просто процессы дали сбой, бывает.

Но сегодня мы столкнулись с ситуацией, где процессы сломаны by design. Вернее, они не просто сломаны, они до безумия абсурдны. Я не понимаю, кто в здравом уме вообще мог такое придумать.

————

Ситуация: заказали упаковку энергетиков (маталлические банки). Тащить такое из ПВН проблематично, поэтому привёз курьер. Вскрываем, банки повреждены, внутри всё залито жидкостью и... уже поросло плесенью! Вонища, как вы понимаете, жуткая 💩

Как вы думаете, как в этой ситуации поступит Озон?

Извинится, вернёт деньги и попросит утилизировать это биологическое оружие? Нет 🗿

Пришлют курьера, чтобы он увёз биологическое оружие сам? Нет 🗿

У ребят фантазия работает куда лучше! Они попросят тебя оформить возврат самому через внешнюю службу доставки (например, СДЭК). Уже сложно, да?

Но вы недооцениваете их фантазию, ведь можно ещё сложнее! Возврат нужно за свой счёт оформить на конкретный адрес в Москве! Приложив к нему подробную инструкцию для курьера, как попасть на этот сложный охраняемый объект (он должен куда-то заранее позвонить, получить пропуск, прийти в определённое время)... На самом деле, это далеко не вся инструкция — сапорт прислал нам полотно, размером с этот пост.

Как думаете, СДЭК с этим справится? Нет, конечно, они послали нас ещё на этапе оформления доставки — они отказываются перевозить эту гадость! Мы им позвонили, и нам чётко ответили, что в таком виде посылку они точно не примут (и правильно делают).

К тому же, сама отправка может стоить дороже, чем заказанный товар — груз тяжёлый и большой 🤡

Итого, что мы имеем. Озон прислал испорченный продукт с плесенью и поставил условия, которые заведомо невозможно выполнить. А даже если бы и было возможно — вы можете себе представить как заплесневелая протухшая коробка едет из Астаны в Москву? Попутно заражая всё, что едет рядом с ней. А сколько оно там будет храниться на складах? А главное — зачем?

Последний рабочий вариант — отнести это добро на ПВЗ. Мне не очень хочется тащить тяжелую коробку так далеко, и я даже не уверен что там её примут. Но просто из принципа доведу дело до конца.

————

Какая из всего этого мораль? Конечно, как инженер, я понимаю, что сделать универсальный флоу возврватов, который учтёт все нюансы, крайне сложно, а скорее невозможно. Но дело то не в этом — ребята просто заигрались в оптимизацию.

🟢Практически все подобные проблемы, даже самые нестандартные, решаются наличием адекватного сапорта. А у Озона сапорт практически отсутствует, как и у Яндекса.

Но вообще, ситуация закономерная 💩 (это не шутка), чуть позже хочу написать общий пост о подобной тенденции в целом.

————

Что ж, пополняем список правил при работе с Озоном:

1. Внимательно проверяйте под камерой что вам привезли — вскрывайте коробку, убедитесь что там не пусто и именно ваш товар. Пустую коробку назад не примут.

2. Убедитесь, что товар не подделка и не сломан. Если подделка — вам скажут, что это вы сами её подменили (у меня такое тоже бывало, с трудом добился возврата)

3. Если заказали продукты, проверяйте срок годности, целостность упаковки и.. наличие плесени! 🦠

А лучше, не заказывайте вовсе, если есть альтернатива. Это уже далеко не тот сервис, которым мы привыкли пользоваться.

Озон, у вас там всё в порядке?

#негатив #ozon
  • 👍 27
Post #893 12.8K

Forwarded from Tuzov AI Lab

🤖 LLM под капотом: трансформер. Часть 1

Серия #llm_internals

В недавнем посте мы разобрались, что такое токены и веса, а затем закрепили в голове понятие вектора в N-мерном пространстве. Теперь давайте заглянем внутрь самой модели — как она устроена и что вообще эти миллиарды весов делают. Ключевое слово тут — трансформер!

Что такое трансформер?

Это конкретный тип нейросети, придуманный в 2017 году в Google (статья Attention Is All You Need). Это самая базовая база, которую стоит знать каждому, с этого всё началось. И с тех пор ВСЕ LLM, которые вы знаете — Claude, GPT, Gemini, Llama, DeepSeek, Qwen — это трансформеры.

Суть архитектуры хорошо передаётся названием — внутри модель буквально этим и занимается: берёт ваш промт (последовательность токенов) и постепенно его преобразует (трансформирует), чтобы финальному набору можно было предсказать следующий токен.

Делается это в три шага:

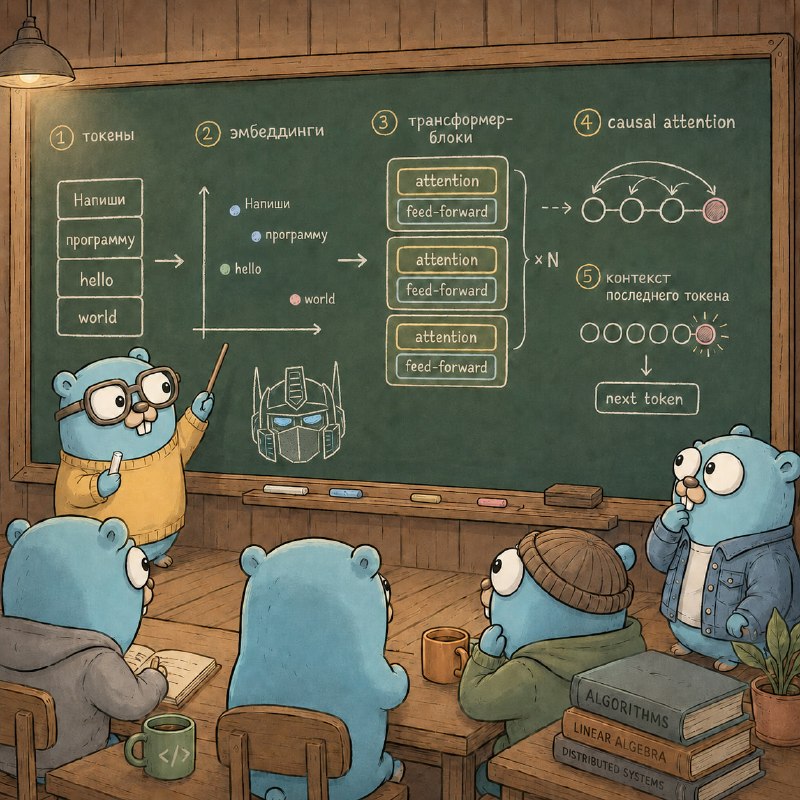
Шаг 1. Промт превращается в набор векторов (эмбеддинги)

Итак, на этапе обучения модели каждому токену из её словаря сопоставляется какой-то набор параметров (8-12 тыс, зависит от модели) или, другими словами, вектор в пространстве этих параметров. Все эти вектора хранятся в одной большой таблице — её и называют таблицей эмбеддингов.

🟢Чтобы уложить в голове, представьте что у вас есть обычное 3-мерное пространство, и вам надо каким-то хитрым образом распределить по нему набор из 10 точек. Вот для модели делают то же самое, но пространство многомерное, а точек десятки и сотни тысяч. Но принцип от этого не меняется.

🦄Главная магия этой таблицы: модель училась располагать токены таким образом, чтобы близкие по смыслу оказывались рядом. То есть, «разработчик» и «программист» — рядом, а «разработчик» и «ананас» — далеко. На этой простой идее держатся все нейросети для текста.

Итак, модель готова. Теперь, когда вы отправляете свой промт, он сначала разбирается на токены, а затем каждому токену сопоставляется вектор из таблицы. К примеру, если ваш промт состоял из 10 токенов, модель будет дальше обрабатывать набор из 10 векторов.

А ещё к каждому вектору добавляется метка позиции, чтобы их порядок соответствовал порядку слов в промте.

Шаг 2. Эти вектора прогоняются через стопку «блоков».

Блок (или слой) — это просто функция, которая каким-то хитрым образом преобразовывает (трансформирует) набор наших векторов. То есть, передвигает набор точек в пространстве. У крупных моделей их 80-120 штук.

Внутри одного блока — две операции:

- attention — каждый вектор обновляется с учётом всех предыдущих векторов из последовательности (про эту операцию подробно в следующем посте, она для нас критически важна)

- feed-forward — ещё раз обрабатывает каждый вектор уже по отдельности

Важный нюанс: внутри attention каждый вектор смотрит только на предыдущие, не на последующие. Поэтому первый токен видит только себя, второй — себя и первого, а последний всех. Это техническое свойство трансформеров-декодеров (а именно ими являются все LLM, о которых мы тут говорим).

Допустим, ваш промт был такой: "Напиши программу hello world". До преобразований вектор слова «world» — это просто копия из таблицы. А после всех преобразований числа в нём поменялись таким образом, что они зависят и от «Напиши», и от «программу», и от «hello».

(да, на самом деле, как я уже писал, модель работает не со словами, а с токенами, но такая формулировка понятней интуитивно)

То есть, точка в нашем многомерном пространстве сдвинулась в новое положение, которое учитывает предыдущие токены. Можно сказать, что этот финальный токен «получил информацию» о всех предыдущих — теперь это слово в конкретном контексте.

Именно по нему модель и считает, какой токен предсказать следующим.

Шаг 3. Генерация следующего токена

Вот мы и добрались до самого интересного! У нас наконец на руках есть абсолютно всё, чтобы сгенерировать свой первый токен, а затем и весь ответ модели целиком.

// TODO: Написать об этом следующий пост


#llm_internals
  • 🔥 62
Older posts →

About this channel

How can I read @ntuzov without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Николай Тузов: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Николай Тузов have?
Николай Тузов (@ntuzov) has 16.9K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Николай Тузов know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →