
Серия #llm_internals
В недавнем посте мы разобрались, что такое токены и веса, а затем закрепили в голове понятие вектора в N-мерном пространстве. Теперь давайте заглянем внутрь самой модели — как она устроена и что вообще эти миллиарды весов делают. Ключевое слово тут — трансформер!
Что такое трансформер?
Это конкретный тип нейросети, придуманный в 2017 году в Google (статья Attention Is All You Need). Это самая базовая база, которую стоит знать каждому, с этого всё началось. И с тех пор ВСЕ LLM, которые вы знаете — Claude, GPT, Gemini, Llama, DeepSeek, Qwen — это трансформеры.
Суть архитектуры хорошо передаётся названием — внутри модель буквально этим и занимается: берёт ваш промт (последовательность токенов) и постепенно его преобразует (трансформирует), чтобы финальному набору можно было предсказать следующий токен.
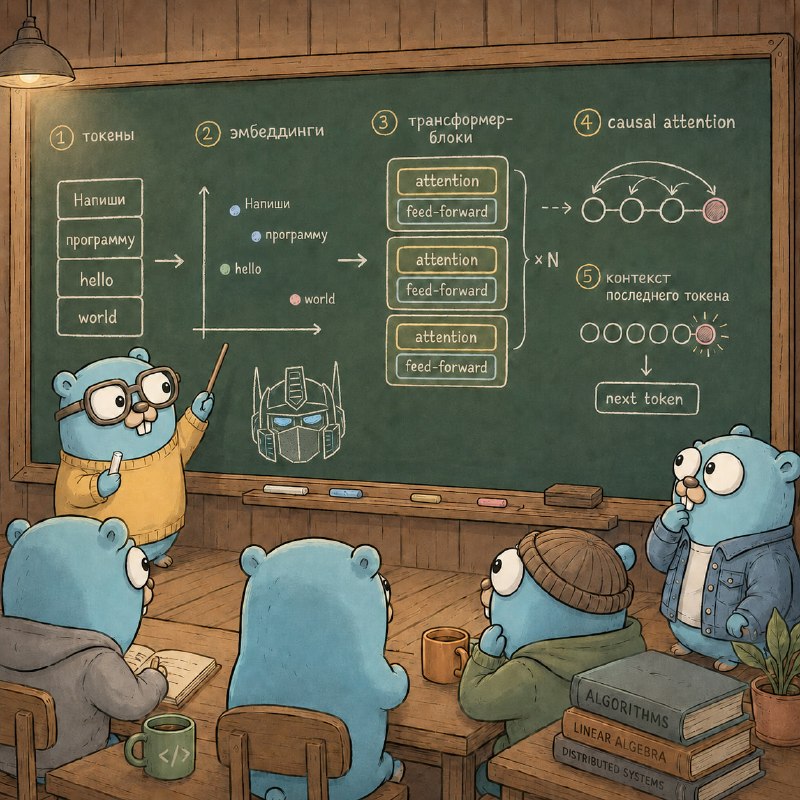
Делается это в три шага:
Шаг 1. Промт превращается в набор векторов (эмбеддинги)
Итак, на этапе обучения модели каждому токену из её словаря сопоставляется какой-то набор параметров (8-12 тыс, зависит от модели) или, другими словами, вектор в пространстве этих параметров. Все эти вектора хранятся в одной большой таблице — её и называют таблицей эмбеддингов.
🟢Чтобы уложить в голове, представьте что у вас есть обычное 3-мерное пространство, и вам надо каким-то хитрым образом распределить по нему набор из 10 точек. Вот для модели делают то же самое, но пространство многомерное, а точек десятки и сотни тысяч. Но принцип от этого не меняется.
🦄Главная магия этой таблицы: модель училась располагать токены таким образом, чтобы близкие по смыслу оказывались рядом. То есть, «разработчик» и «программист» — рядом, а «разработчик» и «ананас» — далеко. На этой простой идее держатся все нейросети для текста.
Итак, модель готова. Теперь, когда вы отправляете свой промт, он сначала разбирается на токены, а затем каждому токену сопоставляется вектор из таблицы. К примеру, если ваш промт состоял из 10 токенов, модель будет дальше обрабатывать набор из 10 векторов.
А ещё к каждому вектору добавляется метка позиции, чтобы их порядок соответствовал порядку слов в промте.
Шаг 2. Эти вектора прогоняются через стопку «блоков».
Блок (или слой) — это просто функция, которая каким-то хитрым образом преобразовывает (трансформирует) набор наших векторов. То есть, передвигает набор точек в пространстве. У крупных моделей их 80-120 штук.
Внутри одного блока — две операции:
- attention — каждый вектор обновляется с учётом всех предыдущих векторов из последовательности (про эту операцию подробно в следующем посте, она для нас критически важна)
- feed-forward — ещё раз обрабатывает каждый вектор уже по отдельности
Важный нюанс: внутри attention каждый вектор смотрит только на предыдущие, не на последующие. Поэтому первый токен видит только себя, второй — себя и первого, а последний всех. Это техническое свойство трансформеров-декодеров (а именно ими являются все LLM, о которых мы тут говорим).
Допустим, ваш промт был такой: "Напиши программу hello world". До преобразований вектор слова «world» — это просто копия из таблицы. А после всех преобразований числа в нём поменялись таким образом, что они зависят и от «Напиши», и от «программу», и от «hello».
(да, на самом деле, как я уже писал, модель работает не со словами, а с токенами, но такая формулировка понятней интуитивно)
То есть, точка в нашем многомерном пространстве сдвинулась в новое положение, которое учитывает предыдущие токены. Можно сказать, что этот финальный токен «получил информацию» о всех предыдущих — теперь это слово в конкретном контексте.
Именно по нему модель и считает, какой токен предсказать следующим.
Шаг 3. Генерация следующего токена
Вот мы и добрались до самого интересного! У нас наконец на руках есть абсолютно всё, чтобы сгенерировать свой первый токен, а затем и весь ответ модели целиком.
// TODO: Написать об этом следующий пост
#llm_internals