TGViewer
Channel Public Channel
NLP stuff

NLP stuff

@nlp_stuff

مطالب خوب و به‌دردبخور در حوزه‌ی هوش مصنوعی و پردازش زبان طبیعی!

شکرشکن شوند همه طوطیان هند
زین قند پارسی که به بنگاله می‌رود

اگر انتقاد، پیشنهاد و یا مطلب مفیدی (لینک، پست و ...) داشتید:
@AliAkbarBadri
@mmsamiei
@MmahdiAghajani
Subscribers
3.86K
Photos
147
Videos
1
Links
278

Showing posts older than #75 · Back to latest

Older Posts 20 shown
Post #73 1.12K
آینده هوش احتمالا وابسته به فیلد RL هستش. در راستای این جمله پژوهش جدید openAI رو مشاهده کنید. این تیم که کلا رو RL زیاد فوکوس کرده‌اند، این بار به سراغ نشون دادن تاثیر RL بر مدل‌های زبانی رفته‌اند. تیم OpenAI گفته‌اند که مدل‌های زبانی فعلی با هدف تشخیص کلمه بعدی آموزش می‌بینند که می‌تونه راه کامل و جامعی برای آموزش مدل نباشه.
سپس اومدن با یادگیری بانظارت مدلی رو روی فیدبک‌های انسانی آموزش دادن که بتونه تشخیص بده کدوم خلاصه‌سازی از یک متن بیشتر به مذاق آدمیزاد خوش میاد. بعدش اومدن با کمک این مدل و البته RL، مدل زبانی رو روی تسک خلاصه سازی متن Fine tune کردن. در نهایت هم نشون دادن که این مدل خلاصه سازی متن حاصل شده، کیفیتش از مدلی خلاصه سازی ده برابر بزرگتر از اون بهتره.
اگر به RL و مدل‌های زبانی علاقه مندین و البته مشکل خاصی با ایلان ماسک ندارین، توصیه می‌کنیم که این مقاله رو بخونین که مال همین ۴ سپتامبره و از نون‌های تو سفره‌تون داغ تره!

https://openai.com/blog/learning-to-summarize-with-human-feedback/

#read
#paper

@nlp_stuff
Post #71 1.11K
آقا آمیت مثل همیشه شرمنده‌مون کرده و یک پست جدید درباره Data Augmentation (تولید و تقویت دیتا) برامون نوشته اما این بار از MarianMT (از کتابخونه transformers) به جای گوگل ترنسلیت برای تکنیک back translation استفاده کرده.
کدش هم گذاشته که روی گوگل کولب ران کنیم کیف کنیم.
بحث data augmentation بحث خیلی مهم، به‌روز و خیلی به درد بخوریه. از دست ندید.

اگر کلا نمی‌دونید داستان چیه، قبلش این پست (https://t.me/nlp_stuff/5) را ببینید.


https://amitness.com/back-translation/

#read
#blog

@nlp_stuff
Post #70 2.32K
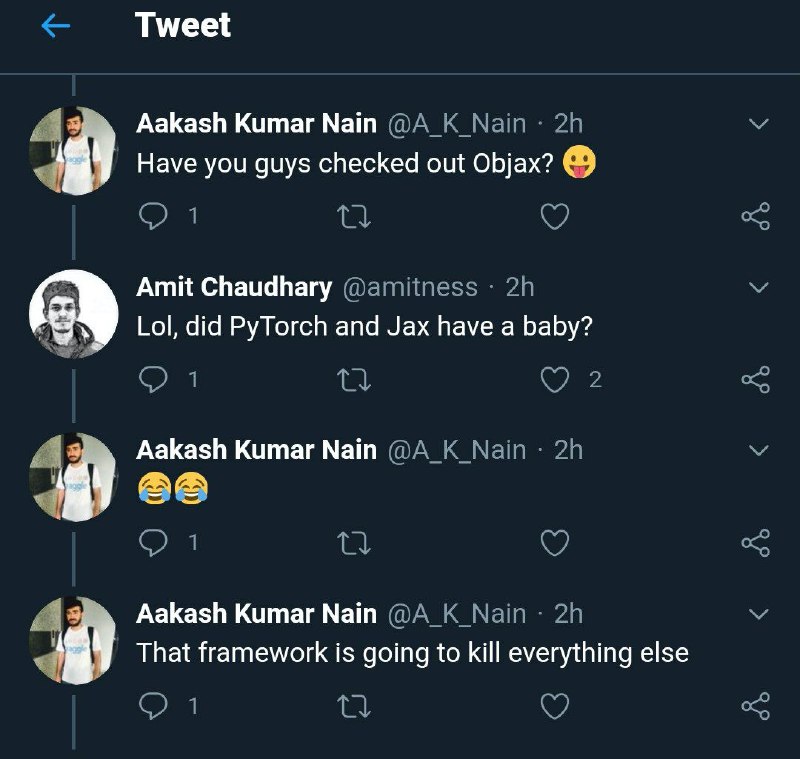
به نظر میاد فریمورک‌هایی که قراره به زودی همه چیزو رنده کنند، امثال Objax (از گوگل)، HAIKU (از دیپ مایند گوگل) و flax (بازم از گوگل) هستند که روی Jax (طبیعتا بازم از گوگل) درست شدند.
کتابخونه jax مستقیما از داده ساختار numpy استفاده می‌کنه (به تنسور تبدیل نمیشه) و روی gpu ران می‌شه و چون از کامپایلر xla استفاده میکنه با tpu سازگاری کامل داره. استفاده از numpy برای کد زدن قطعا خیلی راحت‌تره و خیلیا هم بلدن.
اولویت این کتابخونه‌ها سادگی و قابلیت شخصی‌سازی راحتشونه.

این دوتا توییت از آقای گودفلوی کبیر و آقای برثلوت (سازنده‌ی objax) را ببینید.
https://twitter.com/goodfellow_ian/status/1299753335524700160?s=09

https://twitter.com/D_Berthelot_ML/status/1299275145886875650?s=20


اینم گیت کتابخونه objax:
https://github.com/google/objax


اینم یه مقایسه اولیه بین سرعت پایتورچ و jax:
https://www.kaggle.com/grez911/performance-of-jax-vs-pytorch

اینا فقط سر نخه که بگیریم و بریم دنبال داستان.

با تشکر از دانیال علی‌حسینی، حامد شادباش و مهدی رضایی.

#twitter
#link

@nlp_stuff
Post #68 1.17K
این دو ویدئوی جمع و جور از دوست هندیمون (یکی از خفنای کگل) را ببینید.
اولیش برای آموزش یک مدل ساده‌ی تشخیص قطبیت با تورچ و برت از هاگینگ‌فیس و بعدش سرو کردنش با فلسکه.
دومیش هم داکر برای دیتا سانتیست‌هاست که داکرایز کردن همون پروژه‌ی ویدیوی اوله.


https://www.youtube.com/watch?v=hinZO--TEk4

https://www.youtube.com/watch?v=0qG_0CPQhpg

https://github.com/abhishekkrthakur/bert-sentiment

#coach
#course

@nlp_stuff
YouTube Training Sentiment Model Using BERT and Serving it with Flask API In this video, I will show you how you can train your own #sentiment model using #BERT as base model and then serve the model using #flask rest api. The video focuses on creation of data loaders, creating a bert model using transformers python library, training…
Post #67 967
آقا توماس از تیم هاگینگ‌فیس می‌خواد برامون نمونه کدهایی ساده و تمیز از استفاده از ترنسفورمرها با همه‌ی مراحل مهم (پیش‌پردازش، آموزش، ارزیابی و تنظیم هایپرپارامتر) درست کنه. این اولیشه.
در توییتر دنبالش کنید. چیزای زیادی ازش یاد می‌گیرید.

https://twitter.com/Thom_Wolf/status/1296633793558786048

#twitter

@nlp_stuff
Post #66 1.23K
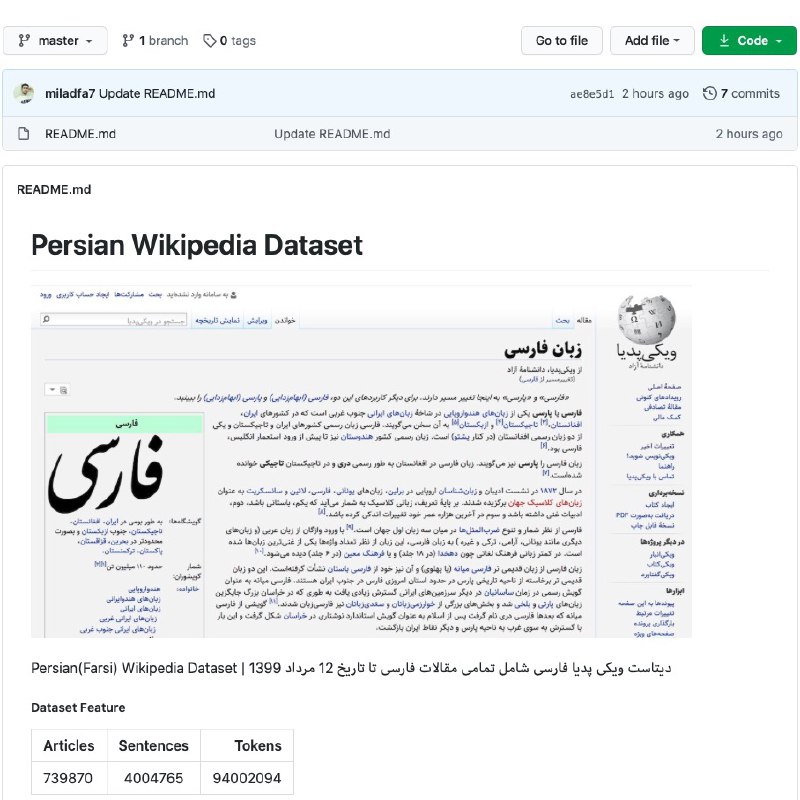
دیتاست ویکی‌پدیا فارسی شامل تمامی مقالات فارسی تا تاریخ ۱۲ مرداد ۱۳۹۹.
مخصوصا برای آموزش مدل زبانی خیلی به درد می‌خوره.

استار بدید لذتشو ببره.


https://github.com/miladfa7/Persian-Wikipedia-Dataset


#link
#irani
#dataset

@nlp_stuff
Post #64 912
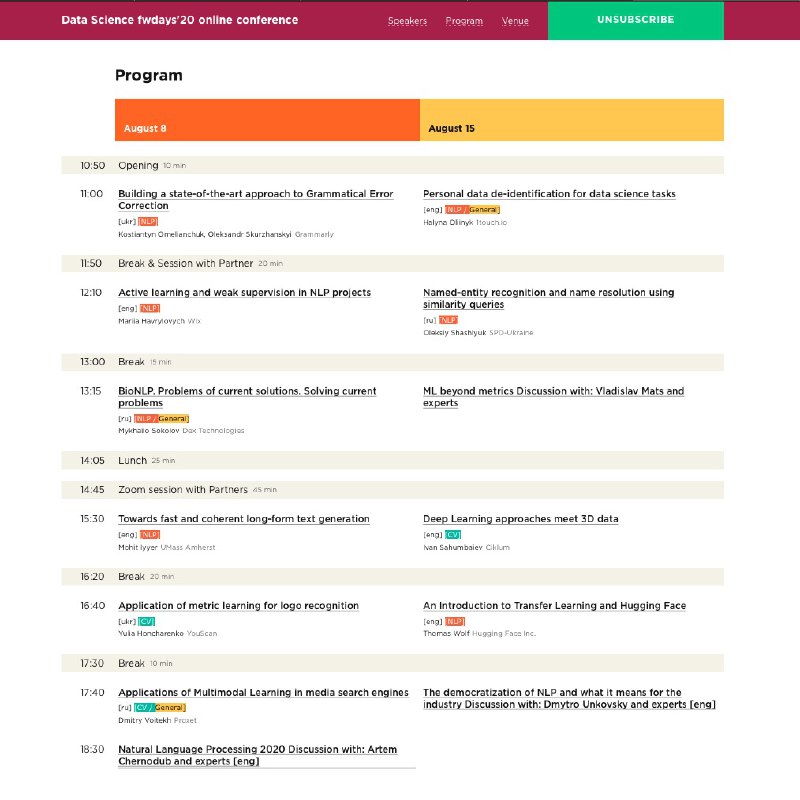
کنفرانس آنلاین Data Science fwdays'20 در روزهای ۸ و ۱۵ آگوست به صورت رایگان برگزار شده و میشه.
فردا حدود ساعت ۱۹ هم سخنرانی توماس ولف از تیم هاگینگ فیس با موضوع جذاب An Introduction to Transfer Learning and Hugging Face خواهد بود.


لینک لایو یوتیوب کنفرانس (ساعت ۱۲:۲۰ شروع میشه):
https://www.youtube.com/watch?v=TCutgkMyjdY

ویدیو دیگه‌ای از ایشون با همین موضوع در NLP Zurich:
https://www.youtube.com/watch?v=rEGB7-FlPRs

ویدیو پارسالش در همین کنفرانس Data Science fwdays با موضوع Transfer learning in NLP:
https://youtu.be/0T_Qr4qBrqc?list=PLPcgQFk9n9y8CCapH9u99Va7Ufs5bVZZn&t=24


خلاصه با این همه منابع در این موضوع برید کیف کنید.

#coach
#course

@nlp_stuff
Post #63 847
درسته که ما فعلا نمی‌تونیم لقمه‌های بزرگ مثل آموزش دادن GPT3 و GPT2 و اینها رو برداریم؛ ولی می‌تونیم که کوچیک کوچیک سهم خودمون رو در دنیای nlp بیشتر کنیم! این پروژه نمونه یکی از همون پروژه‌های جمع و جور هستش که سعی داره یک پیشرفت رو به نمایش بگذاره. ازش استفاده کنین تا سریعتر از nltk بتونین bleu رو حساب کنید!
به طور فنی‌تر اگر مجموعه مرجعتون خیلی بزرگه و می‌خواید معیار bleu یا self-bleu رو برای مدل‌های مختلف حساب کنید به احتمال زیاد به کارتون میاد (در واقع مجموعه مرجع ثابت و چندین مجموعه hypotheses دارید. بیشتر در ارزیابی مدل‌های زبانی چنین شرایطی پیش میاد)

تا جایی که می‌شده تست شده؛ خوشحال می‌شیم اگه مشکلی داشت issue بزنید. روی لینوکسم هست و برای ویندوز تست نشده!

در ضمن شما هم اگر کدی زدید که فکر می‌کنید می‌تونه خفن باشه به ما بگین تا تبلیغش کنیم.

https://github.com/Danial-Alh/fast-bleu

#irani
#tool
#code

@nlp_stuff
GitHub GitHub - Danial-Alh/fast-bleu: A fast multithreaded C++ implementation of NLTK BLEU with Python wrapper. A fast multithreaded C++ implementation of NLTK BLEU with Python wrapper. - Danial-Alh/fast-bleu
Post #62 772
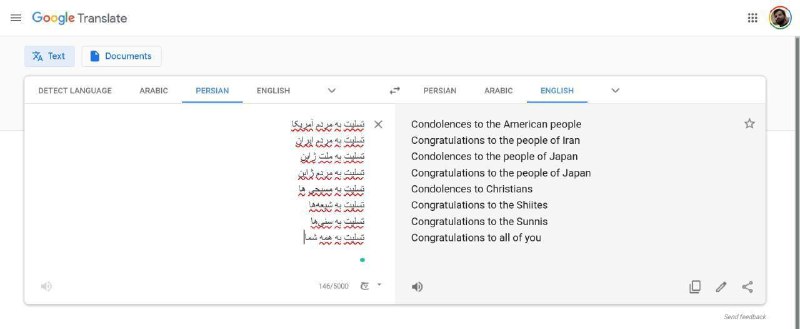
فکر نکنین که با ظهور دیپ و اومدن هر روزه شبکه‌های سنگین‌تر مسائل در حال حل شدن هستند و ما داریم به هوش واقعی می‌رسیم!
نخیر! همونطور که مشاهده می‌کنید گوگل با اون عظمتش گاهی لنگ می‌زنه!

@nlp_stuff
Post #61 2.78K
ما داریم سعی می‌کنیم یک لیست درجه یک از مقاله‌های عالی NLP را (که باید خونده بشن) به تفکیک حوزه‌ها در ریپو زیر درست کنیم و به روز نگه داریمش. 

 اگر مقاله‌ای عالی می‌شناسید که در این لیست نیست، یا پول ریکوئست بدید یا اطلاع بدید که ما اضافه‌اش کنیم.
و اینکه در قسمت Thanks to لیست هم اضافه‌تون می‌کنیم که دور هم باشیم!

امیدواریم انشاءالله با هم یک منبع ماندگار و به‌روز درست کنیم.


پی‌نوشت ۱. لطفا دست به دست کنید!
پی‌نوشت ۲. استار فراموش نشه. ما خیلی استار دوست داریم! :))

https://github.com/aabadri/nlp-papers


#read
#paper
#link
#irani

@nlp_stuff
Post #60 824
دو تا از روش‌هایی که برای کوچک‌کردن مدل‌ها استفاده میشن pruning و distillation هستند.
این پست یه خلاصه‌ی خوب از مقاله‌ی Poor Man's BERT: Smaller and Faster Transformer Models برای روش‌های هرس کردن و مزیت‌هاش نوشته.

https://medium.com/dair-ai/poor-mans-bert-why-pruning-is-better-than-knowledge-distillation-%EF%B8%8F-f9652a1dc2bd

لینک مقاله‌ی اصلی:
https://arxiv.org/abs/2004.03844

#read
#blog

@nlp_stuff
Post #59 824
برادر آمیت لطف کرده و یه خلاصه برای مقاله‌ی برنده‌ی ACL2020 نوشته. اگر خود مقاله را هم نخوندید، این را بخونید خوبه!

https://amitness.com/2020/07/checklist/

(اگر نمی‌دونید کلا داستان چیه، این پست را اول ببینید: https://t.me/nlp_stuff/48)

#read
#blog

@nlp_stuff
Post #57 921
این پست اومده بخش‌های مختلف مقاله‌ی اسطوره‌ای «attention is all you need» را به صورت تیکه تیکه آورده و با پایتورچ پیاده‌سازی کرده.
خیلی تمیز و خوبه.

http://nlp.seas.harvard.edu/2018/04/03/attention.html

#read
#blog

@nlp_stuff
Post #56 1.19K
حوصله‌تون سررفته؟ می‌تونید برید و با بلبل‌زبان که حاصل آموزش دادن مدل GPT2 روی متون زبان فارسی است بازی کنید و سرگرم بشید.

www.bolbolzaban.com

#link

@nlp_stuff
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →