TGViewer
Channel Public Channel
Мониторим ИТ

Мониторим ИТ

@monitorim_it

Канал о наблюдаемости (Observability): логи, трейсы, метрики.

Реклама: @gals_ad_bot
Вопросы: @antoniusfirst

@usr_bin_linux — Linux

@zabbix_ru — Zabbix

@elasticstack_ru — ElasticSearch/OpenSearch
Subscribers
8.54K
Photos
346
Videos
0
Links
1.7K
Recent Posts 17 shown
Post #2572 1.12K
🚨 Prometheus Alertmanager или Grafana Alerting — что выбрать?

Поговаривают, что существуют окружения, в которых алерты летят одновременно из Alertmanager и Grafana. При таком раскладе правила, маршрутизация и глушилки оказываются разбросаны по двум системам, а команда не всегда понимает, какая из них главная.

По ссылке вы найдете перевод статьи, в которой подробно сравниваются оба подхода: архитектура, группировка и дедупликация алертов, правила подавления, интеграции, высокая доступность и управление через UI или конфигурацию.

Также говорят про гибридный вариант: создавать и визуализировать правила в Grafana, а сложную маршрутизацию и доставку уведомлений оставлять Alertmanager.

👉 Читать перевод статьи

👉 Расскажите в комментариях какой подход выбрали у себя в окружении.

📱 Telegram | 📲 MAX
Teletype Prometheus Alertmanager против Grafana Alerting (2026): архитектура, возможности и когда использовать каждый из них Это перевод оригинальной статьи Prometheus Alertmanager vs Grafana Alerting (2026): Architecture, Features, and When to Use Each.
  • 👍 6
  • 🔥 3
  • ⚡ 2
Post #2571 1.19K
🎤 SIP Dump Analyzer: как мы разработали open source-анализатор SIP и RTCP дампов

Описание доклада
С ростом количества пользователей и звонков система на базе Homer перестала обеспечивать необходимую скорость работы. В докладе разберём новую архитектуру обработки SIP-трафика: децентрализованный захват, PCAP как единицу обработки, ClickHouse для хранения и аналитики, а также использование S3, Redis и курсорной пагинации.
На практическом примере покажем, как новая система помогает в несколько раз ускорить работу технической поддержки.

Тезисы
- Децентрализованный захват VoIP-трафика с sip_dumps.
- PCAP как единица пакетной обработки.
- ClickHouse для быстрого хранения и анализа больших объёмов данных.
- Курсорная пагинация без лишней нагрузки на API и СУБД.
- S3 и Redis-очередь для хранения, асинхронной обработки и горизонтального масштабирования.
- Практический эффект: ускорение поиска и анализа звонков для технической поддержки.


Смотреть программу конференции AsterConf
  • 👍 4
  • 🔥 3
  • ⚡ 2
Post #2570 1.28K
Дедупликация строк на доставщике логов: сравниваем OpenTelemetry, Vector, vlagent, Fluent Bit Grafana Alloy и Filebeat

Дописал вторую статью из той же серии. Идеи, которые копились достаточно давно, наконец начали выходить в свет.

Вы узнаете про варианты дедупликации на уровне агентов. В одной из следующих статей поговорим о том какой бэкэнд лучше жмет, а дальше как снизить объем телеметрии.

Плюсы к статье и в карму на Хабре неистово приветствуются❤️

Читать на Хабре

📱 Telegram | 📲 MAX
  • 👍 5
  • ❤ 2
  • ⚡ 2
  • 🔥 2
Post #2566 1.49K
Exemplars: как перейти от всплеска на графике сразу к проблемному запросу

(удобная штука, как оказалось, но полноценно работает только в Mimir и Prometheus)

По метрикам легко определить, что вырос p95 задержки запросов, увеличилась доля ошибок или просела пропускная способность. График, к сожалению, сообщит только факт произошедшей проблемы, но не детали по ней.

Дальше идешь и ковыряешь трейсы, ищешь нужный временной интервал и нужные трейсы. Exemplars сокращают эту цепочку до одного клика.

Что это такое

Exemplar — ссылка на конкретный трейс, сохранённая рядом с метрикой. Кроме значения и времени оно обычно содержит trace_id или span_id и быть может еще какие-то дополнительные атрибуты.

Например, в гистограмме мы увидели в бакете запросы с плохим статусом. Exemplar говорит: смотри, вот пример конкретного трейса, он занял 1,82 секунды, а его trace_id — 7f3a…91c2.

При этом trace_id не становится обычным лейблом метрики и не создаёт новую серию для каждого запроса.

Как внедрить

1. Настройка на уровне инструментирования приложения. Метрика и трейсы должны создаваться в одном контексте. OpenTelemetry может связать метрику с активным трейсом. В Prometheus клиенте можно извлекать идентификаторы трейса из контекста OpenTelemetry.

2. Настройка на уровне бэкенда. Подойдёт Tempo или Jaeger.

3. Включить exemplar storage на уровне Prometheus. В Prometheus для этого используется флаг --enable-feature=exemplar-storage. В Mimir свои настройки.

4. Связать источники данных в Grafana. В настройках Prometheus data source → Exemplars выбрать internal link на Tempo/Jaeger и указать имя метки: например, trace_id.

5. Найти наличие проблемных запросов на гистограмме (предварительно можно проверить, что exemplar появляется в Explore) и, перейти в существующий trace.

Exemplar, конечно, не способ найти все связанные трейсы. Это лишь пример, а не архив всех запросов. Если trace отброшен tail-сэмплером, ссылка окажется пустой.

По итогу exemplars сравнительно недорогой способ построить прямой путь от графика к конкретному медленному спану.

Для лучшего понимания подхода, посмотрите на приложенные к посту скриншоты.

👉 расскажите в комментариях, если у вас был опыт использования exemplars.

Полезные ссылки

🚀 Документация Grafana

🚀 Настройка Prometheus data source

🚀 Exemplar storage в Prometheus

🚀 Спецификация OpenTelemetry

🚀 Пример для client_golang

📱 Telegram | 📲 MAX
  • 🔥 6
  • ⚡ 2
  • 👍 2
Post #2565 1.33K
Микросервисная архитектура ускоряет разработку, но усложняет эксплуатацию. Один сбой в распределённой системе может вызвать лавину из сотен алертов, информационного шума и ложных следов. Инженерам приходится часами вручную сопоставлять логи, метрики и трейсы, чтобы понять, что именно стало первопричиной инцидента.

Покажем, как машинное обучение помогает превратить поток уведомлений в единую картину инцидента. Вы увидите, как алгоритмы помогают находить корневую причину, отсекать шум и оценивать возможное развитие аварии до того, как она повлияет на критичные бизнес-сервисы.

24 сентября в 11.00 команда Artimate и федерального системного интегратора «Аметист» проведут вебинар “От алерта до первопричины: как ML помогает расследовать каскадные инциденты“.

Для кого:

⚡️SRE- и DevOps-инженеры, которые хотят сократить время расследования инцидентов и снизить уровень информационного шума.
⚡️ Руководители ИТ-департаментов и технические лидеры, которым важны соблюдение SLA, прозрачность эксплуатационных процессов и снижение нагрузки на команду.
⚡️ Инженеры по мониторингу и наблюдаемости, которые выстраивают процессы эксплуатации сложных микросервисных систем.

Регистрируйтесь, чтобы узнать, как перейти от потока разрозненных алертов к управляемому расследованию инцидентов, быстрее находить их первопричины и повышать стабильность ИТ-сервисов.

Регистрация по ссылке

Реклама. ООО «Пруфтек ИТ». ИНН 5047175358, erid 2VtzqvcWTsJ
  • ❤ 3
  • 🔥 3
  • ⚡ 1
Post #2564 1.38K
Как создать собственный экспортер метрик для Kubernetes

Это статья о том, как написать свой Prometheus-экспортер на Go. В ней разобран весь путь: Counter, Gauge и Histogram, эндпоинты /metrics и /healthz, сборка безопасного образа, развёртывание в Kubernetes и подключение через ServiceMonitor. В конце небольшой бонус: подготовка метрики для использования в HorizontalPodAutoscaler.

Kubernetes из коробки умеет отслеживать загрузку CPU и потребление памяти. Но на практике решения о масштабировании чаще зависят от показателей, которые выходят за эти узкие рамки: сколько сообщений ждет в очереди, сколько времени заняла последняя пакетная задача, сколько активных WebSocket-соединений поддерживает под. Когда встроенных метрик недостаточно, этот пробел помогает восполнить экспортер метрик.


Читать на Хабре →

📱 Telegram | 📲 MAX
  • 🔥 7
  • ⚡ 2
  • 👍 2
Post #2563 1.58K
Ко вчерашней статье мне написали совершенно справедливый комментарий.

Комментарий касался механизмов, которые могут зарезать поток отправляемых данных на период когда бэкэнд только только очухался. Исправляюсь, статью дополнил.

Если кратко, то vmagent, vlagent, vtagent имеют параметр remoteWrite.rateLimit, который позволяет ограничить поток отправляемых данных.

В плане плавной заливки данных в бэкэнд после его падения наиболее функционален Vector. HTTP-ориентированные синки Vector имеют ограничение количества запросов за интервал: есть возможность реализации сценариев "не более 5 запросов в секунду" (rate_limit_num: 5), "не более 2 одновременных запросов" (concurrency: 2) и "до 1 MiB несжатых данных в одном полном batch" (max_bytes: 1048576).

Vector также поддерживает Adaptive Request Concurrency (ARC). ARC начинает с небольшой конкурентности и меняет её в зависимости от задержки бэкэнда.

Остальные агенты имеют лишь ограничения количества потоков.

Такие дела.

📱 Telegram | 📲 MAX
  • 👍 10
  • 🔥 7
  • ⚡ 3
  • ❤ 1
Post #2561 1.53K
What's new in ClickStack - Aug ’26

Пока кто-то с трудом выпускает одну версию за месяц, команда ClickStack выпустила аж сразу пять — с v2.34 по v2.38.

Среди главных обновлений:


🚀 переменные и связанные фильтры в дашбордах

🚀 формулы для расчёта процентов, коэффициентов и других производных метрик

🚀 навигатор по метрикам и метки релизов на графиках

🚀 экспериментальная поддержка TimeSeries и PromQL

🚀 отдельный дашборд для наблюдаемости LLM-приложений

🚀 история выполнения алертов, несколько каналов уведомлений и расширенные webhook-поля

🚀 новые инструменты MCP для расследования инцидентов с помощью AI-агентов.

Поддержка PromQL пока находится в private preview для облачного ClickStack и имеет экспериментальный статус в open-source-версии. Но направление понятно: команда ClickStack стремится объединить метрики, логи, трейсы и LLM-телеметрию в одной системе.

Подробности в статье в блоге ClickHouse.

📱 Telegram | 📲 MAX
  • 🔥 5
  • 👍 4
  • ⚡ 3
Post #2560 1.57K
Что будет с телеметрией, если хранилище исчезнет: сравниваем очереди и батчинг семи агентов

Написал статью для своих любимых подписчиков. Наслаждайтесь❤️

Читать на Хабре

📱 Telegram | 📲 MAX
  • 🔥 9
  • ❤ 4
  • ⚡ 1
  • 👍 1
Post #2557 1.71K
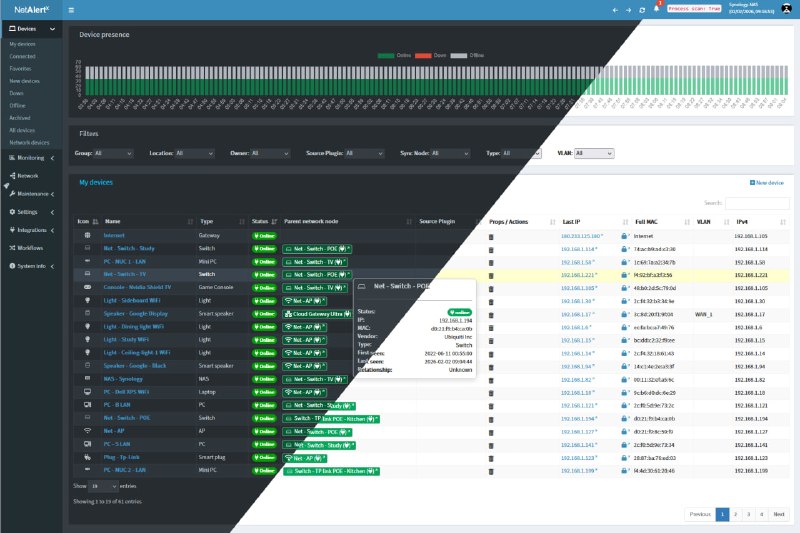
NetAlertX

Это опенсорсная система для автоматического обнаружения и учёта сетевых устройств. Она постоянно сканирует сеть, собирает список активов и сообщает, когда появляется новое устройство, меняется IP-адрес или кто-то внезапно пропадает.

Вместо периодического nmap и таблички, которую никто не обновлял с прошлого года, получите веб-интерфейс с историей изменений.

Что умеет:

🚀 обнаруживать устройства через ARP, DHCP, Pi-hole, UniFi, SNMP и плагины

🚀 находить неизвестное железо и теневые устройства

🚀 следить за статусом, IP-, MAC-адресами и производителями

🚀 отправлять уведомления в Telegram и ещё 80+ сервисов через Apprise

🚀 интегрироваться с Home Assistant, API и вебхуками

🚀 экспортировать метрики в Prometheus

🚀 собирать данные с нескольких VLAN, офисов и удалённых площадок в одном месте

🚀 автоматически группировать, архивировать и обрабатывать найденные устройства через workflows.

Разворачивается в Docker, а данные по умолчанию остаются локально. Подойдет для домашнего окружения: можно быстро вычислить очередную умную розетку, которая тихо получила новый адрес, или понять, откуда в Wi-Fi взялось незнакомое устройство.

Для небольшой инфраструктуры или филиальной сети система тоже выглядит вполне бодро. Конечно, не замена полноценному NMS или NetBox, но для непрерывного discovery и контроля изменений меньше возни.

Репыч на Гитхаб (в репо много скриншотов)

📱 Telegram | 📲 MAX
  • 🔥 7
  • 👍 6
  • ⚡ 2
  • ❤ 1
Post #2555 2.03K
logporter — легковесная альтернатива cAdvisor и сборщик логов для отправки в Loki

Занятная штуковина для мониторинга Docker для тех, кому хочется знать, кто жрёт память, кто отвалился и что перед этим написал в логах.

Автор logporter в статье на Хабре говорит, что ему надоел аппетит cAdvisor, и он запилил свой инструмент на Go.

Что внутри:

🚀 Метрики для Prometheus: CPU, память, сеть, дисковый ввод-вывод, состояние контейнеров и размеры томов. Всё, чтобы выяснить, куда испарились ресурсы.

🚀 Логи в Loki. Чтобы после алерта не бегать по серверам с дежурным «щас, я только docker logs гляну».

🚀 Проверка обновлений образов. Сравнивает версии в тегах, а для latest и прочих несемантических тегов — digest. Потому что надпись latest сама по себе свежести не гарантирует.

🚀 Встроенная веб-панель: контейнеры, образы, тома и просмотр логов в реальном времени. Есть поиск по словам, регуляркам и вывод контекста вокруг найденной строки.

Всё это упаковано в образ размером около 8 МБ. А для желающих сразу пощупать весь стек в репыче лежит Compose с Prometheus, Loki и Grafana — с настроенными источниками, дашбордами и правилами алертов (идеальный подход для домашней лабы).

Репыч на Гитхаб

📱 Telegram | 📲 MAX
  • 🔥 11
  • 👍 8
  • ❤ 3
  • ⚡ 2
Post #2553 1.83K
Сегодня у меня в канале вышел пост про открытую платформу для создания SRE-агентов, под которой появился вот такой комментарий. Это уровень, я считаю.

Машенька пришла похвалить пост, но принесла с собой техзадание.

Приятно, когда когда тебя хвалят от чистого промпта. Такая открытость в интернете сейчас редкость.
  • 🔥 26
  • 👍 6
  • ⚡ 3
Post #2552 1.76K
aura

Open-source платформа для создания SRE-агентов, рассчитанная на работу с реальной инфраструктурой. Она берёт на себя оркестрацию, хранение состояния, обработку ошибок, стриминг, аудит действий и защитные ограничения.

Что умеет:

— объединять специализированных агентов в команду;

— подключать инструменты через MCP

— работать с OpenAI, Anthropic, Gemini, Bedrock, Ollama и другими моделями

— запрашивать подтверждение человека перед опасными действиями

— экспортировать все решения и вызовы инструментов в OpenTelemetry

— работать внутри собственного контура, включая изолированные среды

Конфигурация агентов, промпты, модели, инструменты и политики доступа описываются в TOML, их можно хранить в Git и проводить через обычный code review.

Из коробки есть интеграции с Kubernetes, Prometheus, Grafana, Datadog, PagerDuty, GitHub, Jira, Slack и другими системами. Запускать AURA можно локально в Docker или Kubernetes.

В общем и целом, это AI-помощник для расследования инцидентов.

Репыч на Гитхаб

📱 Telegram | 📲 MAX
  • 🔥 12
  • 👍 2
  • ⚡ 1
Post #2551 1.76K
grpc-streams-checker

Инструмент синтетического мониторинга, который ведёт себя как настоящий клиент: открывает стрим, ждёт нужное количество сообщений, проверяет содержимое и измеряет задержки.

Умеет выявлять:

— таймауты и зависшие потоки;

— недостаточное количество сообщений;

— некорректные или пустые поля;

— растущую задержку первого сообщения;

— слишком большие интервалы между сообщениями.

Результаты экспортируются в Prometheus с разбивкой по методам и типам ошибок. В комплекте есть правила алертинга, Kubernetes-манифесты и демонстрационный сервер с разными сценариями поломок.

Статья с описание на Хабре

Репыч на Гитхаб

📱 Telegram | 📲 MAX
  • 🔥 8
  • 👍 6
  • ⚡ 3
Post #2550 1.95K
ИТ-мониторинг сети 24/7 - миф или реальность?

Штатные средства создают лишние хосты, неточно классифицируют оборудование и перегружают сервер при сканировании крупных сетей. Итог: значительная часть работы по проверке и настройке узлов остается ручной.

На вебинаре 22 сентября в 11:00 (МСК) команда wiSLA покажет, как выстроить полный цикл мониторинга сети — от автоматического обнаружения устройств до быстрой локализации сбоев и снизить количество ручного труда.

Коллеги разберут такие проблемы:
• как исключить «слепые зоны» в мониторинге сетевого оборудования;
• как контролировать доступность сетевого оборудования, используя проверки по SNMP, ICMP и HTTP;
• как собирать метрики, отслеживать события и анализировать состояние устройств в единой карточке;
• как быстро настроить мониторинг в едином контуре наблюдаемости;
• как снизить количество повторных сбоев с помощью ускорения диагностики инцидентов;
• как сократить время поиска инцидентов и восстановления ИТ-системы (MTTD/MTTR).

Вебинар поможет сократить количество неучтенных устройств и уменьшить объем ручной работы в сетевой инфраструктуре.

Дата: 22.09.2026 11:00 (МСК)
Формат: онлайн

Зарегистрироваться

Реклама. ООО «Пруфтек ИТ». ИНН 5047175358, erid 2VtzqvEN2CC
  • 🔥 5
  • 👍 1
Post #2549 1.9K
Приглашаю на тренинги по новой версии — Zabbix 8.0 (+ специальные условия до конца сентября)

Релиз восьмёрки ожидается в ближайшие недели. А обучение по новой версии уже можно запланировать: в ноябре и декабре у нас в Gals Software пройдут Zabbix Certified Specialist 8.0 и Zabbix Certified Professional 8.0.

Почему стоит присмотреться к восьмёрке? В официальном списке изменений есть интересные вещи:

Экспорт и импорт дашбордов. Настроенную панель можно будет сохранить в файл и перенести в другую установку Zabbix. Если собирали дашборды руками, пользу объяснять, думаю, не надо.

ClickHouse для хранения истории значений. Появляется ещё один вариант хранения собранных метрик — повод пересмотреть, как организована история в вашей системе мониторинга.

Отдельный тип данных JSON. В документации заявлена нативная поддержка JSON со значениями до 128 МБ. Это заметное изменение для тех, кто собирает большие ответы API.

Финальный релиз ещё впереди; сейчас эти изменения описаны в документации разрабатываемой версии 8.0.

Если давно собирались разобраться с Zabbix или отправить на обучение команду, можно сразу учиться на новой версии.

25–27 ноября 2026 — Zabbix Certified Specialist 8.0

Сбор метрик, agent и SNMP, шаблоны, триггеры, оповещения, веб-мониторинг и дашборды. Для тех, кто хочет уверенно настраивать мониторинг и привести знания в порядок.

Программа Specialist 8.0

16–18 декабря 2026 — Zabbix Certified Professional 8.0

Следующая ступень после Specialist 8.0: развертывание Zabbix, proxy, высокая доступность, автоматическое обнаружение ресурсов, мониторинг баз данных и VMware, корреляция событий. Для задач, где инфраструктура растёт и хочется больше автоматизации.

Программа Professional 8.0

Каждый тренинг — три дня онлайн, на русском языке, с практикой на лабораторных стендах.

После успешной сдачи экзамена — официальный сертификат по версии 8.0. Для экзамена Professional предварительно нужно сдать Specialist 8.0. А еще есть мерч (футболки и термокружки).

До 30 сентября включительно на оба тренинга действуют специальные условия участия.

За подробностями напишите @gals_software, в почту hello@gals.software или оставьте заявку на сайте.
  • 🔥 7
  • 👍 4
  • ⚡ 3
Post #2544 3.3K
The Life of a Metric

Когда в коде разраб пишет counter.Inc(), кажется, что метрика по этому счетчику просто каким-то волшебным образом появляется на графике в Grafana.

Однако, между этими событиями происходит дофига всего.

Сначала число живет в памяти приложения, потом передается по сети, получает идентификатор, попадает в хранилище, сжимается, записывается на диск, участвует в запросах, постепенно теряет детализацию — а в конце удаляется по ретеншену.

В статье в блоге VictoriaMetrics разобрали весь путь: от первого +1 в счетчике до последнего удаленного байта. Ну, и заодно становится понятно, почему миллион значений одной метрики — это норм, а миллион метрик с разными лейблами — уже совсем другая история (хай кардиналити).

Читать статью

📱 Telegram | 📲 MAX
  • 🔥 7
  • 👍 2
  • ⚡ 1
Older posts →

About this channel

How can I read @monitorim_it without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Мониторим ИТ: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Мониторим ИТ have?
Мониторим ИТ (@monitorim_it) has 8.54K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Мониторим ИТ know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →