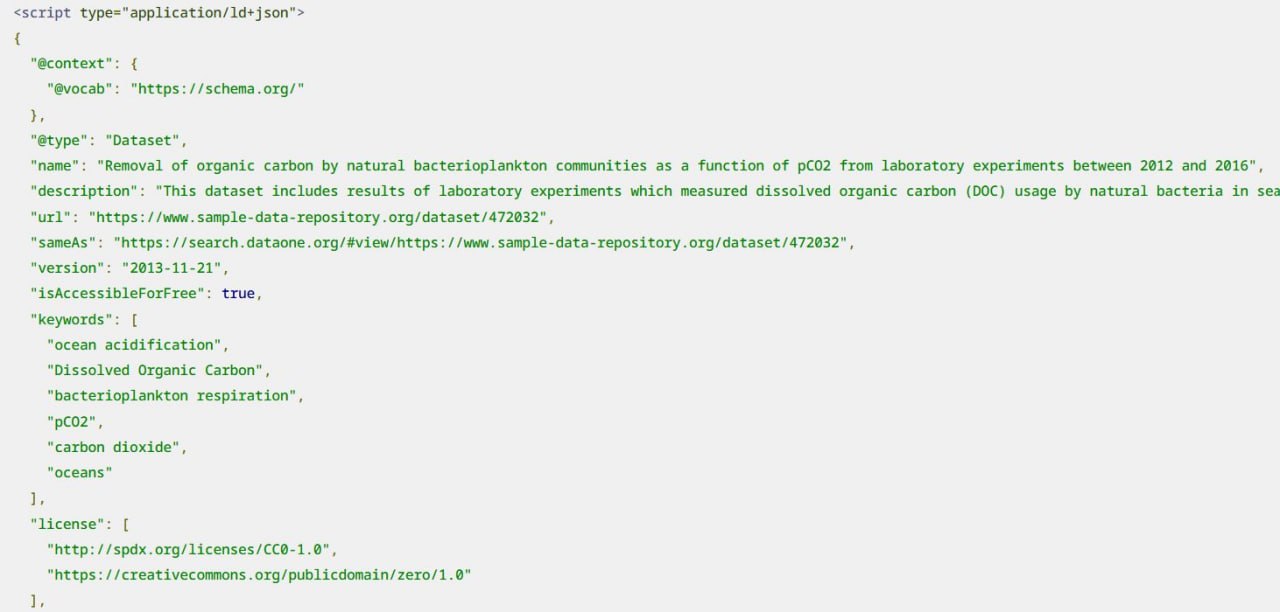
Исследование Google 2026 года измерило это ("Do Data Agents Need Semantic Metadata"?).
Когда твои цифры живут только внутри предложений, агент помечает страницу как "нарратив с данными": прозу, которая использует числа для рассказа истории, как большинство постов в блогах.
Чтобы переиспользовать одну цифру, ему затем приходится парсить твои абзацы.
Это вызывает раздувание токенов и ошибки извлечения, и агент часто не возвращает вообще ничего, лишь бы не рисковать выдать неверную догадку.
Решение занимает 10 минут: опубликуй те же числа в виде скачиваемого файла и опиши их микроразметкой
schema.org/Dataset.Что это дало в исследовании:
Точность подскочила с 28.0% до 46.4% (относительный прирост 65.7%).
Агент на 86.6% реже помечал страницу с данными как болтливую прозу вместо реального источника (на базе Gemini 2.5 Pro).
Две вещи, которые нужно выкатить вместе:
1. Микроразметка
schema.org/Dataset, чтобы модель могла отличить твою страницу от информационного шума.2. Прямая ссылка на скачивание (.csv, .json) через поле
distribution / contentUrl.Вот
JSON-LD, который нужно закинуть в тег <script type="application/ld+json">, а затем подставить свои значения:{
"@context": "https://schema.org/",
"@type": "Dataset",
"name": "Title of your study or survey",
"description": "A clear summary of what the data contains, so a model can judge relevance.",
"license": "https://creativecommons.org/licenses/by/4.0/",
"datePublished": "2026-08-13",
"keywords": ["keyword 1", "keyword 2"],
"distribution": [
{
"@type": "DataDownload",
"encodingFormat": "text/csv",
"contentUrl": "https://your-site.com/data/survey-results.csv"
}
]
}Если ты производишь оригинальные данные, это самые эффективные 10 минут во всем твоем
GEO-воркфлоу.Данные уже уникальны.
Просто сделай их пригодными для цитирования.
https://arxiv.org/pdf/2605.28787
#GEO #SchemaOrg #JSON_LD
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO