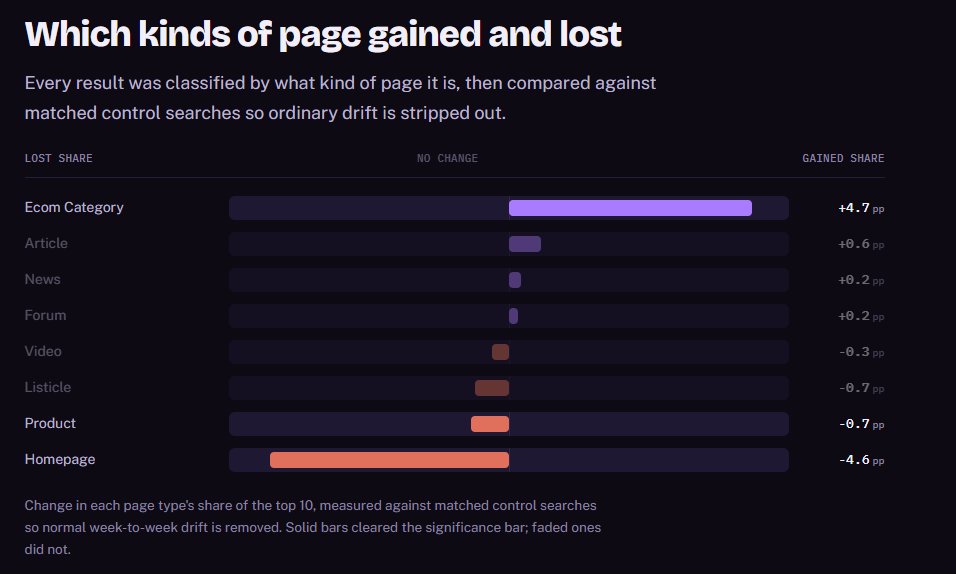
Запусти анализ апдейта без плацебо — и он найдет сигналы в спам-апдейте августа 2026 года.
Он с таким же успехом найдет их на неделе, когда Google вообще ничего не делал, и в результатах не будет ничего, что отличало бы эти два сценария.
Контрольная группа — это набор намеренно фейковых атрибутов, прогнанных через скоринг: они звучат правдоподобно, структурно идентичны реальным, но за ними нет никакого механизма.
Частота, с которой система "обнаруживает" их движение — это и есть порог шума.
Каждая реальная находка дисконтируется на эту величину.
Второй контрольный механизм — парное сравнение страниц.
Внутри каждого кластера запросов система сталкивает победителя с проигравшим, конкурента с конкурентом и анализирует полезные аномалии: две страницы на одном домене (с AI-проверкой на каннибализацию), где одна просела или выросла, а другая — нет.
Все доменные факторы взаимоуничтожаются, поэтому то, что остается в дельте — это чисто страничные сигналы по определению.
У такого подхода есть цена.
Траст сайта внутри пар на одном домене остается почти константой еще до поступления данных, поэтому нулевое влияние авторитета может оказаться следствием самого дизайна пар, а не реальным открытием.
Прежде чем делать выводы из нулей, доверительный интервал нужно дробить по типам пар.
Скоринг сворачивает отдельные атрибуты в семейства, потому что шум на уровне одного сигнала бьет по статистике слишком жестко.
Колебание одного атрибута — это шум; когда целое семейство кренится в одном направлении на тысячах парных сравнений — это уже апдейт.
База запросов подчиняется той же дисциплине: сгруппированные кластеры с языковыми вариантами.
В итоге тип интента и рынок фиксируются как управляемые переменные, а не как случайности.
Сравни транзакционный
SERP казино с информационным SERP по рецептам — и ты замеришь разницу в интенте, а не алгоритм.Два дня чистого времени в терминале на сборку.
Первый прогон: 15 тысяч запросов, 7 языков с упором на английский, около $5,000 на токены и
API-запросы.Всё это скорится по слитому корпусу атрибутов
Content Warehouse, разбитому на сотни конкретных сигналов.Категории
e-commerce подросли, тогда как главные страницы и листиклы просели, а объем бэклинков и сырой DR потеряли в весе — такая переоценка ссылочного происходит почти каждый апдейт, хотя на этот раз падение оказалось аномальным.Отдельные глубокие аудиты связывают львиную долю этих просадок с переспамленными
exact-match анкорами, ведущими прямо на мани-страницы.Семейства атрибутов, которые отделили победителей от проигравших:
— Насколько точно страница попадает в запрос
— Общая релевантность
— Ссылки, ведущие непосредственно на страницу
— Тип страницы
— Текст анкоров
Семейства, которые не пробили порог шума:
— Траст сайта
— Структура и форматирование страницы
— Свежесть контента
— Динамика ссылочного
— Язык
Это не финальный вердикт по факторам ранжирования.
Конкретно в этом датасете и во время этого апдейта данные семейства не смогли отделить растущие страницы от падающих настолько сильно, чтобы пробить скорректированный на плацебо порог.
Датасет еще сырой: базу запросов нужно увеличить в 30 раз, прежде чем несколько семейств выйдут из доверительного интервала С-класса, а некоторые колебания почти наверняка всё еще сидят в зоне плацебо.
Методология опубликована полностью.
Главный барьер для входа — это слитая карта атрибутов, историческая глубина
SERP и готовность сжигать минимум пять тысяч баксов каждый апдейт просто ради того, чтобы выяснить, где ты ошибся.Инсайты комьюнити
— Гипотеза: на фоне этого же апдейта выбор цитаций для
AI Overviews сместился в сторону сайтов с высоким DR за счет более тесной привязки к Gemini — по сути, получилась pay-to-play модель цитирования.#CoreUpdates #Experiments #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO