TGViewer
Channel Public Channel
Матчасть

Матчасть

@matchast

Высшая математика в бизнесе и жизни
vk.com/mat.chast
botcamp.timepad.ru
www.youtube.com/channel/UCoO8ApMu4QM4KQ8oGRCgOHQ
Чат: t.me/matchast_chat
Subscribers
880
Photos
27
Videos
0
Links
176

Showing posts older than #173 · Back to latest

Older Posts 20 shown
Post #170 647
Двухдневный интенсив по основам machine learning в python реинкарнируется.
ЦА: начинающиее data scientist'ы и им сочувствующие, особенно те, кому уже есть куда ML применить, и не хватает лишь знакомства с теорией и инструментами.
Ближайший запуск: следующие выходные. Стоимость: 16К за 16 часов экспресс-погружения. Подробности на сайте.
#матчасть #weirdMath
Post #168 775
Post #167 654
Давненько у нас не появлялось никаких рассказов о применении data science в настоящем хардкорном бизнесе.
Исправляем оплошность - рассказываем, как на недавнем хакатоне мы прогнозировали остановки экструдера, суровой промышленной мясорубки для полипропилена.
Застакали нейронку с xgboost'ом, вжух - и оно работает!
Post #164 716
За прошедшие майские праздники мы разобрались, как сделать чатбота-болталку, который бы выдавал примерно уместные ответы на запросы пользователя. Теперь показываю, как выпустить такого чатбота в Телеграм.

Проще всего использовать для этого готовую обёртку Telegram API для питона - например, pytelegrambotapi. Итак, пошаговая инструкция:

1) Регистрируете своего будущего бота в t.me/botfather и получаете токен доступа, который вам надо будет вставить в свой код.
2) Разово запускаете команду установки - pip install pytelegrambotapi в командной строке (или через ! прям в блокноте)
3) Запускаете код примерно как в скриншоте. Ячейка перейдёт в режим исполнения (*), и пока она будет в этом режиме, вы сможете общаться со своим ботом сколько захотите. Чтобы остановить бота, жмите Ctrl+C
4) Если вы хотите, чтобы бот работал перманентно, вам надо выложить его код на какой-нибудь облачный сервис - например, AWS, Heroku, или now.sh. О том, как запустить их, вы можете узнать в мельчайших подробностях на сайтах этих сервисов или в статьях на Хабрахабре.

На этом трилогия в 5 частях о создании чатбота-болталки заканчивается. Но впереди ещё много интересного, так что оставайтесь на линии и подписывайтесь на t.me/matchast. Добра вам!

#матчасть #weirdmath #chatbot #telegram #pytelegrambotapi #telebot 
Telegram BotFather BotFather is the one bot to rule them all. Use it to create new bot accounts and manage your existing bots.
Post #162 562
В предыдущие три дня мы закачали в python корпус диалогов, векторизовали его, и сократили размерность, а теперь хотим наконец научиться искать по нему ближайших соседей и осмысленно отвечать на вопросы.

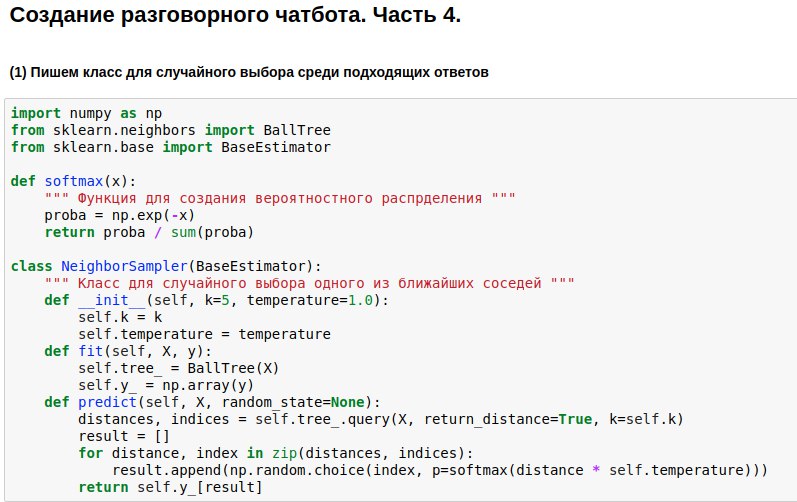
Поскольку научились отображать вопросы в Евклидово пространство не очень высокой размерности, поиск соседей в нём можно осуществлять довольно быстро. Мы воспользуемся уже готовым алгоритмом поиска соседей BallTree. Но мы напишем свою модель-обёртку, которая выбирала бы одного из k ближайших соседей, причём чем ближе сосед, тем выше вероятность его выбора. Ибо брать всегда одного самого близкого соседа - скучно, но не завязываться на сходство совсем - опасно.

Поэтому мы хотим превратить найденные расстояния от запроса до текстов-эталонов в вероятности выбора этих текстов. Для этого можно использовать функцию softmax, которая ещё часто стоит на выходе из нейросетей. Она превращает свои аругементы в набор неотрицательных чисел, сумма которых равна 1 - как раз то, что нам нужно. Дальше полученные "вероятности" мы можем использовать для случайного выбора ответа.

Фразы, которые будет вводить пользователь, надо пропускать через все три алгоритма - векторизатор, метод главных компонент, и алгоритм выбора ответа. Чтобы писать меньше кода, можно связать их в единую цепочку (pipeline), применяющую алгоритмы последовательно.

В результате мы получили алгоритм, который по вопросу пользователя способен найти похожий на него вопрос и выдать ответ на него. И иногда это ответы даже звучат почти осмысленно ^^

Осталось совсем немного - прикрутить получившегося бота к Телеграму. Про это будет наш завтрашний пост.

#матчатсть #weirdMath #chatbot #чатбот #softmax #sampling 
Post #160 495
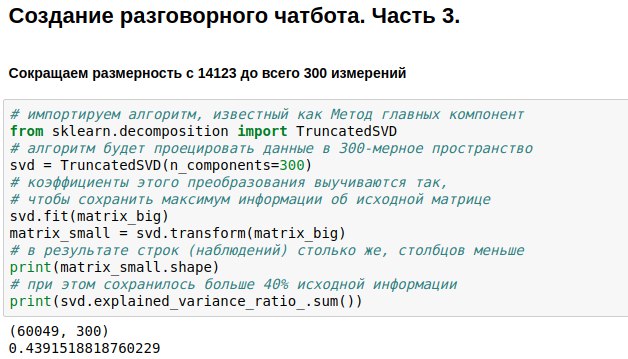
В прошлых двух постах мы поставили задачу создания болталочного чатбота, скачали и векторизовали данные для его обучения. Теперь у нас есть числовая матрица, представляющая реплики пользователей. Она состоит из 60 тысяч строк (столько было реплик в базе диалогов) и 14 тысяч столбцов (столько в них было различных слов). Сейчас наша задача - сделать её поменьше. Например, представить каждый текст не 14123-мерным, а всего лишь 300-мерным вектором.

Достичь этого можно, умножив нашу матрицу размера 60049х14123 на специально подобранную матрицу проекции размера 14123х300, в итоге получим результат 60049х300. Алгоритм PCA (метод главных компонент) подбирает матрицу проекции так, чтобы исходную матрицу можно было потом восстановить с наименьшей среднеквадратической ошибкой. В нашем случае получилось сохранить около 44% об исходной матрице, хотя размерность сократилась почти в 50 раз.

За счёт чего возможно такое эффективное сжатие? Напомним, что исходная матрица содержит счётчики упоминания отдельных слов в текстах. Но слова, как правило, употреблятся не независимо друг от друга, а в контексте. Например, чем больше раз в тексте новости встречается слово "блокировка", тем больше раз, скорее всего в этом тексте встретится также слово "телеграм". А вот корреляция слова "блокировка", например, со словом "кафтан" отрицательная - они встречаются в разных контекстах.

Так вот, получается, что метод главных компонент запоминает не все 14 тысяч слов, а 300 типовых контекстов, по которым эти слова потом можно пытаться восстановить. Столбцы матрицы проекции, соответствующие синонимичным словам, обычно похожи друг на друга, потому что эти слова часто встречаются в одном контексте. А значит, можно сократить избыточные измерения, не потеряв при этом в информативности.

Во многих современных приложениях матрицу проекции слов вычисляют нейросети. Но на самом деле простой линейной алгебры для практически полезного результата уже достаточно. Метод главных компонент вычислительно сводится к SVD, а оно - к расчёту собственных векторов и собственных чисел матрицы. Впрочем, программировать это можно, даже не зная деталей.

А в следующем посте мы расскажем, как запрограммировать поиск похожих текстов в нашем 300-мерном пространстве. Оставайтесь на связи!

#матчасть #weirdmath #chatbot #pca #svd #machinelearning 
Post #158 443
Продолжаем наш предыдущий пост про создание чатбота, который выдавал уместные ответы на реплики пользователя. Сегодня говорим о том, как превратить тексты в числовые векторы, чтобы осуществлять по ним приближённый поиск.

Вчера мы познакомились с библиотекой pandas в Python - она позволяет загружать таблицы, осуществлять поиск в них, и т.п. Сегодня затронем библиотеку scikit-learn (sklearn), которая позволяет более хитрые манипуляции с данными - то, что называется машинным обучением. Это значит, что любому алгориту сперва нужно показать данные (fit), чтобы он узнал о них что-то важное. В результате алгорити "научится" делать с этими данными что-то полезное - преобразовывать их (transform), или даже предсказывать неизвестные величины (predict).

В данном случае мы хотим преобразовать тексты ("вопросы") в числовые векторы. Это нужно, чтобы можно было находить "близкие" друг к другу тексты, пользуясь математическим понятием расстояние. Расстояние между двумя точками можно рассчитать по теореме Пифагора - как корень из суммы квадратов разностей их координат. В математике это называется Евклидовой метрикой. Если мы сможем превращать тексты в объекты, у которых есть координаты, то мы сможем вычислять Евклидову метрику и, например, находить в базе вопрос, наиболее всего похожий на "о чём ты думаешь?".

Самый простой способ задать координаты текста - это пронумеровать все слова в языке, и сказать, что i-тая координата текста равна числу вхождений в него i-того слова. Например, для текста "я не могу не плакать" координата слова "не" равна 2, координаты слов "я", "могу" и "плакать" равны 1, а координаты всех остальных слов (коих десятки тысяч) равны 0. Такое представление теряет информацию о порядке слов, но всё равно работает неплохо.

Проблема в том, что у слов, которые встречаются часто (например, частиц "и" и "а") координаты будут несоразмерно большие, хотя информации они несут мало. Чтобы смягчить эту проблему, координату каждого слова можно поделить на логарифм числа текстов, где такое слово встречается - это называется tf-idf и тоже работает неплохо.

Проблема только одна: в нашей базе 60 тысяч текстовых "вопросов", в которых содержится 14 тысяч различных слов. Если превратить все вопросы в векторы, получится матрица 60к*14к. Работать с такой не очень классно, поэтому завтра мы поговорим о сокращении размерности. Stay tuned!

#матчасть #weirdmath #chatbot #sklearn #tfidf #vectorization #machinelearning 
Post #155 423
Начались длинные майские праздники, за которые вполне можно было бы научиться чему-нибудь новому и классному. Например, написать на Python собственного чатбота, способного поддержать беседу. Этим мы и займёмся.

Идти будем маленькими шагами: сначала вспомним, как загружать данные в Python, затем научимся считать слова, постепенно подключим линейную алгебру и теорвер, и под конец сделаем из получившегося болтательного алгоритма бота для Телеграм. Поэтому подписывайтесь сюда или на t.me/matchast, и следите за постами!

Итак, начинаем. Наша задача - сделать алгоритм, который на любую фразу будет давать уместный ответ. Например, на "как дела?" отвечать "отлично, а у тебя?". Самый простой способ добиться этого - найти готовую базу вопросов и ответов. Например, взять субтитры из большого количества кинофильмов.

Я, впрочем, поступлю ещё более по-читерски, и возьму данные из соревнования Яндекс.Алгоритм - это те же диалоги из фильмов, для которых работники Толоки разметили хорошие и неплохие продолжения. В таблице даны три последних фразы и ответ на них (reply), но мы будем пользоваться только самой последней из них (context_0).

Имея такую базу диалогов, можно просто искать в ней каждую реплику пользователя, и выдавать готовый ответ на ней (если таких реплих много, выбирать случайно). С "как дела ?" такое отлично получилось, о чём свидетельствует приложенный скриншот. Это, если что, jupyter notebook на Python 3. Если вы хотите повторить такое сами, проще всего установить Анаконду (anaconda.com) - она включает Python и кучу полезных пакетов для него.

Проблема дословного поиска в том, что у него низкое покрытие. На фразу "как твои дела ?" в базе из 40 тысяч ответов точного совпадения не нашлось, хотя смысл у неё тот же самый. Поэтому в нескольких ближайших постах мы будем дополнять наш код, применяя разную математику, чтобы реализовать приближённый поиск. А вы пока можете почитать про библиотеку pandas (pandas.pydata.org/pandas-docs/stable/10min.html) и разобраться, что же делает каждая из 6 строк приведённого кода.

До скорого!
#матчасть #weirdmath #chatbot #python #pandas 
Telegram Матчасть Высшая математика в бизнесе и жизни vk.com/mat.chast botcamp.timepad.ru www.youtube.com/channel/UCoO8ApMu4QM4KQ8oGRCgOHQ Чат: t.me/matchast_chat
Post #151 409
Датафест - это круто само по себе. А теперь там есть ещё и воркшоп для прекрасного пола (

P.S. никогда не думал, что буду репостить картинки с соединёнными точками, но чего только в жизни не бывает)

Впервые в России проводится официальное аффилированное мероприятие международного воркшопа Women in Machine Learning, которое пройдет на пятом московском фестивале Data Fest 28 апреля! Секция WiML пройдет в 17.45 в Lumiere Hall 2.

Data Fest — это крупнейшая бесплатная конференция, объединяющая исследователей, инженеров и разработчиков, связанных с data science. В свою очередь миссия воркшопа Women in Machine Learning — увеличение числа женщин-исследователей ML, а также их вклада в развитие профессиональной области.

Регистрация на фест: https://datafest.timepad.ru/event/706598/

Анонс секции на официальном сайте WiML:
http://wimlworkshop.org/sh_events/wiml-affiliated-event-at-data-fest-moscow/
datafest.timepad.ru Data Fest 5 / События на TimePad.ru Data Fest — это крупнейшая бесплатная конференция, объединяющая исследователей, инженеров и разработчиков, связанных с data science.
Post #149 365
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →