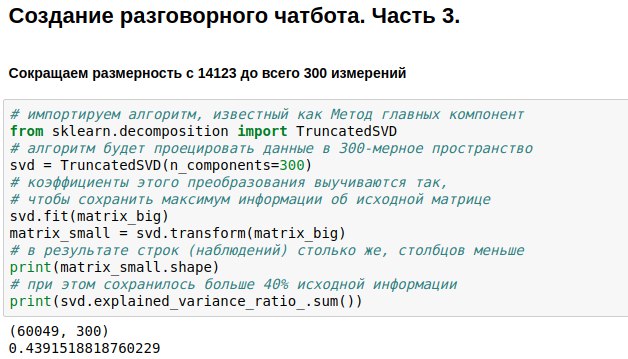
В прошлых двух постах мы поставили задачу создания болталочного чатбота, скачали и векторизовали данные для его обучения. Теперь у нас есть числовая матрица, представляющая реплики пользователей. Она состоит из 60 тысяч строк (столько было реплик в базе диалогов) и 14 тысяч столбцов (столько в них было различных слов). Сейчас наша задача - сделать её поменьше. Например, представить каждый текст не 14123-мерным, а всего лишь 300-мерным вектором.
Достичь этого можно, умножив нашу матрицу размера 60049х14123 на специально подобранную матрицу проекции размера 14123х300, в итоге получим результат 60049х300. Алгоритм PCA (метод главных компонент) подбирает матрицу проекции так, чтобы исходную матрицу можно было потом восстановить с наименьшей среднеквадратической ошибкой. В нашем случае получилось сохранить около 44% об исходной матрице, хотя размерность сократилась почти в 50 раз.
За счёт чего возможно такое эффективное сжатие? Напомним, что исходная матрица содержит счётчики упоминания отдельных слов в текстах. Но слова, как правило, употреблятся не независимо друг от друга, а в контексте. Например, чем больше раз в тексте новости встречается слово "блокировка", тем больше раз, скорее всего в этом тексте встретится также слово "телеграм". А вот корреляция слова "блокировка", например, со словом "кафтан" отрицательная - они встречаются в разных контекстах.
Так вот, получается, что метод главных компонент запоминает не все 14 тысяч слов, а 300 типовых контекстов, по которым эти слова потом можно пытаться восстановить. Столбцы матрицы проекции, соответствующие синонимичным словам, обычно похожи друг на друга, потому что эти слова часто встречаются в одном контексте. А значит, можно сократить избыточные измерения, не потеряв при этом в информативности.
Во многих современных приложениях матрицу проекции слов вычисляют нейросети. Но на самом деле простой линейной алгебры для практически полезного результата уже достаточно. Метод главных компонент вычислительно сводится к SVD, а оно - к расчёту собственных векторов и собственных чисел матрицы. Впрочем, программировать это можно, даже не зная деталей.
А в следующем посте мы расскажем, как запрограммировать поиск похожих текстов в нашем 300-мерном пространстве. Оставайтесь на связи!
#матчасть #weirdmath #chatbot #pca #svd #machinelearning
Post #160
495