TGViewer
Channel Public Channel
per malī ad astra

per malī ad astra

@maliastra

Путевые заметки android техлида.
https://ivan.nullptr.party
Subscribers
177
Photos
79
Videos
3
Links
67
Recent Posts 16 shown
Post #206 140
Расскажите, как вы забивали гвозди пушкой и стреляли по воробьям из микроскопа.

Я безумно горжусь: мой доклад отобрали для нового сезона андроидной подлодки. Вместе с Филиппом Шадриным и Дмитрием Мовчаном обсудим работу с ошибками с помощью LLM, я расскажу про свой плагин для конвертации крашей из Crashlytics в Jira тикеты :)

Помню, как я несколько раз залетал на сезоны как слушатель, ощущения всегда были сугубо положительные - мастодонты индустрии рассказывают интересные кейсы.
Мой синдром самозванца до сих пор не может отойти от такого события, буду с ним разбираться отдельно.

А основная цель поста - разыграть два билета на подлодку. Пройдёт она с 21 по 25 сентября, каждый день два блока: 12:00–13:00 и 21:00–22:00 по Алматы (UTC+5). Концепция розыгрыша: расскажите про кейс, когда выбор LLM как инструмента себя не оправдал. Что-то в виде проблема -> решение через LLM -> проблемы решения -> решение без LLM. Мне такое интересно, в докладе как раз будет пункт о том, что иногда скрипты сильно выигрывают у LLM по скорости (в сто раз, Карл!) и цене. Кейсы желательно разработческие, но можно и не только. Да и в принципе без четвёртого пункта тоже можно.

Один билет отдам автору самого интересного/болезненного для меня кейса, а второй разыграю рандомом. Этот же пост есть в линке, пул участников общий. Сезон начинается в понедельник, так что итоги подведу в воскресенье вечером.

А, ну и если участвовать не хотите, но на подлодку хотите, то вот промокод на скидку: maliastra.
Post #205 225
per malī ad astra Я иду на AI-конференцию Community Sprints 8-10 сентября. Три дня про то, как AI-native команды внедряют ИИ: реальные кейсы, разборы и практика от людей из международного бигтеха. Бесплатно и онлайн. Присоединяйтесь: https://communitysprints.ru/aiconf-se…
Мероприятие интересное, после реги будет предложение разместить афишу как сверху, и если в чате/канале/на вашем линке или инсте больше 100 подписчиков, то можно будет получить доступ ко всем докладам в записи. С учётом большого количества спикеров и позднего времени начала в Алматы, звучит очень соблазнительно :)
Post #204 207
Я иду на AI-конференцию Community Sprints 8-10 сентября.

Три дня про то, как AI-native команды внедряют ИИ: реальные кейсы, разборы и практика от людей из международного бигтеха. Бесплатно и онлайн.

Присоединяйтесь: https://communitysprints.ru/aiconf-september/?utm_source=share&utm_campaign=aiconf-sept&utm_medium=referral&utm_content=u312281930
Post #203 245
Когда читаешь такие сообщения, то думаешь, что we've made it!

Кста, по лайнапу есть понимание, с локацией последние уточнения.
Post #202 329

Forwarded from nullptr.party

🚀 Ищем спикеров на nullptr.talks[3]

📅 Когда: сентябрь 2026

📍 Где: to be announced

⏰ Заявки принимаем до: 15.08.26

🎯 Что нас интересует:
- AI в разработке (практическое применение)
- Мобильная разработка (iOS, Android, cross-platform)
- Фулстек решения (от API до UI)
- Околоразработка (работа лидов, QA, дизайн)

💡 Ищем доклады на русском/казахском

✅ Что важно:
- живой опыт из реальных проектов
- проблемы, решения, выводы
- код, демо, практические примеры
- подойдут даже неудачные эксперименты

🔥 Формат: 20-25 минут доклад + активное Q&A

👥 Аудитория: разработчики и не только

📹 Запись и публикация в комьюнити almaty.nullptr.party

👉 Подать заявку: [ссылка]
Post #201 231
Ah shit, here we go again. Го выступать
Post #199 461
Эффект двунаправленный. В плюс: чистый, структурированный вывод — это лучший сигнал/шум, модель меньше отвлекается на ANSI-мусор и прошедшие тесты, дольше живёт до compaction. Для типовых команд (git, тесты, линтеры) качество рассуждений скорее растёт, чем падает — модель видит ровно то, что нужно для решения.

В минус: любая lossy-компрессия — это ставка на то, что фильтр правильно угадал, что важно. На 100+ поддерживаемых командах эвристики вылизаны, но на edge-cases возможна деградация: агент получает «FAILED: 2/15» без нюанса, который был в полном stack trace, и делает лишнюю итерацию. Tee-механизм это смягчает, но добавляет шаг.

Практический совет под твой контекст (внедрение LLM в департаменте): ставь себе, гоняй rtk gain пару недель, и смотри не только на tokens saved, но и на то, не выросло ли число повторных чтений/перезапусков команд у агента. Кстати, это красиво ложится в твою метрику LLM Efficiency — если rtk реально работает, median task time должен падать при том же LLM code share. exclude_commands в конфиге позволяет точечно выключать фильтры там, где они мешают. Для командного rollout — только после того, как убедишься, что фильтры не режут вывод ваших специфичных Gradle/Android-тулчейнов (Android-сборки в списке из коробки, замечу, нет — grep по README не находит gradle-фильтра, скорее всего пойдёт через generic rtk err/rtk test).
Post #198 335
Анализ Fable:

Отвечу как эксперт по инженерии LLM-агентов и оптимизации контекста, с опытом внедрения agentic-инструментов в enterprise-командах.

TL;DR: rtk — прокси между shell и агентом, который сжимает вывод CLI-команд до попадания в контекст. Экономия реальная (в среднем 60–90% на типовых командах), риски — потеря сигнала при агрессивной фильтрации и неполное покрытие (встроенные тулы Claude Code хук обходят). Для терминал-центричных воркфлоу — почти чистый выигрыш, для универсального стандарта команды — с оговорками.

Как это работает

rtk фильтрует и сжимает вывод команд до того, как они попадут в контекст LLM. Один Rust-бинарник, 100+ поддерживаемых команд, <10ms оверхеда. [github](https://github.com/rtk-ai/rtk) Четыре стратегии: умная фильтрация шума, группировка похожих элементов, обрезка избыточности и дедупликация повторяющихся строк логов. [github](https://github.com/rtk-ai/rtk) Ключевой механизм для Claude Code — PreToolUse-хук, который прозрачно перехватывает Bash-команды и переписывает их в rtk-эквиваленты до выполнения. [github](https://github.com/rtk-ai/rtk)

Плюсы

Экономия ощутимая: типовая 30-минутная сессия Claude Code — ~118K токенов на рутинных командах против ~24K с rtk (-80%), [github](https://github.com/rtk-ai/rtk) причём тесты жмутся сильнее всего — cargo test при падении с 200+ строк до ~20: видно какие тесты упали и почему, без чтения 13 прошедших. [DEV Community](https://dev.to/arshtechpro/how-rtk-reduces-llm-token-usage-for-ai-coding-agents-2kfd)

Это не только про деньги — это про качество работы агента. Меньше шума → медленнее заполняется контекст → реже compaction → агент дольше держит нить задачи. Когда контекст переполняется, агент перезапускается и теряется нить; на flat-rate планах rate-лимиты наступают на 40% быстрее. [RTK](https://www.rtk-ai.app/)

Продумана деградация: при падении команды rtk сохраняет полный нефильтрованный вывод на диск, чтобы LLM мог его прочитать без повторного запуска. [github](https://github.com/rtk-ai/rtk) Это снимает главный страх «а вдруг отфильтровали важное».

Зрелость: 64.9k звёзд, 216 релизов, Apache 2.0, телеметрия выключена по умолчанию и требует явного opt-in. [github](https://github.com/rtk-ai/rtk)

Минусы и подводные камни

Главная дыра в покрытии: хук работает только на Bash-вызовах; встроенные тулы Claude Code — Read, Grep, Glob — его обходят и не переписываются. [github](https://github.com/rtk-ai/rtk) Если агент активно использует нативные инструменты чтения файлов (а современный Claude Code это делает много), значительная часть расхода токенов остаётся нетронутой. Один аналитик прямо пишет, что этого одного факта достаточно, чтобы дисквалифицировать RTK как универсальный дефолт для многих инженерных организаций; правильная стратегия — выборочная стандартизация, а не тотальный rollout. [Firstaimovers](https://radar.firstaimovers.com/should-you-standardize-rtk-for-claude-code-yet)

Риск потери сигнала. Заявление вендора «фильтруется только шум, ошибки сохраняются полностью» — это claim, не гарантия. На нетиповых выводах (кастомные тест-раннеры, нестандартные форматы логов) фильтр может срезать контекст, который модели был нужен, и агент пойдёт перепроверять — сжигая токены на re-read. Это ровно тот антипаттерн, который сообщество описывало для агрессивных «сжимателей» контекста: агент теряет доверие к неполным данным и уходит в циклы перепроверки. [Medium](https://batnamv.medium.com/token-inflation-nightmare-are-your-claude-ai-hacks-actually-burning-your-cash-90ade0761640)

Плюс мелочи: на нативной Windows хук не работает (только CLAUDE.md fallback), полная поддержка — через WSL, [DEV Community](https://dev.to/arshtechpro/how-rtk-reduces-llm-token-usage-for-ai-coding-agents-2kfd) и на crates.io есть коллизия имён с другим пакетом rtk. [github](https://github.com/rtk-ai/rtk)

Влияние на качество работы LLM — мой вердикт
GitHub GitHub - rtk-ai/rtk: CLI proxy that reduces LLM token consumption by 60-90% on common dev commands. Single Rust binary, zero dependencies CLI proxy that reduces LLM token consumption by 60-90% on common dev commands. Single Rust binary, zero dependencies - rtk-ai/rtk
Post #197 197
Длинные сессии с тестами, линтерами, git, логами сильно положительное
Claude Code / Cursor / Gemini с настоящим hook положительное, заметное
Codex CLI через AGENTS.md умеренное, зависит от послушности модели
Android/Gradle-проект потенциально полезно, но обязательно проверять
Инциденты, метрики, JSON-данные, security output может вредить
Короткие команды и маленькие выводы почти ноль
Команды через task runner’ы типа just, mise, task, make может промахиваться, потому что RTK видит wrapper, а не реальную команду; это прямо описано как проблема в issue.


Главная мысль: RTK повышает качество не потому, что LLM становится умнее, а потому что в контекст попадает меньше мусора. Но когда “мусор” на самом деле содержит важный сигнал, качество падает.

Как бы я внедрял у себя

Для личного теста — да, ставить. Для рабочего окружения — аккуратно.

Я бы начал так:

brew install rtk
rtk init --global
rtk init --show
rtk telemetry status

Потом прогнать 2–3 реальные Claude/Codex-сессии и смотреть:

rtk gain
rtk session
rtk discover

Но я бы сразу исключил рискованные команды:

[hooks]
exclude_commands = [
"aws",
"kubectl logs",
"docker logs",
"security",
"trivy",
"gitleaks",
"semgrep",
"git diff --stat",
"git rebase",
"git cherry-pick"
]

Для Android/Kotlin отдельно проверил бы:

rtk ./gradlew test
rtk ./gradlew lint
rtk ./gradlew assembleDebug
rtk ./gradlew :app:testDebugUnitTest

И сравнил бы не только токены, а главное: агент после RTK чинит ошибку быстрее или начинает тупить и просить raw output?

Итог

Да, штука полезная. Особенно для Claude Code-подобных CLI-агентов, которые много гоняют команды и засирают контекст логами.

Но как tech lead я бы не продавал это команде как “улучшает качество LLM на 80%”. Честнее так:

> RTK снижает CLI-шум и экономит контекст. На verbose-командах это часто улучшает агентскую работу. На data/security/debug-командах может скрыть важные детали, поэтому нужен allowlist/denylist и локальный benchmark на нашем стеке.


Для твоего кейса: поставить и попробовать — да. Глобально включить без exclude list — нет.
Post #196 179
Анализ gpt:

Мой вердикт: RTK стоит попробовать, но не как “улучшатель интеллекта”, а как фильтр шума между CLI и агентом. Он может заметно улучшить работу LLM в длинных CLI-сессиях, но может и ухудшить качество, если режет именно те детали, по которым агент должен принимать решение.

Что это вообще такое

RTK — это CLI-прокси: агент запускает команду, RTK перехватывает вывод, фильтрует его и отдаёт LLM более компактную версию. Авторы заявляют 60–90% экономии токенов; механизм — smart filtering, grouping, truncation и deduplication.

Условно:

git status
# превращается в
rtk git status

И модель видит не сырой verbose-вывод, а короткую сводку.

Плюсы

1. Меньше мусора в контексте. Это главный плюс. Тесты, линтеры, git status, git log, docker logs, kubectl logs, pytest, cargo test, tsc, eslint и похожие команды часто вываливают кучу boilerplate. RTK специально режет passed-тесты, прогресс-бары, повторяющиеся строки, длинные JSON и служебный шум.

2. В длинной сессии LLM меньше “захламляется”. Это влияет не только на деньги/лимиты, но и на качество: модель меньше тащит в рассуждение случайные строки логов и меньше теряет важные инструкции из начала контекста. Особенно полезно, когда агент гоняет тесты/линтеры по кругу.

3. Хорошо ложится на agentic coding. Для Claude Code, Cursor, Copilot, Gemini и части других инструментов RTK может работать через hook/plugin и прозрачно переписывать команды до выполнения. Для таких агентов эффект максимальный.

4. Есть safety-valve через raw output. При ошибках RTK может сохранять полный нефильтрованный вывод в tee-файл, чтобы агент мог дочитать детали без повторного запуска команды. Это правильная архитектурная идея: сначала короткая сводка, потом raw только по необходимости.

5. Для Android/Kotlin стало интереснее, чем раньше. В changelog есть Gradle/gradlew support для Android/Kotlin-разработчиков в версии 0.40.0. Но я бы не считал это зрелым без проверки на твоём проекте, потому что по issues вокруг Gradle-фильтров были проблемы с matcher’ами и качеством фильтрации.

Минусы и риски

1. Это не всегда улучшает качество. Иногда наоборот. Если команда возвращает данные, где важны конкретные значения, RTK может выкинуть именно смысл. В issue по AWS приводят пример, где CloudWatch/WAF-метрики превращались в placeholders вроде Sum: float, из-за чего расследование инцидента становилось бесполезным.

2. Claims в README завышены для части команд. Есть community-бенчмарк на 5 репозиториях и 2,100 измерениях: git log сжимался отлично, ls хорошо, но git diff дал около 20% вместо заявленных 75%, tree — около 4%, cat — 0%. Это не “RTK плохой”, но значит, что реальный выигрыш зависит от твоего command mix.

3. LLM может начать компенсировать потерю деталей. Есть issue, где автор утверждает, что сжатие входа на 80% привело к росту output на 50% и итоговому росту стоимости на 18%, потому что агенту не хватало структурированных деталей и он рассуждал/переспрашивал больше. Это один кейс, не абсолютная истина, но риск реальный.

4. Для Codex CLI эффект слабее, чем для Claude Code. В таблице RTK Codex CLI указан как AGENTS.md instructions, а не как transparent hook. В документации RTK прямо объясняет: rules-file integrations полагаются на то, что модель будет следовать инструкциям, тогда как full hook гарантированно переписывает команду до выполнения.

5. Инструмент сидит в критичной точке доверия. Он может менять то, что видит LLM. В security review issue прямо описан риск: если фильтр скомпрометирован или слишком агрессивен, он может скрыть findings сканера, переписать вывод или убрать важные ошибки.

6. Telemetry надо проверить руками. README и privacy page говорят, что telemetry disabled by default и требует opt-in, но configuration page всё ещё показывает [telemetry] enabled = true и описывает ежедневный ping. Перед корпоративным внедрением я бы обязательно запускал rtk telemetry status и фиксировал policy через env/config.

Насколько влияет на качество LLM в CLI-режиме

Я бы оценил так:

Сценарий Влияние
Post #195 177
Погонял Fable в чятике немного, со сравнением с gpt 5.5 high.

1) попросил проанализировать https://github.com/rtk-ai/rtk.

Разбор и анализ глубже и подробнее, хоть и с пропуском пары мелочей, итоговые выводы и аргументы не различаются.

При перекрестном анализе выводов обе llm подчеркнули комплементарность анализов. По мнению gpt анализы сравнимы по качеству, но смотрят на немного разные стороны тулзы. По мнению Fable его анализ слабее. 60/40, gpt побеждает. Но у Claude есть история скромности и оценки себя хуже по сравнению с gpt моделями. Возможно скромность ложная.

Ниже приложу оба анализа, а саму тулзу люто, бешено рекомендую. С её использованием в claude code не чувствую себя second class citizen юзая opus на двадцатибаксовой подписке, в лимиты стал упираться сильно меньше. По codex не смогу сравнить до и после, так как "до" довольно короткое.

2) попросил проанализировать пета, игрушку gomoku. Аля японские крестики-нолики.

gpt сам разобрался, что проект на ветке mvp, не main. Fable так не смог, пришлось направлять руками. Качество анализа и предложений у Fable понравилось сильно больше. Если можно так выразиться в контексте LLM, то как будто больше фантазии и шире аналитика. Аналогичные пункты раскрыты лучше.

По анализу победа за Fable, по discovery было грустно.

В итоге, на основе двух чятиков: gpt чуть глубже в технике, Fable сильно шире, особенно когда речь идёт о задачах, где нужно что-то типа фантазии.
GitHub GitHub - rtk-ai/rtk: CLI proxy that reduces LLM token consumption by 60-90% on common dev commands. Single Rust binary, zero dependencies CLI proxy that reduces LLM token consumption by 60-90% on common dev commands. Single Rust binary, zero dependencies - rtk-ai/rtk
Post #194 353
Как обещал [LinkedInовцам], пишу подробности о митапе. Сначала главное — ссылка для регистрации, там все формальные подробности. https://forms.gle/ejrAnmPbVCKddqMA9

Чем писать дату (28.05), время (18.30) и место (БЦ Фортис), лучше инсайдов накидаю.

Паша рассказывает о том, как в Qazcode решили не ждать Google ещё 5 лет (да, первая стабилка компоста вышла 06.2021) и написали свой* webview — без азартных игр и куртизанок, зато нативный compose и с кучей параметров на входе.

Даник расскажет про BDUI здорового человека. Не так много аббревиатур в разработке вызывают у меня раздражение настолько сильное, как эти четыре буквы.

Ведь у нас в мобилках всё сложно — два нативных стека, разрастающаяся и одновременно разлагающаяся горка мультиплатформенных фреймворков, ящик легаси на XML и UIKit, горсть забористых решений на Objective-C и Java, которые даже LLM уже не разберёт. Не то чтобы всё это нужно для тонкого клиента, но когда залипаешь в высокую инженерию ради высокой инженерии — притормозить трудно.

Единственное, чего я по-настоящему боялся, — это BDUI. А ничего нет беспомощнее, безответственнее и порочнее, чем команда, его поддерживающая. И вот мы стоим на краю. Даник кивает вниз — он уже нырнул в эту бездну, чтоб нам не пришлось. Туда, где Button приходит по сети, а вёрстка живёт на сервере и меняется без твоего ведома. «Жми на газ, — усмехнулся он. — Это уже BDUI country».

И несмотря на всё вышесказанное, я практически готов купить Remote Compose — коллега настоящий адвокат дьявола.

Извиняюсь за столь многослойное лирическое отступление, BDUI очень много эмоций вызывает. Не самых приятных.

Анель Кадырова подготовила вторую часть блокбастера (ссылка на первую часть https://www.youtube.com/watch?v=QUBeYUbd1mA). Теперь мы будем ускорять сборку через контроль связности компонентов и архитектуры. Узнаете про тонкости взаимодействия api- и implementation-модулей, ABI, граф зависимостей, метрики связности и влияние всего этого на стабильность и скорость сборки.

Макс Качинкин расскажет, как внедрять KMP настолько постепенно, что этого не заметят ни клиенты, ни бизнес. И только самые внимательные айосеры задумаются, почему их swift стал как-то слегка котлинутее.
Ждём приятной и уютной атмосферы разрыва шаблонов и лёгкого запашка переполненных стеков. Приходите!
Post #192 288
В прошлом году я стеснялся даже своей команде признаваться, что пишу код, а особенно тесты, нейронками. В этом году уже полушутя (или полусерьёзно?) говорю, что если разработчик не пользуется llm, то его надо увольнять.

У нас ведь, как говорится, большой 2к26 на дворе. Инструментария создано много, на любой вкус и цвет. Расценок много, на любой кошелёк. Для параноиков есть локальные модели. Да, они слабее и/или требуют больших ресурсов для запуска, но быть параноиком всегда недёшево, хотя иногда и оправданно.

Это что касается кода.

А в плане нейроконтента тоже сдвиги колоссальные. От лавкрафтианского Уилла Смита поглощающе[мо]го макаронного монстра мы пришли к Gossip Goblin и это sci fi уровня, которого мы ещё не заслужили.

Если кратко, то повторюсь, не раз говорил это в докладах. Не надо субъектизировать llm и делать их эрзац-людьми. Это инструмент, а творец/инженер/пользователь в конце концов, использующий этот инструмент, — это всегда человек. Этот человек должен награждаться ответственностью и нести тяжкое бремя похвалы за результат.

Пост родился в ответ на замечательное наблюдение в двух частях.
Telegram AI меняет культуру | Trabun 👁️👁️Слопшейминг — это слатшейминг эпохи нейросетей | Манифест слоп-художника | Часть 1 В 2025-м Merriam-Webster выбрал «слоп» словом года. Так возник слопшейминг — любимая забава современного культурного класса. Регистр у слатшейминга и слопшейминга идентичный.…
Post #191 319
LLM ломают ещё и собесы, причём речь не про live подсказки.

Сели мы с мужиками в лодку... . Провели мы вчера с коллегой техлидом другого приложения 5 блиц собесов по 30 минут подряд.

Уже пару лет собесим по опроснику- табличке, где оцениваем ответ на каждый вопрос. Вопросы поделены по грейдам и категориям, в результате - число от 1 до 5, от trainee до staff. Обычно на собес уходило часа полтора.

Таблицу подкорректировал под блиц, какие-то секции выбросил, добавил секцию по LLM, ну и всякого по мелочи.

В ретроспективе показалось самым интересным, как кандидаты отвечали как раз-таки на вопросы по секции LLM. Даже такая маленькая выборка оказалась вполне себе репрезентативной:
- попробовал, фигня какая-то, сам пишу
- юзаю Gemini в студии для написания тестов
- юзаю чатики не только для тестов
- юзаю чатики, но слышал про cli, мечтаю попробовать
- юзаю cli, учусь делать MCP

Некоторые ссылались на политики взаимодействия с LLM в рамках рабочего проекта. Со своими котом, женой и дочерями говорить о том, что в большом 2к26 могли бы и после работы навейпкодить и ознакомиться хотя бы с хайповым инструментарием, было неловко.

Это мне повезло, что в рамках разумного я на проекте могу юзать любой инструментарий и немного вейпкожу дома, когда жена не видит. Не только лишь все могли смотреть в завтрашний день устраиваясь на работу.

Мне не совсем понятно, зачем нужны душные вопросы по кишкам Android или, Б-же упаси, алгоритмам. Кажется, что это как у бухгалтера спрашивать сколько будет (3435 + 57643/42) * 0,75 + 2МРП за каждую тысячу телят в Акмолинской области. И чтоб всё в уме, без камплюктеров, калькуляторов и бумаги.

Ну да, хорошо бы, чтобы все всё могли и знали, но насколько такие собесы имеют отношение к реальной работе? Как в той классической шутке "разверните красно-чёрное дерево на доске, чтобы мы разрешили вам перекрашивать кнопки".

Рефлексируя над вчерашними собесами хочется уйти от старого опросника к новому блицу на полчаса, потому что ну не готов я отказаться от теории полностью. Но добавить что-то практическое минут на 30-40. Причём чтоб в режиме олимпиады из одноимённого трека 2h Company, со всеми легальными и не очень механиками и инструментами. Чтоб можно было увидеть как человек работает в условиях приближённых к реальным.

Интервьюеры, вы как-то адаптируетесь к меняющемуся миру? Или и так пойдёт?
YouTube 2H Company - Олимпиада (есть есть есть) видео Аниматрица (The Animatrix) монтаж RASH
Post #186 419

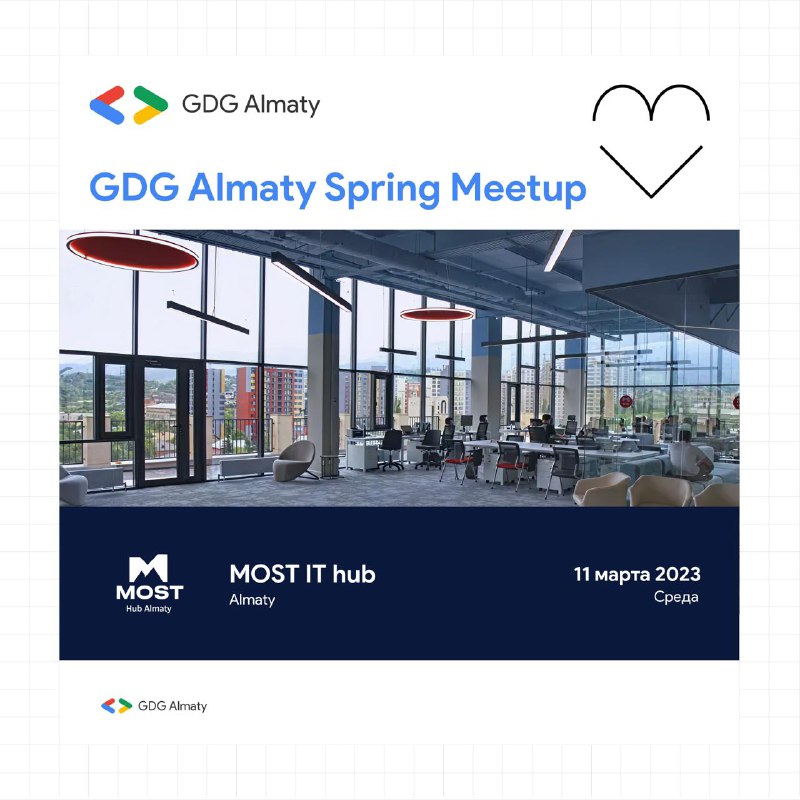
Forwarded from GDG Almaty

🚀 GDG Almaty Spring Meetup — знакомим со спикерами!
11 марта 2026 года в MOST IT Hub
📍 г. Алматы, ул. Ходжанова 2/2, БЦ Fortis
пройдёт GDG Almaty Spring Meetup — встреча для тех, кто живёт технологиями, продуктами и сообществом.
Сегодня знакомим вас со спикерами мероприятия 👇

🎤 Александр Тютин
DevSecOps в Semrush (компания из США, приобретённая Adobe в 2025 году).
Александр занимается безопасностью облачной инфраструктуры и менторит команды Technovation Girls Kazakhstan, где также развивает ИИ-помощника Oqytu bot для детей.
На митапе он расскажет:
— о практических вызовах при разработке AI-ассистента
— о работе с Vertex AI
— о контроле расходов в проектах Google Cloud Platform

🎤 Оман Абышев
Founder & CEO at Oscar and Sons Group, технологический предприниматель с более чем 10-летним опытом в IT: PM, BA и business development.
Certified Airtable Builder и Softr Professional, работал на C-level позициях в международных IT-компаниях.
Оман поделится:
— реальным опытом разработки на No-code / Low-code
— созданием MVP-продуктов
— автоматизацией процессов с Airtable, Softr, n8n, AppSheet
— и обсудит, куда движется рынок классического аутсорса.

🎤 Abzal Serikbay
Flutter-разработчик с более чем 4 годами опыта мобильной разработки.
Работает в BCC Hub, где создаёт мобильные продукты и активно использует AI-инструменты в ежедневной разработке.

🎤 Максим Качинкин
• Более 10 лет в мобильной разработке
• Tech Lead в Dodo Engineering (Dodo Pizza, Drinkit)
• Директор программного комитета Podlodka Android Crew
• Автор Telegram-канала «Мобильное Чтиво»
Любит конференции, живые ивенты, музыку и котов — и умеет рассказывать о мобильной разработке так, что это действительно интересно.

💡 Будем рады видеть разработчиков, продакт-менеджеров, дизайнеров и всех, кто строит технологические продукты.
#GDG #Almaty #TechCommunity #Developers #AI #MobileDevelopment #NoCode
Older posts →

About this channel

How can I read @maliastra without a Telegram account?
TGViewer shows the public web preview Telegram publishes for per malī ad astra: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does per malī ad astra have?
per malī ad astra (@maliastra) has 177 subscribers on Telegram, refreshed roughly every 30 minutes.
Does per malī ad astra know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →