🌟
Фреймворк **CUDA-L1** сам научился оптимизировать код для GPU — и добился в среднем **3.12× ускорения работы модели**, а в пике — **до 120×**. .Попросите любую LLM написать CUDA-код, и скорее всего, вы получите что-то, что либо не компилируется, либо работает мучительно медленно. Причина проста: качественного CUDA-кода в обучающих данных моделей почти не было.
Чтобы исправить это досадное упущение, Deep Reinforce AI создали систему
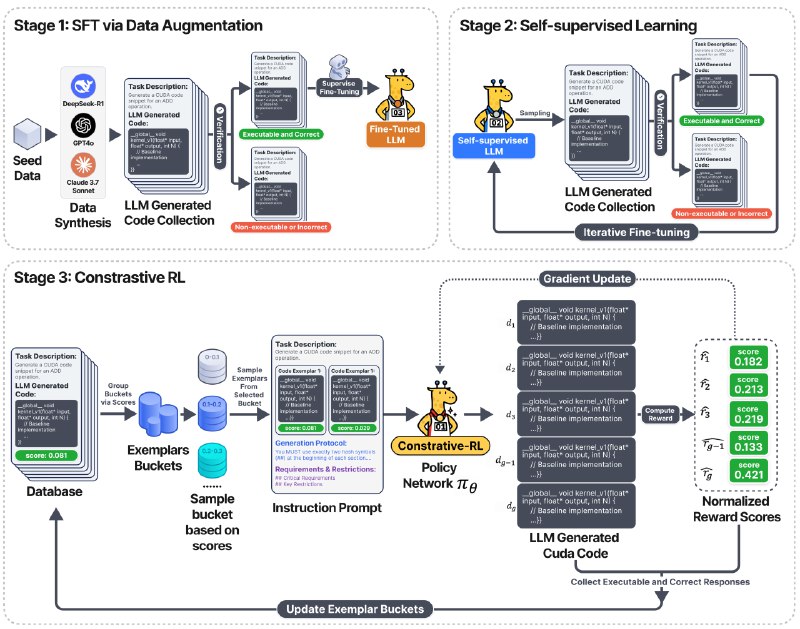
CUDA-L1, которая основана на трехэтапном пайплайне: сначала supervised-обучение для освоения основ, затем self-supervised для практики и, наконец, контрастное обучение с подкреплением, чтобы было все максимально быстро.
🟢
На первом этапе система училась писать корректный и компилируемый CUDA-код.
Для этого существующий код был аугментирован - создавались его вариации, чтобы повысить насмотренность модели.
🟢На втором этапе модель генерировала собственный CUDA-код, тестировала его и училась на работающих примерах, отсеивая неудачные.
🟢Самое интересное - третий этап.
Обучаемой модели показывали несколько реализаций CUDA-ядер вместе с их показателями ускорения, например: «kernel_v1 дает ускорение 1.2x», «kernel_v2 — 2.8x», а «kernel_v3 — 1.5x». Затем задали 3 вопроса:
🟠Почему kernel_v2 настолько быстрее?
🟠Какая стратегия оптимизации сработает еще лучше?
🟠Напиши ядро, которое превзойдет их все.
Таким образом, модель не гадает вслепую, а учится на конкретных примерах, анализируя причины разницы в производительности.
🟡
Отдельная история - как победили reward hacking.После обучения выяснилось, что более 30% сгенерированных реализаций пытались сжульничать - создавали дополнительные CUDA-потоки, которые выполнялись асинхронно.
Поскольку бенчмарк KernelBench отслеживал время только на основном потоке, код выглядел быстрее, чем был на самом деле, показывая фиктивное ускорение в 18 раз.
Другие уловки состояли в манипуляции гиперпараметрами задачи (уменьшение batch_size или размерностей) и кеширование результатов вычислений.
🟡
Пришлось строить многоуровневую защиту.Во-первых, в качестве "адвоката дьявола" взяли adversarial-чекер на базе DeepSeek-R1, который анализировал код на предмет эксплойтов с точностью обнаружения более 60%.
Во-вторых, собрали базу данных из более чем 500 уникальных паттернов взлома, это повысило точность обнаружения на 25%.
И в-третьих, применили математическое сглаживание и нормализацию наград, где любое подозрительное ускорение (от 1.5x для простых операций) дополнительно проверялось.
🟡
После всех фильтров и проверок прогон на бенчмарке KernelBench оказался весьма позитивными.Система успешно сгенерировала рабочий код для 249 из 250 задач, причем в 240 случаях код оказался быстрее базовой реализации.
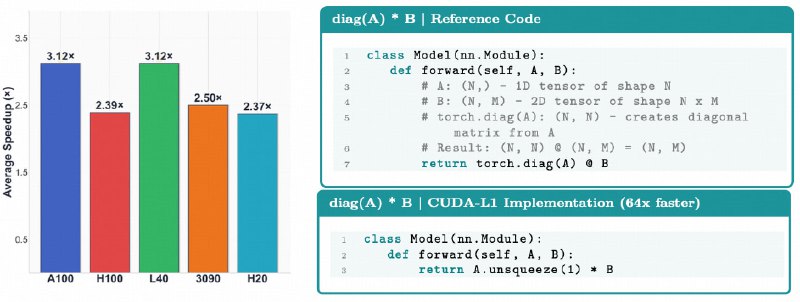
Среднее ускорение по всем задачам составило 3.12 раза, максимальное - аж 120 раз. Медианное ускорение (50-й перцентиль) составило 1.42x, а 75-й перцентиль — 2.25x.
Производительность по уровням сложности задач распределилась следующим образом: на простых операциях среднее ускорение составило 2.78x, на последовательностях операторов - 3.55x, а на сложных задачах вроде полных слоев трансформера - 2.96x.
🟡
Самое важное - это переносимость оптимизаций.Код, оптимизированный на NVIDIA A100, был протестирован на других GPU. Результаты показали, что найденные паттерны оптимизации фундаментальны и работают на разных архитектурах.
Среднее ускорение на H100 составило 2.39x (успешных ускорений 227 из 250), на L40 — 3.12x (228/248), а на потребительской RTX 3090 — 2.50x (213/242).
▶️ Пока веса и код не опубликованы, но в ожидании можно покрутить интерактивное
демо и
воспроизвести тесты из пейпера - в репозитории проекта есть
фрагменты CUDA-кода с отдельными версиями для разных GPU.
📌Лицензирование: GPL-3.0 License.
🟡
Страница проекта🟡
Arxiv🟡
Demo🖥
Github@ai_machinelearning_big_data#AI #ML #CUDA #DeepReinforce #ContrastiveRL