TGViewer
Channel Public Channel
Kotlin Adept Notes

Kotlin Adept Notes

@kotlin_adept

Канал о разработке на Kotlin и обо всем, что с ним связано
По всем вопросам и рекламе: @ajiekcx
Subscribers
2.42K
Photos
95
Videos
9
Links
155
Recent Posts 18 shown
Post #261 891
Как подружить строгий Java-энтерпрайз со всеми ИИ изменениями? Сбер поможет разобраться

24 сентября в московском офисе Сбера состоится Java Meetup — мероприятие, на котором эксперты расскажут:

✔️Что происходит в мире Java в 2026 году?
✔️В чём реальная польза (и скрытые риски) применения SDD, виртуальных потоков и Koog
✔️Обсудим, как меняется роль Java-разработчика под влиянием ИИ

Никакой теорий — только реальные кейсы от практиков!

Формат: офлайн в Москве (Кутузовский, 32) и онлайн трансляция.
Время: сбор гостей — 16:30, начало — 17:00.
Регистрация: здесь
  • ❤ 1
Post #259 1.08K
Мифы и заблуждения в AI-разработке

Забавно, как в мире AI-разработки постоянно появляются новые лучшие практики, а потом оказывается, что они неэффективны или, наоборот, приносят больше вреда, чем пользы. Приведу несколько примеров.

Эффективность

Миф: Дешевая модель сделает задачу дешевле, чем более дорогая.
Реальность: Стоимость задачи складывается из стоимости запроса и количества итераций. Поэтому более дорогая модель может сделать задачу дешевле.

Миф: Чем выше reasoning, тем лучше качество.
Реальность: Модель на более низком reasoning может показывать результаты лучше, чем на высоком.

Миф: Чем больше сабагентов работает над задачей, тем лучше.
Реальность: Увеличение декомпозиции ролей агентов приводит к ухудшению качества.

Миф: Скиллы значительно улучшают качество работы агента.
Реальность: Большинство скиллов не имеют эвалов, и если их просто сгенерировал агент, то получаем ухудшение качества.

Экономия токенов

Миф: Caveman экономит 65% токенов.
Реальность: JetBrains измерили и оказалось, что экономия составляет всего 8,5%.

Миф: RTK экономит 60–90% токенов.
Реальность: На высоком reasoning ничего не экономит, а на низком, наоборот, может увеличить стоимость.

Миф: С Ponytail агент пишет на 54% меньше кода.
Реальность: На самом деле всего на 15%.

А с какими заблуждениями в AI сталкивались вы?
  • ❤ 13
  • 👏 3
Post #258 1.18K
Тем временем мы с командой подготовили для вас новый сезон Podlodka Android Crew при поддержке RWB. И в этот раз сезон посвящён AI, куда уж без него 😈

Но мы старались подготовить не просто доклады в вакууме, а действительно практически полезные сессии, связанные с Android-разработкой, из которых вы сможете унести много полезного.

Что в программе:

🟢Узнаем, как с помощью AI эффективно решать задачи оптимизации производительности приложения, не тратя при этом огромное количество токенов.

🟢Посмотрим на разные автономные воркфлоу, которые позволяют обеспечить качество при разработке Android-приложений.

🟢Разберёмся в многообразии появляющихся AI-инструментов для Android-разработки и узнаем, что действительно работает, а что нет.

✅ Уже завтра состоится первая публичная сессия о том, как изменилась Android-разработка с приходом AI от Антона Шилова.

🗓 А сам сезон пройдёт с 21 по 25 сентября.

Так что залетайте, будет интересно. Ведь конференция Подлодки — это не только доклады, но и нетворкинг, где можно обсудить наболевшие вопросы и поучаствовать в разных активностях.

А по промокоду KotlinAdept будет скидка
  • 👍 3
  • 👎 2
Post #257 1.81K
Прошло уже более полугода с того момента, как я рассказывал вам о реализации Android-приложения для удалённого доступа. И наконец-то мой коллега Евгений Мельцайкин выступит сегодня на конференции E-CODE с докладом по теме.

Из доклада вы узнаете:

🔘Как реализовать функциональность постоянного доступа
🔘Об архитектуре решения, построенного на межпроцессном взаимодействии нескольких сервисов
🔘Как автоматически выдавать разрешение на демонстрацию экрана
🔘Как поднимать сервис после перезагрузки устройства

🗓 Доклад можно посмотреть в прямом эфире онлайн уже сегодня, 12 сентября, в 18:30 по МСК.

🔗 Подключиться к трансляции
  • 🔥 12
  • 👍 6
  • 🤝 2
  • ❤ 1
Post #255 2.46K
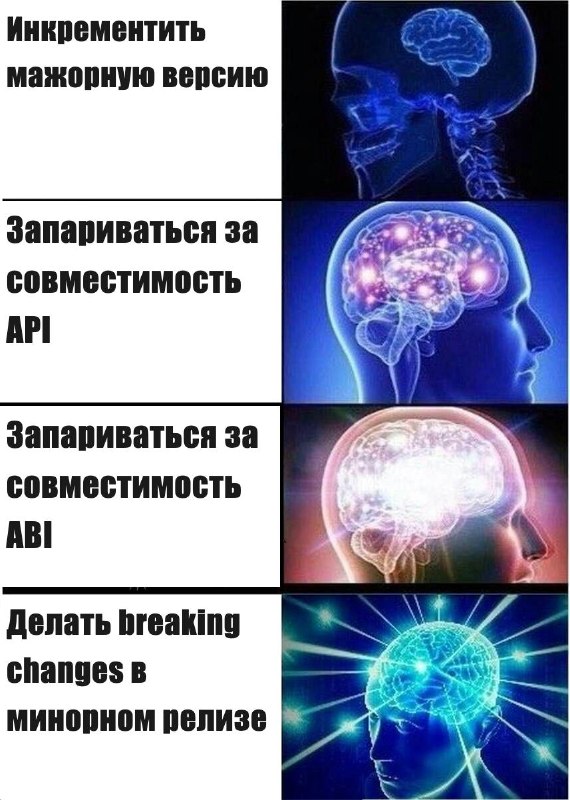
Если вы тоже городили костыли для поддержки смены системной темы внутри Compose Multiplatform-приложения, как описано в документации, то в Compose Multiplatform 1.12.0 проект на iOS просто перестанет компилироваться.

Я создал issue по теме и накидал workaround. Проголосуйте за issue, если столкнулись с такой же проблемой.

Как считаете, норм ли сносить публичное API, хоть и предназначавшееся для внутреннего использования в минорном обновлении?
  • 😁 15
  • 🤔 6
  • 🤯 5
  • 🗿 3
Post #253 2.72K
Сколько стоит отказ от OpenCV

Весь препроцессинг в сканере, о котором я рассказывал в прошлых постах, держится на OpenCV — библиотеке компьютерного зрения, написанной на C++.

Нам из неё нужно меньше десятка функций: гомография, ресайз, гауссово размытие, CLAHE, Otsu и другое. Платим за это мы, конечно, размером: библиотека добавляет к APK около 200 МБ 😱

Здесь сразу оговорюсь, что это цифра для универсального APK со всеми ABI внутри, и очевидно, что App Bundle столько не весит: на устройство прилетает один ABI из четырёх, то есть пятьдесят мегабайт. Вот только это всё ещё много, так что AAB проблему полноценно не решает.

Идея кажется очевидной: функций немного, может быть, переписать всё это на Kotlin и выкинуть зависимость целиком? Благо теперь, в мире AI, это можно сделать почти бесплатно. Как ни странно, по бенчмаркам удалось добиться почти того же качества, но вот по времени препроцессинг стал работать в 9 раз дольше на 95-м перцентиле. Кто бы мог подумать 😲

Этот вариант, очевидно, не подходит. Поэтому появилась идея собрать свою урезанную версию OpenCV, только у своей сборки есть и минусы:

🔘Обновление OpenCV перестаёт быть сменой одной цифры в зависимостях: нужно пересобрать под все ABI, прогнать сборку в CI, проверить, что ничего не отвалилось.
🔘Сложный порог входа, даже с AI-агентами можно будет прикурить после очередного апдейта NDK или AGP.
🔘Готовые обёртки OpenCV написаны и отлажены, а если мы где-то накосячим с жизненным циклом, то получим серьёзную утечку памяти в нативе.
🔘И наконец, нет гарантий, что не понадобятся ещё какие-то методы из OpenCV и потом может быть очень больно всё заново пересобирать и обновлять.

Так что остаётся либо мириться с размером, либо усложнять поддержку. А что бы выбрали вы?
  • ❤ 11
  • 👍 2
Post #252 2.52K
Как читать плохо пропечатанные коды

В прошлый раз я упомянул, что returnErrors в ZXing подготавливает почву и для других препроцессингов. Сегодня разберём ещё один пример препроцессинга для исправления плохой печати.

Речь про коды, у которых модули (те самые чёрные и белые квадратики, из которых состоит DataMatrix) напечатались с разрывами.

1️⃣ Первый шаг кажется максимально контринтуитивным: чтобы прочитать код, картинку сначала придётся намеренно испортить. Для этого накладываем гауссово размытие по вертикали, чтобы склеить разорванные модули.

2️⃣ Далее уменьшаем изображение методом INTER_AREA, то есть с усреднением по площади, до трёх пикселей на модуль. Всё, что мельче модуля (шум матрицы, зернистость бумаги), просто исчезает, а модуль в три пикселя выживает. Порядок здесь важен: размывать нужно именно до уменьшения, после него склеивать уже нечего.

3️⃣ После усреднения вместе с мусором приглушаются и полезные участки, поэтому CLAHE (Contrast Limited Adaptive Histogram Equalization) помогает вернуть контраст. Если по-простому, то картинка делится на 64 клетки, в каждой берутся самый тёмный и самый светлый пиксель, и затем яркость плавно растягивается.

4️⃣ Последний шаг — это перевод серого в чисто чёрно-белое. Алгоритм Otsu сам подбирает уровень, ниже которого всё становится чёрным, а всё, что выше — белым. И уже эта картинка скармливается снова в ZXing.

Нюанс в том, что ни ось размытия, ни нужный размер заранее неизвестны: первое зависит от того, как принтер испортил печать, а второе от расстояния съёмки. Поэтому перебирается сетка: три целевых размера кода на шесть вариантов источника — размытия по вертикали и горизонтали с тремя разными ядрами. Затем пытаемся декодировать каждый вариант.

💡 И тут снова выручает returnErrors. Если до этого код не читался вообще никак, то на некоторых комбинациях ZXing хотя бы находит символ: прочитать модули он всё ещё не может и возвращает ошибку контрольной суммы, но это уже подсказка. Она позволяет отбросить неактуальные комбинации и подбирать размер вокруг удачной, убавляя или прибавляя пиксели.

Таким образом, если повезёт подобрать нужные параметры, код получится прочитать, но стоить это может дорого. Именно поэтому в потоковом режиме сканирования такому перебору нужен жёсткий бюджет по времени, а весь препроцессинг стоит выносить в отдельный поток, иначе будут сильные просадки по FPS.
  • 🔥 18
  • ❤ 6
Post #250 2.35K
Перспективное отображение

Продолжаю заниматься сканером и хочу поделиться одним интересным инсайтом, как улучшить качество сканирования кодов маркировки.

Базовый пайплайн выглядит так:

1. Кадр с камеры уходит в детектор (tflite-модель), который находит на нём координаты потенциальных кодов.
2. По каждому боксу вырезается ROI с небольшим паддингом, переводится в grayscale и отдаётся в декодер, например, ZXing.

То есть качество сканирования напрямую зависит от качества детектора и декодера. И часто происходит так, что код сфотографирован под углом или наклеен на слегка изогнутую поверхность: детектор такой код находит без проблем, а вот декодер прочитать его уже не может.

Чтобы улучшить ситуацию, можно применить так называемое перспективное отображение или гомографию, чтобы скорректировать перспективу и получить изображение кода, как будто снятого в лоб. Чтобы это сделать, достаточно знать координаты четырёх углов кода. И тогда всё сводится к двум вызовам OpenCV: getPerspectiveTransform считает матрицу по четырём парам точек, warpPerspective применяет её к изображению.

Проблема в том, как получить эти углы. Ведь детектор ничего не знает о положении кода в пространстве и отдаёт обычный прямоугольник.

Тут помогает включить параметр returnErrors в настройках ZXing: если ему удалось распознать паттерн кода, но не удалось декодировать по каким-то причинам, он отдаст координаты всех четырёх углов, к которым мы затем можем применить гомографию и снова попытаться распознать уже неискажённое изображение.

При этом ZXing и сам умеет в перспективу, но его гомография стоит в самом конце и не выпрямляет картинку, а лишь подсказывает, куда смотреть на всё том же косом кадре. Бинаризация и подсчёт размера кода отрабатывают раньше и видят его искажённым, что приводит к неверно прочитанным модулям и ошибкам размерности.

Ещё returnErrors подготавливает почву и для других препроцессингов, например, для борьбы с плохо пропечатанными кодами.

Если тема интересна, ставьте реакции, и я постараюсь еще простым языком разобрать, как это все работает.
  • 🔥 57
  • 👍 19
Post #249 2.65K
Как сделать свой SDK для Remote Config

Если вы используете Firebase Remote Config для работы с фиче-флагами, то, возможно, для вас он станет платным, и кто-то начнёт искать альтернативу.

Мы, на самом деле, уже давно с него мигрировали на другое стороннее решение из-за высоких рисков блокировки, а теперь полностью переходим на собственный сервис. Хочется поделиться особенностями разработки такого SDK.

Начать стоит с выделения фасада с базовыми методами fetch, activate и get<Type> с Timber-подобным API. Тогда вы сможете с лёгкостью заменить одно решение другим.

При реализации собственного SDK нужно учесть несколько важных моментов.

1. Понадобятся три вида хранилища данных: персистентное для хранения актуальных значений, персистентное для хранения временных значений (после fetch и до activate) и memory cache для моментального получения актуальных значений.

2. Нужно хорошо продумать, как исключить race condition и data race. Первичную инициализацию memory cache лучше сделать блокирующей, чтобы не потерять данные. Для методов fetch и activate лучше использовать общий mutex, чтобы не допустить рассинхронизации значений.

3. Предусмотрите throttle-механизм, чтобы не перегружать ваш бэкенд. При этом заранее продумайте, как будете реализовывать force fetch, когда значения нужно обновить как можно скорее, а также фоновое обновление, если пользователь долго не выгружает приложение из памяти.

В общем, на первый взгляд кажется, что задача простая, но в ней очень много подводных камней. Так что это вполне хороший кейс для собеседования по System Design для мобильных разработчиков.
  • 👍 21
Post #248 1.98K
Новые AI модели и инструменты выходят каждую неделю, городские сумасшедшие хоронят программирование, а кто-то, обложившись сотней агентов, создает супер-успешные проекты. Как с этим жить, решительно непонятно.

Чтобы помочь с этим справиться, ребята из подкаста Подлодка запустили закрытое сообщество инженеров, которые уже активно используют AI в работе и хотят делать это системно. Вот кому туда стоит подключиться:

👉Если вы хотите просто держать руку на пульсе происходящего в индустрии

Подлодка вытаскивает очень крутых экспертов из Uber, xAI, Google, Яндекса, Cursor и других компаний. Они рассказывают, как работают их команды – и вы можете узнать у них то, о чем на конференциях начнут говорить только через год.

А в закрытом чате разбирают все важные новости и изменения подходов к разработке. Если нет времени читать – вам приходит дайджест с главными выводами.

👉Если вы хотите вкатиться в лучшие практики AI разработки

В клубе прошло уже больше 40 стримов на разные темы – от разбора фреймворков для Spec-Driven Development до того, как строить общий реестр скиллов для команды или автономные фабрики фичей.

В чате есть специализированные комнаты по самым горячим темам – например, локальные модели, или тот же самый SDD. Клубчане делятся там своими сетапами и практиками.

А еще в клубе есть бот, который может ответить на любой ваш вопрос на основе всего архива прошедших стримов и обсуждений в чате!

👉Если вы уже активно внедряете AI в свою работу или команды

Это ровно то, чем занимаются все в клубе – так что вы сможете найти единомышленников с похожими проблемами. Как работать со скептиками, как не попасть в зависимость от вендоров моделей, как не сжечь все бюджеты на токены – все эти вопросы можно обсуждать в чате и на Random Coffee.

Периодически в клубе проводят хакатоны. В мае в течение двух недель 15 команд делали свои фабрики фичей с разными архитектурами. В августе ребята стартуют новый хакатон, где будут копать в сторону самообучающихся агентов и долгосрочной памяти.

🔗Детали, расписание, заявки в клуб
  • 🥱 9
Post #247 2.56K
Страх начать сначала

Три месяца назад я пытался улучшить сканер кодов маркировки на Android, и первый подход не дал мне ровным счётом ничего, что даже загнало меня в некоторую апатию. Тогда пришлось перейти к тяжёлой артиллерии, а именно к написанию кастомного пайплайна на C++ с использованием MediaPipe. Это было то ещё приключение: весь код, разумеется, писался агентами, а я пытался понять, что там вообще происходит 🚬

В итоге мне удалось добиться определённых успехов в улучшении качества сканирования, однако работа с MediaPipe была больше похожа на ад:

🔘Как это добро дебажить
🔘Как нормально поставлять собранную либу в Kotlin-проект
🔘Как задать критерии успеха, ведь сканирование статического изображения ≠ сканированию с камеры

Я отложил эту задачу, переключился на другой проект, а теперь вернулся к ней снова. Логичным шагом было бы продолжить с того, на чём я остановился. Раньше я наверняка так бы и сделал, потому что банально было бы жалко бросать свои труды. Но сейчас сам код стал почти бесплатным, поэтому я решил начать с чистого листа.

Я запустил deep research по поиску лучшего пайплайна для сканирования, который почти съел все лимиты. В итоге я получил лютейший нейрослоп, в котором не было ровным счётом ничего полезного 😔

Но я не стал отчаиваться и решил сделать ещё один подход к реализации уже без MediaPipe, но с обновлёнными LLM. И, как ни странно, буквально за час получил полностью работающее решение, которое оказалось на голову выше всего того, что я делал раньше 😎

Разумеется, мне всё ещё далеко до коммерческих решений, но благодаря тому, что я не побоялся начать сначала, теперь я хотя бы могу всё это дебажить, итеративно улучшать и смотреть, что работает, а что нет.

Именно на таких задачах можно оценить, насколько улучшились LLM'ки за последнее время, потому что в повседневной разработке очень сложно заметить реальную разницу.
  • 🔥 35
Post #245 2.37K
Особенности безопасной реализации локального пин-кода

Когда-то давно мы реализовали локальный пин-код на основе этой библиотеки. Со временем эта реализация морально устарела, поэтому мы переписали модуль на KMP и Compose Multiplatform. Однако принципы безопасной реализации локального пин-кода остаются актуальными:

🟢В идеале вообще не использовать локальный пин-код. Но если приложение работает только в офлайн, то особого выбора нет.
🟢Пин-код не должен нигде храниться. Из него криптографически выводится ключ шифрования, например с помощью PBKDF2 (реализация есть как для Android, так и для iOS)
🟢Пин-код должен защищать реальные данные, а не просто закрывать экран. Если он лишь блокирует интерфейс, такую защиту можно обойти, подменив флаг в памяти или в хранилище. Поэтому в идеале не хранить и сам ключ: если данные удалось расшифровать, значит пин-код введён верно.
🟢Для шифрования рекомендую использовать библиотеку Tink. С ней сложнее допустить ошибку при реализации, к тому же она кроссплатформенная. Для iOS Tink напрямую использовать не получится, там проще сделать реализацию с CoreCrypto.
🟢Биометрия не должна ограничиваться простой проверкой отпечатка. Лучше использовать её для шифрования ключа, выведенного из пин-кода. Также стоит инвалидировать биометрические данные, если в системе был зарегистрирован новый отпечаток.
🟢Счётчик неудачных попыток должен быть персистентным, чтобы его нельзя было сбросить простым перезапуском приложения.

Какие проблемы могут возникнуть

🔘У шифрования есть своя цена. Например, если зашифровать пользовательскую сессию, то до ввода пин-кода приложение не сможет выполнять фоновые операции. Поэтому здесь важно соблюдать баланс и не ограничить дальнейшее развитие приложения и шифровать только критичные данные.
🔘Если пользователь забудет код, он может потерять важные данные. Поэтому мы добавили резервное слово, которое также шифруется по аналогии с пин-кодом и позволяет восстановить доступ.

🔒А в вашем приложении есть локальный пин-код?
  • ❤ 17
  • 👍 8
  • 🤔 8
Post #244 2.59K
Обманчивая легкость из-за AI

Продолжая тему захода в чужие роли с помощью AI, в комментариях справедливо отметили, что AI лишь создает иллюзию легкости. И это действительно так, особенно когда речь идет о легаси-проектах, в которых весь контекст хранится в головах разработчиков.

Мне нужно было всего лишь вынести в публичное API некоторую функциональность из Telegram-бота. При этом бэкенд был написан на Kotlin 🏝

Казалось, что это просто подарок судьбы и все можно сделать с агентом за пару часов. Но что-то пошло не так 🤔

🔴AI отлично подстраивается под проект и хорошо работает по аналогии. Но если проект состоит из большого количества легаси и в нем используется множество разных подходов, то AI просто не знает, как делать правильно. И ты тоже не знаешь 🙃
🔴API в бэкенде — это только верхушка айсберга. Пришлось разбираться с кучей технологий: как работать с очередями в RabbitMQ, как читать логи в Elastic, как устроен отдельный сервис авторизации, как делать миграции в MongoDB и другим зоопарком внутренних решений.
🔴Несмотря на один и тот же язык, подходы в бэкенде и мобильной разработке могут значительно отличаться, что тоже создает когнитивную нагрузку.

В итоге вместо пары часов мое путешествие по бэкенду затянулось на несколько недель, хотя задача была далеко не самой сложной.

При этом эта история не масштабируется: нельзя просто дать любому разработчику подписку на LLM и ожидать, что он сможет сделать что угодно в любой области.
  • 👍 44
  • 💯 3
  • 👏 2
  • 🥱 2
Post #242 2.59K
Насколько AI ускоряет TTM в большой компании

🧠 Мы запустили первое приложение, которое целиком написано с помощью AI: от прототипов и бэкенда до мобильных приложений. И хочется обсудить, насколько это реально ускорило общий TTM.

Можно услышать сотни историй о том, как вайбкодеры одновременно работают над десятком проектов и пишут по 30 тысяч строк кода в день. Это всё работает, пока ты делаешь это один. Но в большой компании, где куча команд, ещё больше микросервисов, своя инфраструктура, дизайн-система, правила безопасности и многое другое, тогда без полноценной перестройки процессов на уровне всей компании такой подход просто не получится внедрить.

Поэтому сейчас речь идёт именно о применении AI-агентов для написания кода, без глобального изменения процессов и с тем же уровнем качества кода, что и раньше.

Итак, я замерил показатели предыдущих MVP наших проектов и получил интересные цифры.

🟡Разработка действительно ускорилась, но не драматически — примерно на 50%. Всё потому, что раньше мы тратили большую часть времени на написание кода, попутно уточняя требования и валидируя результат. Теперь это время, по сути, переместилось в фазу планирования и валидации.

🟢А вот ускорение time to market получилось действительно разительным: от идеи до релиза приложения стало проходить в три раза меньше времени, чем обычно. Но, по сути, AI здесь ни при чём. Это произошло потому, что значительно сократилось количество людей в цепочке.

Разумеется, это всего лишь один пример, который проще всего было измерить. На большом масштабе цифры могут сильно отличаться.

📊 А какие цифры получаются у вас?
  • 👍 21
  • ❤ 1
Post #240 2.7K
Как сделать аналог availability check из iOS в KMP

В Swift есть специальный механизм проверки доступности API на разных версиях ОС:


if #available(iOS 17.4, *) {
newAPI()
} else {
legacyAPI()
}


Это позволяет выполнять код только на определённых версиях ОС, где нужный API гарантированно существует.

Но, к сожалению, такого механизма нет в Kotlin Native при работе над KMP-проектами. И если мы хотим реализовать данную возможность только в Kotlin-коде, то придётся искать обходное решение.

В первую очередь понадобится метод для определения версии iOS:


internal fun isIosVersionAtLeast(major: Int, minor: Int = 0, patch: Int = 0): Boolean {
val target = cValue<NSOperatingSystemVersion> {
majorVersion = major.toLong()
minorVersion = minor.toLong()
patchVersion = patch.toLong()
}
return NSProcessInfo.processInfo.isOperatingSystemAtLeastVersion(target)
}


Однако само по себе это не поможет. Приложение всё равно будет крашиться при запуске на старых версиях ОС, если во фреймворке есть символы несуществующего класса.

Поэтому придётся добавить в настройки сборки shared-фреймворка специальный флаг линковки, который будет подключать указанный системный фреймворк только в том случае, если он доступен:


it.binaries.framework {
linkerOpts.addAll(listOf("-weak_framework", "AuthenticationServices"))
}


Однако если обратиться к несуществующему классу, то приложение всё равно упадет в рантайме. Поэтому для дополнительной безопасности можно также проверять наличие класса через NSClassFromString("ClassName").
  • 👍 11
  • 😁 2
  • 🥴 2
  • ❤ 1
Post #239 2.81K
Kotlin Adept Notes Особенности работы с OAuth 2.0 в KMP Во многих мобильных приложениях аутентификация и авторизация пользователей происходят через протокол OAuth 2.0, который является индустриальным стандартом. В нём предусмотрены различные флоу авторизации, и наиболее подходящим…
✅ kmp-telegram-login

Решил реализовать пример работы с OAuth 2.0 в KMP, как и обещал, но делать просто пример в вакууме не хотелось, и я вспомнил про недавно вышедший android-telegram-login. Подумал, что было бы полезно адаптировать его под KMP.

Но что бы вы думали? Разумеется, кто-то уже навайбкодил это до меня здесь, причём всего пару дней назад 💅

В целом код из репозитория и наша реализация довольно схожи, за исключением некоторых важных моментов.

Там также используется безопасный Code Flow + PKCE, но если Telegram не установлен на устройстве, то вместо нового AuthTabIntent используется CustomTabsIntent и есть подозрение, что с https-схемой могут быть проблемы на некоторых браузерах.

⚠️ Однако в либе есть очень критичная проблема. Похоже, разработчики ещё не запускали код на устройствах с iOS ниже 17.4 или не удосужились написать, как это исправить. Если собрать KMP-фреймворк с этой библиотекой, приложение просто крашнется при запуске на старых ОС, поскольку ASWebAuthenticationSessionCallback доступен только начиная с этой версии.

Именно поэтому мы у себя в итоге отказались от использования Universal Links и оставили только кастомную схему.

На самом деле это можно исправить, и о том, как это сделать, я расскажу в следующем посте, так что stay tuned!
  • 👍 22
  • ❤ 4
Post #237 3.31K
Решили тут перейти в дизайн-системе на state-based TextField, чтобы порешать разные проблемы предыдущей версии. И, как говорится, что же могло пойти не так 😐

Какие плюсы получили:
🟢Упростилась работа с курсором — страшные хаки больше не нужны
🟢Перестали лагать быстрые изменения текста на старых устройствах
🟢VisualTransformation теперь разделился на InputTransformation и OutputTransformation, что позволяет гибче работать с изменением текста

Какие минусы:
🔘Пришлось костылить обёртку с двумя LaunchedEffect, чтобы сохранить перегрузку с предыдущим API
🔘Ну и самое бесячее: в новом TextField почему-то решили поменять отступ от клавиатуры. Теперь экран подскролливается к каретке ввода, и выглядит это как на изображении выше. А фиксится всё ужасно костыльным образом.

💬 Так что вопрос к знатокам: кто-нибудь уже сталкивался с подобной проблемой? И если да, то как её решили?
  • 😁 20
  • 🤯 3
  • ❤ 2
Post #236 3.31K
Особенности работы с OAuth 2.0 в KMP

Во многих мобильных приложениях аутентификация и авторизация пользователей происходят через протокол OAuth 2.0, который является индустриальным стандартом.

В нём предусмотрены различные флоу авторизации, и наиболее подходящим для мобильных приложений считается Authorization Code + PKCE. Этот флоу предотвращает перехват данных благодаря генерации временных параметров: codeChallenge и codeVerifier.

Я не сторонник использования сторонних неофициальных библиотек в целом, и тем более для такой критичной вещи, как аутентификация. А в мире KMP найти что-то подходящее ещё сложнее, поэтому часто приходится делать всё самому.

🤖 Android

Для Android в пакете androidx.browser появился очень удобный механизм AuthTabIntent, который берёт на себя почти всю работу, хотя и не без нюансов.

Если выбранный в системе браузер по умолчанию не поддерживает AuthTab, ничего работать не будет. А кроме Chrome и Firefox, насколько я знаю, его почти никто не поддерживает. Поэтому придётся либо явно указывать пакет браузера, либо делать fallback, если подходящего браузера нет.

🍏iOS

На iOS есть аналогичный удобный механизм ASWebAuthenticationSession. Но, как это часто бывает у Apple, не все фичи работают на старых версиях iOS. Например, редирект через https-схему (Universal Links) поддерживается только начиная с iOS 17.4, а на более ранних версиях придётся использовать кастомную схему. И в KMP это довольно сложно разграничить — приходится прибегать к чёрной магии чтобы исключать символы при загрузке фреймворка 🤨

⭐️Если тема для вас актуальна и нужен KMP-сэмпл, ставьте реакции и я постараюсь собрать полноценный пример.

#KMP #OAuth
  • 🔥 56
  • ❤ 4
  • 👎 2
  • 👍 1
Older posts →

About this channel

How can I read @kotlin_adept without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Kotlin Adept Notes: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Kotlin Adept Notes have?
Kotlin Adept Notes (@kotlin_adept) has 2.42K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Kotlin Adept Notes know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →