
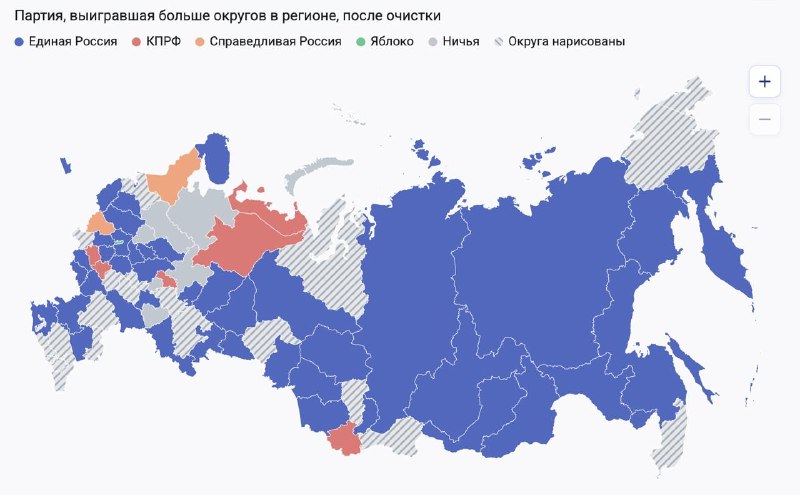
Сегодня были опубликованы интересные расчеты по фальсификациям на прошедших выборах в Госдуму, сделанные другим (не из семейства моделей Шпилькина) методом анализа. Результаты примерно те же, что и публиковались раньше, но есть пара новых наблюдений.
18+ / НАСТОЯЩИЙ МАТЕРИАЛ (ИНФОРМАЦИЯ) ПРОИЗВЕДЕН, РАСПРОСТРАНЕН И (ИЛИ) НАПРАВЛЕН ИНОСТРАННЫМ АГЕНТОМ КОМИНЫМ МИХАИЛОМ ОЛЕГОВИЧЕМ ЛИБО КАСАЕТСЯ ДЕЯТЕЛЬНОСТИ ИНОСТРАННОГО АГЕНТА КОМИНА МИХАИЛА ОЛЕГОВИЧА.
Сначала про метод — это Stochastic Frontier Analysis (SFA), с помощью которого можно построить некоторую предельную границу эффективности (frontier), отталкиваясь от определенного набора параметров на входе. Из этого описания логично следует, что метод, как правило, используется для построения моделей эффективности и анализа экономики предприятий или отраслей. Я ни разу не видел, чтобы SFA использовали для анализа уровня фальсификаций, хотя сам метод не полностью чужд нашим дисциплинам. По крайней мере, в далекие годы в ЦПУР мы использовали его для построения эконометрической оценки эффективности политики слияния вузов (технически не его, а его непараметрический аналог DEA, но через SFA была посчитана устойчивость основной модели).
В целом новый метод понадобился — и автор это хорошо объясняет в начале текста — потому что эти выборы в ГД-2026 даже грязнее, чем обычно. Стандартный метод оценки, построенный на расчете "излишней" явки, выпадающей из нормального (унимодального) распределения (Шпилькин и модификации), когда эта самая явка растет линейно с голосами за ЕР — хорошо подходит для того, чтобы выявлять ситуации реальных вбросов: когда вам в урну, сейф-пакет или просто в итоговый протокол докидывают голоса за нужную партию или кандидата. При такой процедуре на уровне УИКов (precinct-level) вместо нормальной картинки у вас и получаются "хвосты комет" или "пила Чурова" — последняя особенно видна на бинах явки.
Но это семейство методов работает хуже, когда занимаются "перекладыванием" бюллетеней, вычитая у одного кандидата/ партии, и прибавляя другому. В таком случае, явка не меняется, изменяются только доли голосов.
Автор описывает, что эта проблема в частности актуальна для Москвы, где используется электронный список избирателей: идея в том, что, в случае голосования в бумаге ты можешь расписаться за якобы выданные (а на самом деле вброшенные) бюллетени, и если человек придет уже после этого все же проголосовать, его вычеркнут, сделав вид, что произошла ошибка, но если человек заходит в таком сценарии проголосовать электронно, он увидит, что кто-то уже сделал это за него, и система его просто не пустит. Чтобы избежать такого конфуза, но все равно сделать вброс, нужна недюжинная сноровка / координация между оффлайн и онлайн комиссиями, чего добиться крайне трудно.
Но в целом, эта логика "перекладывания" возникает не только из-за электронного списка избирателей в Москве, но и всех ситуаций, когда направление фальсификаций становится нелинейным. Например, когда в этом году пытались спасти СР, прибавляя им столько голосов, чтобы они получили свои 5%, а попутно еще, — чтобы было менее заметно или еще зачем — наращивали число и у КПРФ с ЛДПР — и все это пытались делать уже после фактического объявления процента явки, стремясь попасть в тот таргет, что ЦИК уже озвучил. Во всех этих случаях крайне трудно найти исходное, условно честное (без аномалий) ядро.
SFA с такой задачей справляется немного лучше, подбирая вот этот самый фронтир (исходное наиболее нормально выглядящее распределение голосов) и по параметру смещения явки, и по результату других партий, и — что наиболее важно — разделяя наблюдаемый разброс на предполагаемые естественные различия между участками и дополнительные направленные сдвиги (читай — фальсификации). Естественно, с определенным порогом уверенности.
В общем, это довольно интересный метод оценки, который пригодится для последующих грязных российских выборов. Но у него есть два "но" (см окончание тут)
Post #183
5.06K
- ❤ 22
- 👍 10
- ❤🔥 4
- 🤬 2
- 🤣 1