Post #274
3.16K
Выиграл H-1B
- 🎉 74
- 🤡 13
- 👍 7
- 🍾 6
- 🔥 3
- ❤ 2
 KN
@knowledge_accumulator
Showing posts older than #275 · Back to latest


h_t. Compositional Regularization считается как сумма L2-расстояний между каждыми двумя соседними h_{t} и h_{t+1}.
q(z|x) и декодер p(x|z) таким образом, чтобы у нас получалось восстановить изначальный вектор x из вектора скрытых переменных z.x, который и будет этим самым вектором скрытых переменных.x наилучшим образом? Конкретный автоэнкодер решает именно эту задачу. KxN - размерность скрытого вектора на кол-во фичей. В каждой строке у нас находится обучаемый вектор "логитов" для каждой фичи, к которому мы применяем Gumbel Softmax и получаем soft one-hot вектор-маску для всех фичей, которую затем скалярно умножаем на исходный вектор фичей - получая таким образом дифференцируемую аппроксимацию выбора одной фичи из всего списка. KxN используется Indirect Parameterization - эта матрица вычисляется как функция от 3 обучаемых штук: умножения матрицы KxN на матрицу NxN и прибавления вектора размера N к каждой строке результата.K фичей из N напрямую. При этом, если качество модели совпадает с качеством изначальной модели, можно смело выкидывать из прода целых N-K фичей. 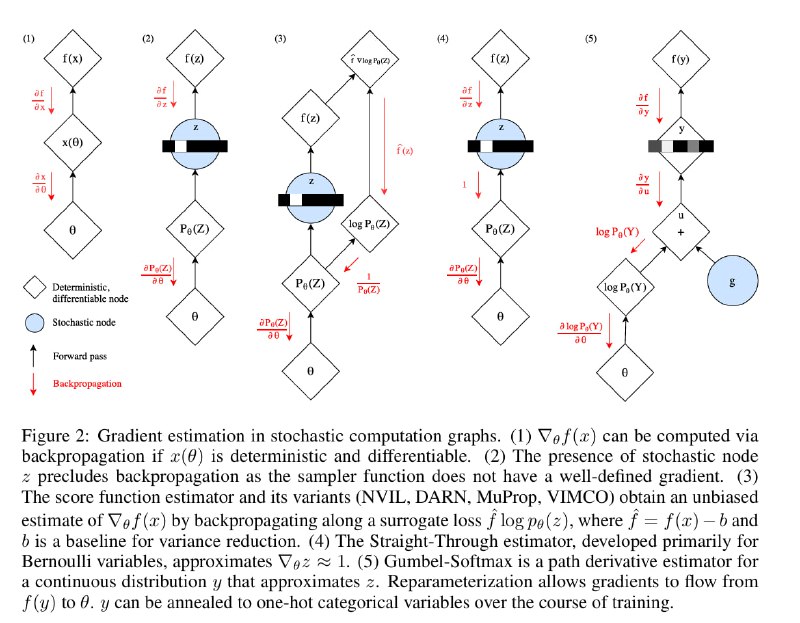
q(z|x) и p(x|z), которые выдают распределение на скрытую компоненту z по входу x и наоборот. В базовом варианте z имеет нормальное распределение N(m;d), и энкодер выдаёт параметры этого распределения - средние m и ст. отклонения d.z. Как пробросить градиент назад в модели "сквозь" это сэмплирование? В лоб сделать это не получится, и для этого применяют простой советский Reparametrization Trick.eps из N(0;1), а затем умножаем его на d и прибавляем m. По факту результат тот же самый, но он превращает нейросеть в цепочку детерминированных операций и позволяет пробрасывать градиент бэкпропом. logits -> probs -> one-hot vector -> embedding. При переходе из probs к one-hot vector как раз и возникает сэмплирование из категориального распределения, сквозь которое нельзя пробросить градиент напрямую.probs прибавить вектор из распределения Гумбеля (аналог N(0;1) в данном случае), то argmax итогового вектора будет распределён так же, как и исходное распределение.[0.2;0.8], эта операция будет выдавать [0.001; 0.999] в 80% случаев и [0.999;0.001] в 20 процентах случаев.[0.2;0.8] в дальнейших операциях, если там всё равно не требуется строгий one-hot вектор? [1; 0], а градиент пробрасывать так, как будто там был [0.999; 0.001]. Но я никогда не встречал применения такой схемы.Needs Some Work, что второй с конца из пяти.OK. Good, а спустя полгода прошли оба штрафа за новые карты и мне наконец-то дали Excellent.

P(objective | params)P(objective | params), но интеграл берётся только по "хорошим" значениям objective - это называется Expected ImprovementP(objective | params) мы формулу Байеса и переходим к моделированию P(params | objective), которое в свою очередь является композицией из двух распределений P(params) - для "хороших" значений objective и для "плохих" - эти распределения называется`L(params) и `G(params).. Эти точки мы пытаемся найти, сэмплируя много раз из `L(params) и пересчитывая это соотношение. Вся эта схема называется Tree-structured Parzen Estimator.
Theha_i = Theta + Sigma * Noise_iR_iGrad равна сумме по всем R_i * Noise_i / (N * Sigma)Theta_new = Theta + Alpha * Grad
x1 = x.cos() \n x2 = x1.cos() и замените на x2 = x.cos().cos(). Можно фьюзить нормализации с соседними операциями, применять автоматические фьюзеры/компиляторы, ну, а если вы псих, то можно написать свой CUDA kernel на Triton (сам не пробовал).r/tsa представитель самой обрыганской профессии на свете опубликовал жалобный пост о том, что люди до сих пор приводят статистику 10 летней давности, но сейчас-то технологии скакнули! Верим.
Самое большое ускорение для nanoGPT (около 25%) - это увеличение размера словаря с 50257 до 50304 - числа, кратного 64