TGViewer
Channel Public Channel
Kantor.AI

Kantor.AI

@kantor_ai

Там, где люди учились AI, я преподавал.

С 18 лет читаю лекции по AI: МФТИ, ВШЭ, МГУ, Coursera, Сколково. Строю AI/ML-команды в компаниях. Пишу про ИИ без хайпа, образование, карьеру и преподавание изнутри.

Менеджер: @mariekap

РКН: 5140322136
Subscribers
12.2K
Photos
280
Videos
19
Links
310

Showing posts older than #811 · Back to latest

Older Posts 20 shown
Post #810 3.84K
Мне обычно интереснее доклады, где показывают не отдельный удачный эксперимент, а весь путь модели: как её обучали, почему выбрали именно такой подход и что пришлось исправлять по дороге.

На Practical ML Conf в этом смысле есть два любопытных кейноута.

Николай Смолянский, который сейчас работает над world models для Physical AI, сравнит этот подход с VLA/LLM, обученными через имитацию поведения. Расскажет, почему реактивные политики ломаются при изменении среды, как world model позволяет перепланировать действия, и покажет реализацию Dreamer/RSSM, которую можно обучить на обычном ноутбуке.

Александр Боймель разберёт полный цикл обучения Alice AI LLM: от претрейна, где модель получает базовые знания и способности, до алайнмента, превращающего их в полезное поведение в продуктах.

Конференция пройдёт 19 сентября в Москве и онлайн. Здесь программа и регистрация.

Реклама. ООО "ЯНДЕКС". ИНН: 7736207543. Erid: 2VtzqwGxY27
Practical ML Conf 2026 Хардовая конференция для экспертов и практиков. Здесь будет всё о практическом применении ML: технические доклады ведущих специалистов отрасли, инженерные мастер-классы и много нетворкинга. Обсудим, как извлечь из машинного обучения реальную пользу для бизнеса.
  • 👍 9
  • 🔥 4
  • ❤ 3
Post #809 3.12K
Про боль простого и понятного изложения сложного материала

У меня, к сожалению, пока нет возможности сказать "мои курсы для души, а не для знаний", потому что мы, увы, учим всякому там машинлернингу и сопутствующей математике и программированию (хотя одна идея развлекательного курса у меня уже есть, может хоть там вздохну спокойно :). В частности, столкнувшись с тем, что успешно пройдя собес по ML после обучения у нас, слушатель может зарубиться на алгоритмической секции, мы решили добавить немного контента про алгоритмы и структуры данных во введение.

Тут можно смело сказать: "Что за наивность, несколько лекций для алгосекции?". Но на самом деле пройти алгосекцию не на Software Engineer это все же не медаль на ACM взять, и что-то с этим сделать можно.

Как решил поступить я: в модуле с пререквизитами к ML рассказываем несколько базовых тем (бинпоиск, сортировки, несложные жадные алгоритмы, динамическое программирование в простых кейсах, простые структуры данных), объясняем, зачем вообще этот сыр-бор, и накидываем ссылок на задачки с литкода. Во всех случаях объясняем, где это используется в работе с данными и когда выстреливает. А дальше, пока слушатель изучает ML, ему ничто не мешает решать в неделю хотя бы по несколько задачек на литкоде. После этого есть надежда, что на джунском или миддловом собесе на DS уж односвязный список человек развернет или бинпоиск напишет, не налажав в граничных условиях.

Так вот, вычитывал и правил сегодня утром составленные LLMкой конспекты про уроку, где рассказывается про работу массива переменной длины (который list в питоне или vector в плюсах) и вижу опасное утверждение, что время добавления нового элемента в конец в среднем О(1). Чем опасное? Ой, в бытовом смысле ничего страшного в нем нет, тем более в целом это нормальное утверждение, особенно если вы не изучали алгоритмы серьезно. А вот если изучали, вы знаете, что есть время работы в среднем и время работы амортизационно, для работы в среднем надо обсуждать какой-то случайный вход, а амортизационно считается усреднением по большому количеству операций и часто оценивается с помощью всяких неочевидных для неподготовленного слушателя подходов вроде банковского метода или метода потенциалов.

Я естественно в холодном поту бегу проверять, что там было у преподавателя в лекции: сейчас научим слушателя путать "в среднем" и "амортизационно" и его завалят на собесе. А добавлять еще приличное количество нетривиального материала, чтобы четко и понятно объяснить новичку разницу прям совсем не хочется, тем более до модуля по теорверу. К счастью, оказывается, что в лекции действительно рассказано про амортизационную оценку, так она и называется, и в целом можно сильно не переживать, только аккуратненько поправить в конспекте.

Но сама проблема, как составляя понятный курс для слушателя, не посвятившего Computer Science лучшие годы жизни, не ввести его в заблуждение и не подставить так на собеседовании или в работе - очень реальная и с ней приходится работать постоянно. И, кстати, по этой причине LLMки хоть и ускоряют подготовку материалов для курсов (тех же конспектов, например), но требуют очень тщательной проверки преподавателями.

Таких тревожных моментов как я описал выше у меня при подготовке любого курса в MLinside, на Физтехе и в Вышке десятки. Так что всем, кто думает, что преподавание это очень классно, приятно и вдохновляюще, вынужден сказать, что это еще и про постоянный страх подвести своего слушателя и борьбу с этим страхом с помощью перепроверок и исправления ошибок.
  • ❤ 17
  • 👍 11
  • 💯 6
  • 🤔 1
Post #808 3.17K
Кто что-то слышал про скандал вокруг лекций Ани Виленской, в её недавнем интервью в итоге поставлена жирная точка в нем. Самое классное, что Анна сделала все не по методичке, а как ей велело сердце - не пропала с радаров на две недели как ей все советовали, а пошла и нормально все прокомментировала и объяснила, еще и успешно, т.к. ажиотаж начал спадать. Хотя может быть как раз пришло время, когда всем стало пофиг, но в любом случае совпадение или нет - финал удачный.

Для тех, кто пропустил: в Страдариуме вышел курс Анны про средневековую музыку, опытные музыковеды нашли в нем ошибки, о чем публично написали, а Аня публично признала их и предложила нашедшим самим записать исправления (что в целом неплохо с точки зрения поделиться славой с глубокими экспертами).

Но в итоге разверзлась преисподняя: предложение было воспринято не как возможность тоже посветить фейсом, а возможно и стать соавтором и уже получить не только пиар, а как оскорбительный и унижающий достоинство ученого призыв поработать бесплатно на Анин бренд и финансовое благополучие. В итоге из-за старой как мир дилеммы людей в академических кругах - кто первый должен заговорить про то сколько платят за работу (и эмоциональной реакции на любые неустраивающие предложения) - начались метания говн, делание мемов и прочий угар в соцсетях.

Додумывали все направо и налево, обвиняли и Анну в том, что не имеет права брать денег за свои лекции, и тех, кто её хейтит, в том, что не понимают, что её лекции это edutainment и про удовольствие, а не про сделать слушателя ученым-музыковедом. В общем обсуждение курса по средневековой музыке и соревнование, кто веселее додумает сказанное и сильнее оскорбится, ненадолго затмило в соцсетях войны, политику и стихийные бедствия.

С одной стороны, круто, что Анна сама все пояснила и разрулила. С другой стороны даже жалко, что это закончилось: этот срачик был по-своему очень милым ❤️
  • ❤ 22
  • 🤔 10
  • 😁 5
Post #807 3.46K
Демо с ИИ-агентами почти всегда выглядит круто, а на практике все упирается в границы ответственности и безопасности.

ИИ-агент — это не только LLM. Это еще и инфраструктура вокруг: где он запускается, какие инструменты ему доступны, как логируются действия.

У Cloud.ru сейчас вышел Agents Space — пространство, где вся инфраструктура уже готова, а вам остается только запустить ИИ-агента. Задачи ставятся в чате, туда же можно загружать файлы и подключать сервисы.

Что мне кажется важным в Agents Space:
— есть коннекторы к почте, календарю и другим сервисам
— необратимые операции можно поставить на явное подтверждение
— можно настроить необходимость подтверждения действий вами
— доступы остаются под контролем пользователя и могут быть отключены

Последние пункты, на мой взгляд, особенно важны. Вопрос с агентами не в том, могут ли они иногда ошибаться. Конечно, могут. Вопрос в том, насколько дешево эти ошибки обнаруживать и насколько они обратимы.

Мне кажется, это хороший пример того, куда будет двигаться массовое использование ИИ. Не обязательно всем становиться разработчиками кастомных ИИ-агентов. Но подключить готового агента и работать с ними безопасно — придется почти всем.
Посмотреть Agents Space можно здесь.
  • ❤ 5
  • 👍 5
  • 🔥 1
  • 😁 1
Post #806 3.23K
Напоминаю, как понять, что человек не шарит в нашей теме: если утверждает, что он эксперт, но спрашивает «у вас тут ML или AI?» или как-то еще их противопоставляет, значит вызывайте ему санитаров. 🚑

То же самое «это ML или DS?».

Различия между этими областями есть, но в 100% случаев тот, кто задает такие вопросы, их не понимает.
  • 💯 31
  • 😁 5
  • ❤ 2
  • 👍 1
Post #805 3.31K
Кстати, если хотите промокод на скидку на Базу ML, приходите на вебинар Саши Дубейковского в этот четверг 3 сентября в 19:00 по Москве.

Вебинар бесплатный, регистрация по ссылке

Расскажет Саша про то, как профессия ML инженера уже изменилась и продолжает меняться под влиянием LLMок, так что будет интересно 🥰
  • 🫡 5
  • ❤ 4
  • 🤯 1
Post #804 2.92K
Всех с первым сентября!

Только что провел первую пару по ML у студентов в этом семестре. За 16 лет преподавания еще ни разу начало моего курса не выпадало на 1 сентября, вот сегодня впервые. Состояние после пары неприлично радостное, причем без каких-то рациональных причин. Ну только может потому что тема интересная, приятно было самому вспомнить - введение в reinforcement learning. Да и аудитория сильная, физтехи, так что можно было практически сразу формулами разговаривать, не всегда есть такая привилегия. И вопросы по делу задавали. В общем ладно, есть причины для хорошего настроения :)))

Кстати у нас в MLinside тоже начало учебного года - стартует поток курса База ML. Так что если вы уже не студент, а поучиться ML тоже не прочь - приходите ❤️
mlinside.ru Курс "База ML" Курс по основам машинного обучения для подготовки к ML-секции собеседования
  • ❤ 13
  • 🔥 9
  • 🤯 2
Post #803 3.49K
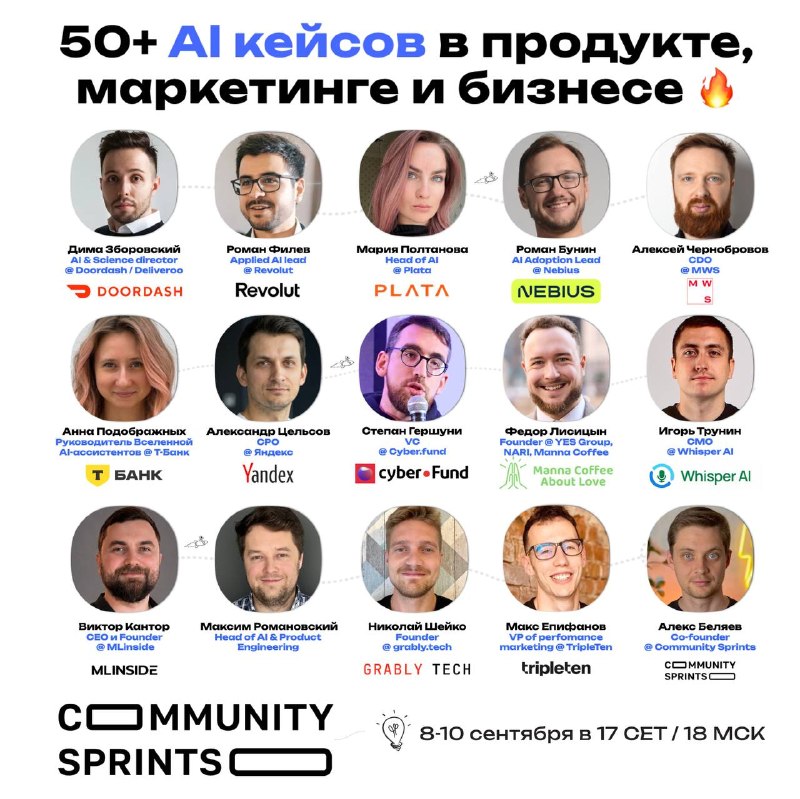
Большая конференция про AI-юзкейсы и AI-скиллы из Revolut, Yandex, Doordash, Nebius, Т-банк и других ⚡️

8-10 сентября будет очередная конфа про AI-юзкейсы от Community Sprints, на которой я тоже буду выступать :) Сходить на конференцию рекомендую всем, кто хочет оставаться на острие возможностей AI в личной продуктивности и эффективности команд ❤️

Своим опытом использования AI в работе и бизнесе поделятся продакты, маркетологи и инженеры из: 

• Plata
• Т-банк
Nebius
• Yandex
• Revolut
• DoorDash
• Whisper AI
• И других команд

Только реальные юзкейсы внедрения AI в работы компаний и команд. 0 теории ⚡

Отличная возможность перенять опыт у лучших и не повторять их ошибок 😁

Большая AI-конференция пройдет 8-10 сентября со стартом в 17:00 СET / 18:00 МСК

Всё бесплатно и без необходимости регистрироваться на кучу TG-каналов

🔥 РЕГИСТРАЦИЯ и подробное расписание выступлений на сайте Community Sprints 🔥
  • ❤ 10
Post #802 3.18K
А теперь авторский ответ на два опроса выше. Про Карпов Курсы или Синергия вопрос очень простой - Синергия сейчас топ-1 российская образовательная компания по выручке (16+ млрд рублей выручки за 2025 год). И все фифифи и фуфуфу от уважаемых профессионалов конечно могут иметь свои основания, но с денежной точки зрения это очень заметный в общем объеме рынка бизнес.

С ProductDo и УИИ вопрос чуть более сложный. Если мы пойдем на сайт УИИ, найдем название их юрлица (например в политике обработки данных в подвале сайта) и выясним, что это ООО "Терра Эйай", то беглое изучение на том же rusprofile.ru приведет к замечательному открытию. За последние 4 года эта организация заработала без малого миллиард рублей выручки. В два года из четырех при этом превысив 300 млн рублей в год (см. скриншот в аттаче).

Можно отдельно дискутировать про прибыль (которая может быть небольшой по разным причинам), и это содержательная дискуссия, однако давайте попробуем понять, что мы знаем про ProductDo. Листаем их сайт до подвала и видим, что имеем дело с ИП. Тут можно смело заявить, что вряд ли кто-то гоняет сотни миллионов выручки через ИП, и, кстати, ошибиться. Законом не запрещено, выручка только ограничивает применяемый режим налогообложения. Поэтому ситуация из разряда верю/не верю, что при сопоставимой выручке с УИИ ребята оставались бы в формате ИП.

Почему все не так однозначно, легко догадаться: идем в состав учредителей УИИ и видим... что 100% принадлежит одному физлицу. Т.е. довод про важность зафиксировать юридически доли в юрлице с большими денежными потоками внезапно ломается. Так что все, что нам остается, это легкий флер того, что одна компания - это ООО с выручкой 100-300 млн год от года, а другая - ИП. Значит ли это, что через первую не гоняют выручку по принципу "продам рубль за девяносто копеек", а на второй нет миллиардного оборота? Строго говоря нет, но матожидание плюс-минус понятное.

В итоге мой вердикт - если Джин придет, берите УИИ. А лучше Синергию.
  • ❤ 12
  • ❤‍🔥 1
Post #799 3.44K
Что лучше и что круче - самый манипулятивный вопрос на свете. Где-то после первых 5 лет своей карьеры я уже любил спрашивать коллег (тогда в Яндексе) нет, не какой стул они выберут (это у всех спрашивали на собеседовании), а где они хотели бы быть топ-менеджером - в Яндексе или в IBM.

Разумеется, все молодые ребята отвечали, что в Яндексе, потому что круто, модно и молодежно, а IBM вообще не хот. Единицы, которые умели прикинуть различие в компенсационных пакетах, предпочитали IBM, несмотря на все потенциалы роста и падения. 0% осуждения тех, для кого деньги не главное. Нюанс здесь в том, что быть модным/уважаемым/востребованным конкретному человеку обычно настолько важно, что он даже не задумывается, что в этот момент отказывается от других благ (денег, например).

К чему я всё это. К вам пришел Джин и говорит, что может сделать вас владельцем одной из двух школ: ProductDo или незабвенного, неподражаемого, меметичного, легендарного Университета Искусственного Интеллекта. Что вы выберете? 🪑
  • 😁 9
  • 🔥 4
Post #798 3.39K
Когда мы с коллегами выпустили на Coursera специализацию «Машинное обучение и анализ данных», наши ожидания были, что после курсов на курсере получится устроиться на среднюю вакансию, но явно не получится в условный Яндекс. Конкурировать со свежими выпускниками МФТИ, ВШЭ, МГУ, ИТМО, СПбГУ и других приличных вузов после онлайн курса на курсере - ну такое. Каково же было наше удивление, когда первый наш выпускник устроился в Яндекс.

В итоге перезапустив специализацию и запустив базовый курс ML уже от MLinside ответственно заявляю: после нас МОЖНО пройти собеседование в Яндекс. Но дьявол, как говорится, в деталях. Сейчас у меня есть выпускник Базы ML (кстати мы набираем группу, новый поток стартует с сентября), который успешно прошел собеседование по ML в Яндекс, но также успешно завалился на собесе по алгоритмам (им мы пока не учим). Товарищи работодатели, кому подкинуть резюме? :)
  • 🔥 23
  • ❤ 8
  • 👍 5
  • 😁 3
Post #797 3.73K
Меня тут нейросетка прожарила еще и за мои же деньги 😂

"Уже вижу важную вещь: страница в целом выглядит не как «инфоцыганский лендинг», а скорее как школа с сильной экспертизой, но текст местами заметно слабее самих преподавателей."

Кто там жаловался, что LLMки со всем соглашаются? 🤨
  • 😁 68
  • 😱 7
  • 👍 3
  • 🥰 2
  • 🍾 1
Post #796 4.68K
Сбер открыл доступ к новому поколению моделей GigaEmbeddings
 
Линейка включает три модели разного размера: 480M, 3B и 10B-A1.8B. Они переводят тексты в числовые векторы для семантического поиска, построения RAG-систем (Retrieval-Augmented Generation), классификации и кластеризации.
 
Команда разработки изменила архитектуру модели, чтобы упростить интеграцию со стандартными открытыми инструментами. На vLLM GigaEmbeddings 3B работает в 1,6 раза быстрее предыдущей версии, а 10B-A1.8B — в 2 раза.
 
Объём данных для обучения увеличился в несколько раз. В частности, за счёт открытых датасетов Nemotron, F2LLM и KALM.
 
На всех этапах применяли мержинг экспертов для сохранения языкового баланса. Самую компактную модель обучали с помощью дистилляции: она усваивала ответы более крупных и точных моделей.
 
По результатам тестов 10B-A1.8B заняла первое место в рейтинге ruMTEB. У модели 3B качество обработки кода выросло на 14,5 пункта. При этом самая компактная модель 480M стала лучшей на русском языке среди решений до 500 млн параметров.
 
Ищите веса под лицензией MIT на GitVerse и HuggingFace.
Модели бесплатно доступны разработчикам и бизнесу под открытой MIT-лицензией:

HF: 480M | 3B | 10B-A1.8B
Gitverse: 480M | 3B | 10B-A1.8B
 
Подробности читайте в посте команды ↖️
  • 👍 14
  • 🔥 5
  • ❤ 4
  • 😁 2
Post #795 4.61K
У нас на YouTube канале вышло интервью с Кириллом Малковым.

Кирилл построил хорошую карьеру в Data Science, которой и мне есть где позавидовать: Chief Data Scientist'ом в одной из крупнейших российских компаний я к 21 году не был, но вот, оказывается, так тоже можно.

Но лично мне интереснее всего было проинтервьюировать Кирилла потому что он еще и записал модуль по Deep Learning для нашей специализации по машинному обучению в MLinside (которая кстати, для студентов ВУЗов доступна бесплатно). В интервью поговорили в том числе и о том, как и главное зачем готовился модуль по DL во времена, когда курсов вокруг вагон и маленькая тележка, а рук все равно не хватает.

В общем, всем приятного просмотра первой части интервью, а мы пока готовим к выпуску часть 2.
YouTube Бизнес может жить без машинного обучения | Подкаст Кирилл Малков часть 1 Кирилл Малков — Chief Data Scientist в Россельхозбанке. За карьеру работал в Сбере, Билайне, Росбанке и МТС, прошёл путь от Data Scientist до руководителя крупных Data Science-команд и директора по монетизации данных. Входил в лонг-лист Forbes «30 до 30».…
  • 🔥 15
  • 👍 4
Post #794 4.82K
Что будет на deep tech night Яндекса

5 сентября Яндекс проводит deep tech night - конференцию о технологических вызовах в эпоху AI.

Лично мне нравится сама постановка темы мероприятия: AI здесь рассматривают не как еще одну технологию, которую надо куда-нибудь внедрить, а как причину пересмотреть архитектуру, инфраструктуру, разработку и инженерные процессы.

Это сейчас гораздо интереснее очередного обсуждения возможностей LLM. Мы уже довольно хорошо понимаем, что модели умеют писать код, работать с данными и вызывать инструменты. Следующий вопрос - что происходит с IT-системами и инженерными командами, когда все это начинает использоваться в проде и масштабироваться.

Я бы обратил внимание на несколько докладов. Мо Гавдат, ex-Chief Business Officer Google X, будет говорить о том, что последует за первым поколением AI-систем и как будут меняться инженерные команды. Алексей Гусаков, CTO Бизнес-группы Поисковых сервисов и ИИ, разберет переход от классического ML к генеративным моделям в рекомендательных системах. Василий Ершов, руководитель AI Studio Tech Yandex Cloud расскажет про облако в эпоху ИИ: архитектура платформы для гибридных агентов.

Особенно интересен этот разброс по уровням стека: когда меняется базовая технология, эффект редко остается только на одном уровне, меняется железо и инференс, способы разработки, архитектура продуктов и в конечном итоге сами роли инженеров. Именно за этой цепочкой я бы и следил на конференции.

deep tech night пройдет онлайн. Для зарегистрированных участников будет трансляция докладов, возможность задавать вопросы экспертам в Q&A и запись после события. По офлайну — все подробности на сайте.

Регистрируемся на трансляцию.
  • ❤ 12
  • 👍 6
  • 🔥 4
  • 👏 1
Post #793 4.03K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 😁 19
  • 🔥 2
  • 🤯 1
Post #792 3.99K
Наткнулся у одного блогера про найм, HR и карьерный успех, на утверждение, что зарплата 300+ сейчас только у 3% населения страны. В целом по стране выглядит даже завышено. Я не знаю, кем надо работать в регионе (не городе миллионнике), чтобы зарабатывать 300+. Но девушке в комментах разумеется накидывают предъяв про базовый минимум, и что все его уже достигли. У нас с вами выборка смещенная, но все же ради интереса сделаем свой замер в опросе выше
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →