TGViewer
Channel Public Channel
Java: fill the gaps

Java: fill the gaps

@java_fillthegaps

Привет! Меня зовут Диана, и я занимаюсь разработкой с 2013. Здесь пишу просто и понятно про джава бэк

🔥Тот самый курс по многопочке🔥
https://fillthegaps.ru/mt

Комплименты, вопросы, предложения: @utki_letyat
Subscribers
12.3K
Photos
7
Videos
0
Links
217

Showing posts older than #542 · Back to latest

Older Posts 20 shown
Post #541 16.1K
Как вредит ChatGPT

ChatGPT всё глубже проникает в жизнь, но не всегда улучшает её в лучшую сторону. За последние полгода появились две неприятные тендеции, которые больно бьют по начинающим разработчикам.

Нейросети — прекрасный инструмент, и в работе с ним есть два важных этапа:
👆 задать вопрос
✌️ провалидировать ответ

Второй пункт очень важен. ЧатЖПТ и другие нейросетки — не гигантская сеть знаний. Это искусственная модель, которая пытается угадать ответ, а задача пользователя — провалидировать его. Но бывает, что этап валидации пропускается, и мы получаем

Следствие 1: низкий уровень знаний после курсов

Иногда ученики курсов ленятся разбираться в непонятном. Тогда они спрашивают ответ у нейросети и сдают его на проверку.

Пользы от такого "обучения" нет. Лучше ошибиться и разобрать ошибку с преподавателем, чем получить формальный зачёт и забить не возможный пробел.

На курсе многопоточки я не принимала ответы нейросети и подробно разбирала затык ученика. Но не все преподаватели так же заботятся об усвоении знаний, ведь с виду ответы выглядят отлично.

Так что скоро увидим больше выпускников курсов с формальным дипломом и поверхностными знаниями. Ситуация на рынке джунов и так печальная, а станет ещё хуже😔

✍️ Что делать:

Не используйте нейросети для обучения. Если что-то непонятно — спросите преподавателя, поищите статьи на хабре/baeldung, почитайте документацию.

Особенно это касается практики. Во многих вещах надо "набить руку", и в процессе работы всплывают все непонятные моменты. А готовый ответ выветрится из головы через секунду.

Следствие 2: низкое качество контента в "Java" каналах

Вы точно видели такие каналы — посты с рандомными фактами и обильная реклама курсов. Раньше в основе контента был копипаст из устаревших статей, переводы и куски из документации. Не очень интересно, но кому-то норм.

Сейчас чаще появляются посты, сделанные при участии ChatGPT. Качество контента не выросло, но теперь в постах проскальзывают ошибки.

Парочка примеров:

🤔 Пост о StringBuffer и противоречивые абзацы насчёт потокобезопасности:
Класс является потокобезопасным, т. е. может использоваться в многопоточных приложениях.
Методы StringBuffer не синхронизированы, поэтому для многопоточного доступа нужно вручную синхронизировать доступ с помощью synchronized блока.


🤔 Пост о методе compareAndSwap():
Такого метода в атомиках вообще нет. В описании снова находим противоречие — метод возвращает то ли результат операции, то ли текущее значение переменной.

Хорошо, если в комментариях найдётся молодец, который укажет на ошибку. Но комментарии читают не всегда, а админам безразлично, что публиковать. Создавать контент с ChatGPT быстро и дешево, в будущем его будет больше.

При использовании нейросети человек отдаёт себе отчёт, что это нейросеть, и может засомневаться в ответе. А посты в "Java" канале реже подвергаются сомнению.

✍️ Что делать:

Отписаться от таких каналов. В интернете петабайты материалов для новичков, в которых точно нет ошибок. Даже устаревший текст лучше неверной информации.

И конечно, читать каналы разработчиков, которые пишут авторский контент и делятся опытом. Люди тоже ошибаются, но качество таких постов гораздо выше. Не забывайте про лайки и обратную связь, это правда очень мотивирует писать дальше🥰
  • 👍 382
  • 🔥 99
  • ❤ 78
  • 👎 5
Post #540 15.4K
С новым годом!

Любимые подписчики, пусть в следующем году выгорят только бенгальские огни, а работа принесёт море удовольствия и денег. Пусть жизнь за пределами работы вас вдохновляет и наполняет❤️

Я к концу года очень устала, и на канал не осталось сил. Но отдых творит чудеса, поэтому скоро вернусь в строй. Вы тоже отдохните как следует, вы это заслужили!

С наступающим новым годом!🎄
  • 🎄 256
  • ❤ 107
  • 🔥 32
  • 👍 7
Post #539 19.7K
8 ошибок начинающих разработчиков

Рассмотрим типичную историю начинающего разработчика👶

Чтобы стать программистом, он долго учился. Прошёл много курсов, писал учебные проекты. У них маленькая кодовая база, один пользователь, а главная задача — отработать алгоритм или попробовать фреймворк.

В этих условиях у стажёра сформировался стиль написания кода.

После собеседования стажёр начинает работать в крупном проекте вместе с другими разработчиками. И здесь очень важно перестроиться: многие паттерны, нормальные в учебных проектах, уже не подходят.

В этом посте опишу 8 таких паттернов на простых примерах.

1️⃣ Процедурный стиль

Задача: получить список заказов пользователя. Новичок скорее всего напишет такой код:
List list = new ArrayList();
process(user, list);


Во входной параметр list потом запишется результат. Такой стиль часто идёт из учебных заданий по алгоритмам, где экономится каждый бит и максимально сокращается количество объектов.

В системах со сложной бизнес-логикой такой подход усложняет чтение, тестирование и возможную параллелизацию.

Как лучше: использовать выходные параметры, не менять входные данные, давать осмысленные имена методам:
List orders = getOrders(user);


2️⃣ Сложные универсальные методы

Задача: по-разному считать скидку для новых пользователей и пользователей с картами лояльности.

Новички часто используют принцип Don't Repeat Yourself на максималках и пишут универсальный метод с кучей параметров и десятком if внутри:
getDiscount(user, true, true, limit, true)


Как лучше: сфокусированные методы для разных ситуаций
getDiscountNew(user);
getDiscountLoyal(user, limit)


3️⃣ Длинные методы

Сложно читать и тестировать, страшно менять.

4️⃣ Любовь к статическим методам

Как лучше: небольшие методы, связанные с конкретным классом. Связность ниже, ошибок меньше.

5️⃣ Сложное проектирование

Задача: завести три типа пользователей: новые, обычные и VIP. Новички скорее всего сделают интерфейс, 3 класса и статический класс с фабричными методами и билдером.

Как лучше: как можно проще. Например, один класс пользователя с полем Тип. Усложнять при реальной необходимости

PS Все "как лучше" не всегда лучше. Но думаю, идея понятна.

6️⃣ Нулевое или минимальное покрытие тестами

как следствие больших сложных методов и недостаточной инкапсуляции.

7️⃣ Низкий уровень ответственности

Пункт не относится к разработке, но очень актуален для начинающих. Проявляется в двух формах:

🔸 Непонятно, что происходит. Человек сидит и молчит до последнего, пока не спросишь статус задачи или про возможные трудности. Он умалчивает проблемы или переносит на других:

— Что с задачей, которую я тебе дала 3 дня назад?
— Я не понял, куда смотреть, потом меня HR позвал бумаги подписывать, потом я настраивал гит, увидел другую задачу и переключился на неё.


🔸 Код не решает проблему, а заметает симптомы:

— Приходил пустой параметр, и я выставил дефолтный. Тесты мешали сделать пул-реквест, и я их отключил.

8️⃣ Слабые коммуникативные навыки

— Как ты починил баг с расчётом ставки?
— Там через геттер фабричный метод нашёл, и потом докер с постгрёй поднял посмотреть, в логах был фильтр урезанный, я письмо отправил тебе в цц, но вроде скоуп не тот или тот, короче, запушил
— В чём была ошибка?
— Там два двоеточия вылезло
— Где?
— В дебаге
— 🤯


Эти ошибки ожидаемы в начале работы, я тоже их совершала🙂 Чем быстрее вы перестроитесь на командный стиль разработки, тем вероятнее пройдёте испытательный срок и быстрее вольётесь в проект.
  • 🔥 122
  • 👍 73
  • ❤ 28
  • 👎 11
Post #538 14K
Postgres и Kafka, часть 2

В прошлом посте обсуждали, как атомарно записать данные в базу и отправить сообщение в Kafka. Чтобы на случай проблем с сетью компоненты не противоречили друг другу.

Сложность в том, что это БД и месседж брокер — разные сервисы и обеспечить их атомарную работу сложно. Есть 3 подхода к решению проблемы:
1️⃣ Убираем кафку
2️⃣ Убираем БД
3️⃣ Добавляем координатор

Первый пункт уже рассмотрели, в этом посте обсудим варианты 2 и 3.

Вариант 2: убираем БД

При сохранении сущности не делаем сразу запись в базу, только отправляем событие:
public void saveOrder(…) {
kafkaTemplate.send("orders", new OrderCreated(…));
}

Сервис прекращает быть "главным" и становится обычным потребителем событий. Получает сообщение — делает запись в БД. Другие сервисы тоже получают сообщение и что-то делают.

В случае проблем с сетью стратегия сервиса такая:
1️⃣ Отправь сообщение, пока не получится
2️⃣ Получив сообщение, пиши в БД, пока не получится

Вместо координации двух компонентов мы добиваемся исполнения гарантий на каждом шаге.

✅ Доступны все возможности Kafka: роутинг, разные гарантии доставки, репликация сообщений
✅ БД не становится узким местом
❌ Самое долгое время между отправкой сообщения и сохранением в БД среди всех вариантов
❌ Возможна неконсистентность данных и нарушение порядка изменений
Другие сервисы могут получить сообщение об изменениях раньше, чем "основной" сервис.

Если развивать вариант "убираем БД" дальше, придём к Event Sourcing. Это подход, в котором основной источник данных — события, а не БД. Но это уже другая история🧚‍♀️

Вариант 3: добавляем координатор

Оставляем БД исходную задачу по хранению данных, а для отслеживания изменений добавляем отдельный компонент. Общая схема выглядит так:

🔸 В базе данных что-то меняется
🔸 Координатор обнаруживает это изменение
🔸 Транслирует изменение в кафку

База может записывать изменения в отдельную таблицу с помощью триггера, materialized view или логической репликации. Координатор может смотреть на таблицу, а может читать логи БД.

Всё это многообразие объединяется термином Change Data Capture (CDC).

✅ Чёткие зоны ответственности. Postgres хранит данные, Kafka шлёт сообщения, координатор координирует
✅ Огромная гибкость, множество вариантов реализации
❌ Возможна дупликация сообщений
❌ Сложность системы увеличивается
Теперь у нас не 2 компонента (БД и Kafka), а гораздо больше. Больше инстансов, настроек, мониторинга и потраченных человеко-часов.

Реализация

Большинство инструментов базируются на Kafka Connect, в том числе популярная CDC система Debezium. Здесь и остановимся, пока всё просто и понятно:) Оценить, насколько глубока кроличья нора, можно в документации Debezium.

Резюме

Для слаженной работы Postgres и Kafka есть три основных подхода. Они отличаются
✍️ гарантиями доставки сообщения
✍️ нагрузкой на БД
✍️ временем между сохранением в БД и доставкой сообщения
✍️ сложностью
✍️ дополнительными возможностями

Выбираем решение по приоритетам, требованиям и нагрузке и ставим огоньки хорошему посту🔥
  • 🔥 269
  • 👍 18
  • ❤ 13
Post #537 13.4K
Postgres и Kafka, часть 1

Возвращаюсь к ведению канала, и на этой неделе вас ждут 2 огненных поста🔥🔥 о взаимодействии Postgres и Kafka.

Эта пара безумно популярна на большинстве проектов👯‍♀️ База хранит данные, кафка отвечает за коммуникации между сервисами. Сегодня разберу одну проблему в их отношениях и расскажу вариант решения. А в следующем посте обсудим ещё 2 способа.

Рассмотрим проблему на простом примере.

Пользователь создал заказ, сервис принял запрос. Сервис добавил заказ в базу, и хочет рассказать другим сервисам о новом заказе. Что-то вроде такого:
public Order saveOrder(…) {
Order saved = orderRepo.save(…);
kafkaTemplate.send("orders",new OrderCreated(…));
}

Другие сервисы, подписанные на orders, получат сообщение и что-то сделают. Посчитают скидки, обновят статистику, запишут заказ в свою БД и тд.

В чём проблема?

Мы обращаемся к двум отдельным компонентам — базе данных и брокеру сообщений. Каждый из них в любой момент может отвалиться, например, пропадёт связь по сети. В зависимости от порядка строк в saveOrder возможны 2 негативных исхода:

😢 запись в базу сделали, сообщение не отправили
😢 отправили сообщение, но запись в БД не прошла

Получим несоответствие. Поэтому иногда хочется, чтобы события выполнились атомарно: либо оба успешно завершаются, либо ни одно из них.

Большинство разработчиков нетерпеливо скажут: "Что тут думать, нужен transaction outbox!!1". Но если спросить 10 человек, что они под этим понимают, получится 10 разных ответов.

В лучших традициях канала обсудим всё простыми словами:) Очень грубо все решения можно назвать так:
1️⃣ Убираем кафку
2️⃣ Убираем БД
3️⃣ Добавляем координатор

Сегодня рассмотрим первый вариант, в следующем посте — остальные два.

Вариант 1: убираем кафку

У Postgres есть механизм notify/listen, который отправляет уведомления заинтересованным лицам. И вместо отправки сообщений через кафку мы возьмём механизм подписки внутри БД.

База становится единственным компонентом и выполняет оба действия (сохранить в таблицу, уведомить заинтересованных) в одной транзакции.

Чтобы не решать проблемы с координацией двух компонентов, мы переложили всю работу на один.

✅ Образцовая транзакция: атомарность и доставка exactly once
✅ Минимальная задержка между сохранением в базу и уведомлением
❌ Ограниченная функциональность уведомлений
❌ Размытие ответственности — часть уведомлений делает Kafka, часть — Postgres
❌ Увеличение нагрузки на БД

Последний пункт — главный ограничитель, поэтому подход "база делает всё" не очень популярен.

Реализация

Можно взять spring-integration-jdbc и для отправки сообщений, и для получения уведомлений. Документация максимально скудная, дополнительные детали есть в этой статье (под VPN)

В следующем посте обсудим ещё 2 варианта🔥
  • 🔥 216
  • 👍 51
  • ❤ 18
Post #536 16.7K
​IDEA: как не потерять важные места в коде

В огромном проекте всегда есть места, которые хочется отметить или быстро находить.

Раньше это делали так:
🔴 Ставили неактивный брейкпойнт в нужном месте. В принципе нормально, но иногда сложно вспомнить, что где находится
⭐️ Добавляли файл в favorites. Файл добавляется целиком, что не очень удобно

Затем в IDEA убрали favorites и добавили закладки. Супер удобно, ни одна важная строчка теперь не потеряется.

▫️ Курсор на нужной строке → F11 → появляется закладка
▫️ Правый щёлк по закладке → Rename bookmark… → ввести что-то осмысленное
▫️ Посмотреть закладки: View → Tool Windows → Bookmarks (или Shift + F11)
  • 👍 160
  • 🔥 61
  • ❤ 19
  • 👎 3
Post #535 13.6K
Scoped Value (preview)

Неделю назад вышла java 21. Cегодня разберу интересную фичу в стадии превью — Scoped Value.

Ближайший аналог Scoped Value — ThreadLocal. Это когда мы объявляем переменную

ThreadLocal<Integer> value;

и для каждого потока будет своё независимое значение value.

В бизнес-логике это редко нужно, но фреймворки активно пользуются этим классом. Spring Security использует ThreadLocal для хранения информации о текущем пользователе. Давайте на этом кейсе посмотрим недостатки ThreadLocal, и что предлагает ScopedValue.

Как работает секьюрити:

1️⃣ Когда приходит новый запрос, Spring вытаскивает информацию о пользователе и записывает в ThreadLocal переменную:

public static ThreadLocal<Principal> PRINCIPAL = …

void serve(Request request, Response response) {
…
var principal = ADMIN;
PRINCIPAL.set(principal);
…}

2️⃣ Бизнес-логика. В любом месте кода можно узнать, кто выполняет запрос:

var principal = PRINCIPAL.get();

Обычно каждый запрос обрабатывается в своём потоке, поэтому данные между запросами не пересекаются.

3️⃣ В конце работы с запросом удаляем информацию из ThreadLocal переменной

Что в итоге:

✅ Не надо передавать Principal в параметрах
❌ Надо явно очищать значение ThreadLocal переменной в конце работы
❌ В любом месте можно вызвать set/remove и всё сломать
❌ Подход несовместим с виртуальными потоками

Scoped Value намерен решить проблемы выше. Как это выглядит:

public static ScopedValue<Principal> PRINCIPAL = …

void serve(Request request, Response response) {
…
var principal = ADMIN;
ScopedValue.where(PRINCIPAL, principal)
.run(() -> process(request, response));
…}

Переменная PRINCIPAL со значением principal будет доступна только внутри конкретного вызова метода process. Достать значение внутри process:

var principal = PRINCIPAL.get();

Кроме run есть метод call, который возвращает значение из переданной функции:

var result = ScopedValue.where(Server.PRINCIPAL, guest)
.call(() -> getResult());

Сначала кажется, что для java синтаксис Scoped Value очень необычный — как будто переменная главнее основного действия. Но такое в java уже есть, вспомните try-with-resources.

Что получаем:

✅ Видимость переменной задаётся для конкретного вызова метода
✅ У ScopedValue нет метода set, переменную нельзя обнулить/поменять внутри блока
✅ Код совместим с виртуальными потоками

Что вызывает вопросы:

🤔 Сценарии использования

Неизменяемый аналог ThreadLocal, совместимый с Project Loom точно нужен, но не вижу смысла задавать область видимости настолько гранулярно

🤔 Нельзя использовать несколько ScopedValue без использования вложенности. Хотя это легко реализовать по аналогии с try-with-resources

⚒ Где использовать: пока вижу только как замену ThreadLocal при переходе на виртуальные потоки.

Фича сейчас в стадии превью, посмотрим, как она будет развиваться. Если будет, конечно:)
  • 👍 70
  • 🔥 14
  • ❤ 10
Post #534 15.1K
Сегодня релиз Java 21🥳

Главные фичи новой версии:

🔸 Виртуальные потоки

В чём суть: для многих задач производительность ограничивается количеством потоков в ОС. Чтобы обойти это ограничение и использовать потоки на максимум, придумали множество способов — асинхронные библиотеки, реактивное программирование и тд. Вариант рабочий, но код усложняется.

Виртуальные потоки позволяют писать простой код и не упираться в ограничения ОС.

Ближайший аналог виртуальных потоков — горутины в Go. Собственно, горутины — основная причина, почему многие сервисы написаны на Go.

Более дальний аналог — корутины в Kotlin. Они имитируют виртуальные потоки на уровне библиотеки и несут большие накладные расходы. В java виртуальные потоки реализованы на уровне JVM, поэтому их производительность гораздо выше.

В теории виртуальные потоки принесут пользу большинству приложений. Посмотрим, что будет на практике.

🔸 Pattern matching

В этих постах (один, два) я подробно расписала, зачем нужен pattern matching в целом, и как он реализован в java. Вкратце: нужен не всем, реализация в джаве так себе

🔸 Sequenced collections

Новые методы в коллекциях: getFirst(), getLast(), reversed() и другие. Подробный пост тут

Интересные preview фичи:

🔹 String templates — интерполяция строк, возможность писать

String str = "Hello, ${name}!";

Подробнее в этом посте

🔹 Scoped Values — аналог ThreadLocal c ограниченной областью действия
🔹 Structured Concurrency — способ организации подзадач в многопоточной среде

Остальные фичи очень специфичные и вряд ли пригодятся большинству разработчиков:

▫️ Generational ZGC — в сборщик добавили поколения, как следует из названия. Молодые объекты будут собираться чаще, и сборщик будет работать эффективнее
▫️ Record Patterns — records можно использовать внутри case
▫️ Foreign Function & Memory API (Third Preview) — методы для работы с нативным кодом и управлению памятью за пределами JVM. Это нужно для приложений, которые хотят сами управлять размещением объектов в памяти и не зависеть от сборщика мусора.
▫️ Unnamed Patterns and Variables (Preview) — можно не указывать имя переменной, если оно не нужно. Вместо него ставить _

Например, в case:
case Point(int x, _) → …

Или при ловле исключения:
catch (IllegalStateException _)

Было бы удобно сделать такое для лямбд, но для этого есть отдельный JEP, который сделают чёрт знает когда

▫️ Deprecate the Windows 32-bit x86 Port for Removal — перестать работать с Windows 32-bit x86, в будущем удалить
▫️ Prepare to Disallow the Dynamic Loading of Agents

Агент — компонент, который изменяет классы при загрузке или меняет уже загруженные классы в JVM. Используется для мониторинга, профайлинга и других служебных целей

▫️ Key Encapsulation Mechanism API — методы для защиты ключей симметричного шифрования
▫️ Unnamed Classes and Instance Main Methods (Preview)

Видимо чтобы короче писать Hello World:
class HelloWorld {
void main() {
System.out.println("Hello, World!");
}
}

Вот такой релиз. Конечно, самая ожидаемая фича — это виртуальные потоки. Если планируете в ближайшее время внедрять их, отпишитесь по впечатлениям, мне очень интересно😊
  • ❤ 89
  • 👍 67
  • 🔥 38
  • 👎 6
Post #531 13.2K
Любимые подписчики, поздравляю вас с днём разработчика!

Мы все разные, с разным опытом, интересами и бэкграундом:

👦🏻 Кто-то пришёл в профессию по зову сердца, кто-то ради денег
👩 Кто-то горит работой, а кто-то уже выгорел
🧔🏻‍♀️ Кто-то работает 10 лет и видел всё. Кто-то только делает первые шаги

Но каждый прошёл огромный путь. Изучил тонны информации, научился тысяче вещей. Гибкий ум, критическое мышление, способность быстро обучаться и разбираться в сложном — наши сильные стороны.

Cегодня отличный день, чтобы признать свои заслуги и сказать себе: "я умничка". Признать, что делаешь сложную работу, и хорошо с ней справляешься.

Ребята, вы прекрасны! Вы очень умные и талантливые, каждый из вас.

Не будьте критичны к себе, почаще отдыхайте. Не стесняйтесь просить большую зарплату. Берегите своё желание учиться и покорять новые высоты❤️

С праздником🥳
  • ❤ 277
  • 🔥 51
  • 👍 21
Post #530 13.1K
Анонс курса по многопоточке🥳

Старт: 2 октября
Длительность: 9 недель

Кто давно ждал и уже готов → https://fillthegaps.ru/mt

Теперь подробнее. У курса две основные задачи:

✅ Научиться писать хороший многопоточный код

Разберём типовые энтерпрайзные задачи, огромное количество кейсов, лучших практик и возможных ошибок. Сравним производительность разных решений для разных ситуаций

✅ Подготовимся к собеседованиям, где требуется concurrency. Обсудим стандартные и нестандартные вопросы, порешаем тестовые задания

Что говорят ученики:

👨‍🦱 "Курс понравился тем, что он "от разработчиков разработчикам": примеры реальных библиотек для разбора, приближенные к реальным задачи для кодинга"
👨‍🦱 "Курс очень интенсивный, охватывает не только многопоточку, но и смежные темы, учит разным лайфхакам полезным для практического использования, обращает внимание на темы, которые легко или упустить, изучая тему самостоятельно, или вообще можно никогда не узнать без курса"
👨‍🦱 "Есть очень много свежей информации, которую сконцентрировано в едином источнике не получить"
👨‍🦱 "Это не с нуля совсем курс, и больше про правду разработки, разбавленную вопросами с собесов, а не про чистые знания."

Океан отзывов можно почитать тут

Для какого уровня курс?

Middle и выше

Сколько стоит?

🔸 Без обратной связи: 32000 руб.
🔸 С обратной связью: мест нет

Разницу между тарифами можно почитать тут. Этот поток — последний с обратной связью.

✔️ Есть рассрочка на 3 и 6 месяцев
✔️ Принимаются карты любых банков
✔️ Курс можно оплатить за счёт компании
✔️ Налоговый вычет 13%

Аналогов у курса нет. С каждым потоком программа становится лучше, задания интереснее, а учёба приятнее. Если хотите разобраться с многопоточкой, и вам близок мой стиль изложения — записывайтесь, будет очень полезно!

https://fillthegaps.ru/mt
  • 👍 26
  • 🔥 21
  • ❤ 10
Post #529 12.2K
Pattern matching: синтаксис

В прошлый раз мы обсудили pattern matching в вакууме. Сегодня обсудим, как он выглядит в java с учётом 21 версии, и чего не хватает в текущей реализации.

Под зонтик pattern matching относят много фич: sealed классы, records, обновление switch и instanceOf. Sealed и records в контексте pattern matching — специфичные кейсы data oriented programming, не будем о них. Cфокусируемся на более популярных сценариях:)

Итак, как pattern matching воплощается в синтаксисе:

1️⃣ Компактный instanceOf

Раньше для неизвестного типа выполнялись две операции: instanceOf и явное приведение типа:

if (obj instanceof String) {
String str = (String) obj;
// используем str
}

Теперь эти операции объединены. Рядом с instanceOf объявляем имя переменной и сразу ей пользуемся:

if (obj instanceof String str) {
// используем str
}

Тонкий момент— переменная определяется только при успешном выполнении instanceOf, поэтому есть нюанс с областью видимости.

В логическом И можно использовать переменную в том же if:
✅ if (obj instanceof String s && s.length() > 5)

Логическое ИЛИ такого не позволяет, будет ошибка компиляции:
❌ if (obj instanceof String s || s.length() > 5)

2️⃣ Компактный switch

У древнейшей конструкции доступен новый синтаксис:
▫️ Стрелочка вместо двоеточия
▫️ Break в конце case по умолчанию, и его можно не писать
▫️ Можно объединить несколько case в один

Старый синтаксис никуда не делся, им можно пользоваться:

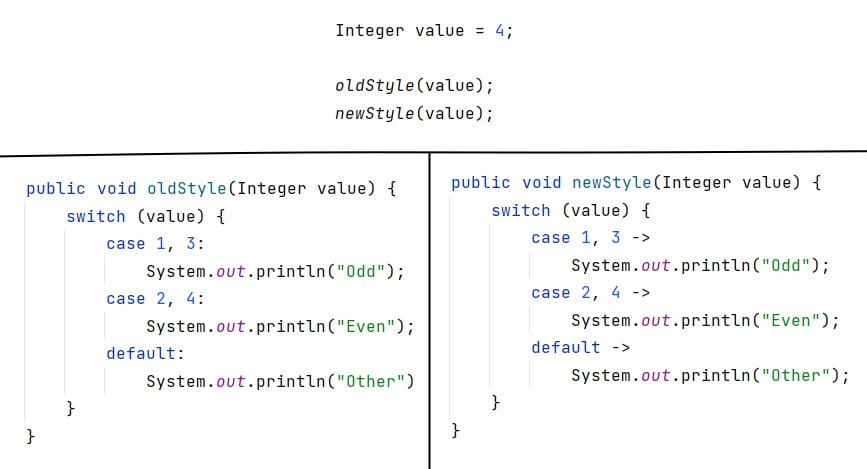
switch (value) {    
case 1:
case 3: println("Odd"); break;
case 2:
case 4: println("Even"); break;
default: println("Other");
}

В "новом стиле" это будет так:

switch (value) {    
case 1,3 -> println("Odd");
case 2,4 -> println("Even");
default -> println("Other")
}

Важный момент — break добавляется по умолчанию только в вариант "со стрелочками". В "двоеточиях" break всё ещё добавляется вручную.

🔥 Ответ на вопрос перед постом: выведется Even Other Even. Чтобы работало как надо, нужно переписать на стрелочки или добавить break.

3️⃣ Присвоение элемента через switch

int value = switch(…) {…};

4️⃣ Проверка в switch по типам и сложные case

Раньше в case принимались только константы. Теперь можно проверить тип переменной:

switch (obj) {
case Integer i -> …
case Long l -> …
case Double d -> …
}

Если произошёл мэтч, для переменной сразу доступна доп. информация, и можно добавить условия в case:

switch (response) {
case String s when s.length() == 10 -> …
}

А теперь самое интересное! Обсудим, чего в текущей реализации нет:

❌ Нет работы с массивами

Один из кейсов pattern matching — работа с набором данных, в которых мы ищем определённые признаки. Такого в java пока нет:

double discount = switch(transaction) {
case ["vip", Long, _, _, Double sum] → sum*0,9
case _ → 0
}

В других языках такой функционал есть. Например, List patterns в С# или Matching sequences в питоне.

❌ Нет паттернов по полям класса

Под капот спрятан только instanceOf, остальные условия выглядят как в обычном if. Вся работа с полями происходит через методы:

switch (figure) {
case Square s when s.getLength() != 10 → …
}

В том же питоне запись гораздо компактнее:

match point:
case (0, 0): …
case (0, y): …
case _: …

JEP Record Patterns мог быть как раз об этом, ведь records позиционируются как лаконичные контейнеры данных. Но увы.

Резюме

В текущем виде pattern matching выглядит слабо, особенно по сравнению с другими языками. Покрыты только базовые кейсы, в таком виде область применения очень ограничена.

Возможно это лишь промежуточный этап. Посмотрим, как фича будет развиваться и использоваться✨
  • 🔥 54
  • 👍 31
  • ❤ 13
Post #528 9.09K
  • 👍 29
  • ❤ 4
Post #527 9.54K
​Что будет напечатано в консоли? (используется Java 20)
Post #526 11.9K
Pattern matching: зачем?

Последние годы в джаву активно добавляется группа фич на тему pattern matching.

Тагир Валеев из Intellij IDEA в этом докладе рассказывает, какие это сложные фичи, как много челленджей стояло перед командой разработки. Но не говорит, зачем он вообще нужен.

Архитектор java Brian Goetz пишет, что pattern matching — не просто синтаксический сахар, а движение в сторону data oriented programming. Но это слабо применимо к большинству корпоративных систем, где доминирует ООП и изредка встречается функциональное программирование.

Большая часть моих знакомых считает паттерн матчинг "стрелкой вместо двоеточия в свиче":)

Так что сегодня расскажу, для каких задач пригодится pattern matching. В следующем посте обсудим реализацию в java.

Формат входных данных в энтерпрайзе обычно чётко определён. Если входящее сообщение не подходит по формату — это ошибка со стороны клиента.

Но бывает, что система работает со множеством источников данных, и выделить общий формат очень сложно.

Например, вы парсите чужие сайты/документы/дампы и достаёте оттуда что-то полезное. Знаю один проект, где бизнес-данные вытаскивают из логов(!) другой системы🤯

В итоге входные данные выглядят как [Object, Object, Object].

Паттерн — схема того, что мы ищем. Паттерн для поиска координат может выглядеть так:

▫️ [Double, Double] — ищём массив из двух чисел с плавающей запятой
▫️ [(-90;90), (-180,180)] — массив с двумя числами в указанных диапазонах

Дальше идём по набору данных и проверяем их на соответствие паттерну.

Традиционно для такой задачи используется связка if + instanceOf. Вариант рабочий, но читаемость ужасная.

Вот что нужно написать, чтобы проверить, является ли координатами массив [Object, Object] data:

if (data.length == 2 && data[0] instanceOf Double && data[1] instanceOf Double) {
double n = (Double) data[0];
double e = (Double) data[1];
if (n ≥ -90 && n≤ 90 && e ≥ -180 && e ≤ 180) {
// что-то делаем
}
}

В pattern matching многие проверки убираются под капот, и код выглядит симпатичнее:

switch(data) {
case [(-90; 90), (-180, 180)]:
// что-то делаем
}

Близкий родственник паттерн матчинга — регулярные выражения. Строка — это набор символов, внутри этого набора ищутся паттерны. Можно сделать ту же работу через if, но регулярка удобнее. Плюс в строке элементы однородные (символы), а паттерн матчинг работает с разными типами данных.

Ещё пример:

double discount = switch(transaction) {
case ["vip", Long, _, _, Double sum] → sum*0,9
case _ → 0
}

Здесь ищем список из 5 элементов, где первый — строка "vip", второй и пятый — число. Если нашли — можно сразу работать с полем sum. Если не нашли — используем паттерн по умолчанию _

С if-ами эта конструкция будет гораздо объёмнее

Резюме

✅ Pattern matching нужен, когда мы пытаемся найти что-то знакомое в слабо- или неструктурированных данных.
✅ Большинство instanceOf и if отправляются под капот, и мы получаем более компактный код.
✅ Разумеется, применить pattern matching можно и в других сценариях, но здесь видится наибольший профит в корпоративном царстве ООП.

В следующем посте распишу возможности pattern matching конкретно в джаве.
Спойлер: пока не впечатляет😑
  • 🔥 88
  • 👍 40
  • ❤ 13
  • 👎 1
Post #525 11.6K
Как я провалила курс по спрингу

В декабре прошлого года я проводила адвент-календарь по java. 21 день почти тысяча человек разбирали нюансы java core. В конце я спросила: какую тему ещё разобрать, где есть непонятки? Ответ был почти единогласным — Spring.

И я поставила цель на 2023 — сделать что-нибудь полезное по спрингу. Не для начинающих, с практическими фишками и лучшими практиками.

За 8 месяцев так ничего и не сделала😞

Я не склонна к самобичеванию, и попробовала разобраться, почему так получилось. Ответ лежал на поверхности.

Все силы идут на курс по многопоточке. Чуть появляется свободное время — бегу его улучшать. Хотя давно можно остановиться. Отзывы прекрасные, доходимость высокая. Хороший баланс между пользой и нагрузкой. Аналогов до сих пор нет ни в СНГ, ни в англоязычном мире.

И кажется, это отличный момент пойти дальше.

Следующий поток будет в октябре, и это будет последний раз в текущем виде. Дальше я пройдусь по бэклогу, сделаю рефакторинг, и курс останется только в варианте без обратной связи.

А со следующего года снова займусь образовательным творчеством. Руки чешутся взяться за спринг и другие темы!

Всё это похоже на чувства от принятого оффера. Когда на старом месте всё получается, и коллеги лапочки, но есть чувство, что можешь больше. Новый проект обещает что-то интересное, и ты с надеждой устремляешься в путь.

Так что кто хотел на курс с обратной связью — откладывать больше нельзя. Через пару недель объявлю набор, и в начале октября начнём🚀
  • 🔥 118
  • 👍 50
  • ❤ 27
  • 👎 5
Post #524 13.5K
Java 21: sequenced collections
или "фича, которая опоздала на 25 лет".

19 сентября выходит java 21, и среди прочего там будет JEP 431: Sequenced Collections.

В чём суть изменений?

В JDK добавится новый интерфейс SequencedCollection. В него войдут методы, которые должны были появиться в джаве ещё в 98 году. Простые операции, для которых каждый раз пишется маленький велосипедик🚲

♨️ Пример 1: получить последний элемент в списке

Сейчас это так:
last = list.get(list.size() - 1);

В java 21 наконец-то появится специальный метод:
last = list.getLast();

♨️ Пример 2: пройти список в обратном порядке

Сейчас это так:
for(int i=list.size(); i>0; i--){
int value = list.get(i));
}

Выглядит жутко. Альтернатива — использовать Collections.reverse:

List<Integer> reversed = new ArrayList<>(list);
Collections.reverse(reversed);
reversed.forEach(…);

Выглядит симпатичнее, но здесь море лишних действий: создаём новую(!) коллекцию, переставляем её элементы и только потом делаем обход.

В java 21 всё гораздо проще:
list.reversed().forEach(…)

Метод reversed не меняет исходную коллекцию и возвращает view с обратным порядком обхода.

♨️ Пример 3: обойти LinkedHashSet

LinkedHashSet — список с уникальными элементами. Хотя это список, класс реализует только интерфейс Set. Поэтому работы с индексами нет вообще.

Получить первый элемент ещё можно:
first = linkedHashSet.iterator().next();

А вот последний — никак, надо полностью обходить структуру. Код писать не буду, слишком громоздкий.

В java 21 те же операции выполняются легко и просто:
first = linkedHashSet.getFirst();
last = linkedHashSet.getLast();

Резюме

В java 21 появится интерфейс SequencedCollection с методами
▫️ SequencedCollection<E> reversed()
▫️ void addFirst(E)
▫️ void addLast(E)
▫️ E getFirst()
▫️ E getLast()
▫️ E removeFirst()
▫️ E removeLast()

Плюс интерфейсы SequencedSet и SequencedMap с тем же функционалом.

Новые методы появятся в ArrayList, LinkedList, HashSet, LinkedHashMap, LinkedHashSet, частично в TreeSet и некоторых других классах.

Было бы здорово увидеть эти методы 25 лет назад, но лучше поздно, чем никогда:)
  • 👍 225
  • 🔥 74
  • ❤ 21
Post #523 12.8K
12 factor app: конфиг

Где хранить конфиги? На каком этапе передать их приложению?

Эти вопросы обсуждаются в третьем пункте 12 factor app, который звучит как

Store config in the environment

Разберём, что это значит:)

Конфигурация — это всё, чем отличаются запущенные приложения на разных средах. Например,
✅ Адреса, логины, пароли, токены внешних сервисов
✅ Специфичные значения для конкретного сервиса: имя хоста, порт
✅ Управляющие параметры: имя профайла, флажки и прочие свойства

Не являются конфигом:

❌ Классы спринга с аннотацией @Configuration. Это описание компонентов и связей, часть исходного кода

❌ Описания и состав профайлов. В спринге это аннотация @Profile. Причина та же: профайлы описаны в кодовой базе, которая не меняется. Но вот параметр, который задаёт, какой именно профайл нужен — это конфиг

Не конфиг:
@Configuration
@Profile(”dev”)
public class DBConfiguration {…}

А вот это конфиг:
-Dspring.profiles.active=dev

Задача разработчика простая: отделить конфигурацию от основного кода. Тогда приложение легко запустить и настроить на работу в разных средах.

Где хранить конфиги?

Оригинальный документ категоричен: конфиг должен передаваться через environment переменные, а конфиг-файлы не должны существовать. Потому что:

🔸 Рано или поздно сервис с продакшн конфигами попадёт в лапки разработчиков, и они сделают delete table users
🔸 Файлы с конфигами расползаются по всей системе, это небезопасно и сложно в управлении
🔸 Environment переменные не зависят от ОС, фреймворка и языка разработки

Мотивация понятна, но на практике всё работает не так:) Конфиги группируются в файлы, а в гите часто хранится дефолтный файлик для разработки.

Конфиги могут лежать в другом сервисе, например, в Kubernetes, Zookeeper или даже в HashiCorp Vault. Последний поддерживает версионирование и следит, кто и когда запрашивал данные.

Для ежедневной разработки есть следующие best practices:

✅ В параметрах конфига нет префикса среды выполнения, а в коде — логики по их разделению:
❌ @Value("dev.datasource")
✔️ @Value("datasource")

✅ В коде нет констант вроде "8080", "admin", имён хостов, логинов и паролей

Кажется, что это само собой разумеется, но нет:) В 2020 году утекли личные данные 243 миллионов бразильцев, потому что пароль БД был записан константой в исходном коде сервиса минздрава. А согласно этому исследованию более 100к GitHub репозиториев содержат токены и криптографические ключи прямо в исходном коде. Будем надеяться, что это всё pet проекты, которые нигде не используются🤞
  • 🔥 63
  • 👍 22
  • ❤ 12
Post #522 14.8K
ChatGPT внутри IDEA

Общаться с нейросетью через текстовое окошко — популярная форма работы с ChatGPT, но не единственная.

Я попробовала 3 варианта интеграции нейросетей с IDEA:
▫️ AI Assistant от Jetbrains
▫️ Самый популярный плагин на основе ChatGPT — EasyCode
▫️ Помощника от Amazon — CodeWhisperer

В этом посте поделюсь впечатлениями!

🤖 AI Assistant от JetBrains

Полноценный assistant пока не вышел в релиз и доступен только в билде 2023.2 EAP 6 (скачивается отдельно). Альтернатива — подключить плагин AI Assistant, работает только для IDEA Ultimate.

Основные фичи:

✅ Пообщаться с нейросетью
в отдельной вкладке, не выходя из IDE. Сейчас это прокси к ChatGPT, в будущем появится больше моделей

✅ Узнать, что делает выделенный код, возможные проблемы и варианты рефакторинга

Здесь пока нет вау-эффекта. Объяснение получается слишком длинным, рефакторинг и поиск проблем работают только для простых случаев. Но уверена, что эти фичи будут развиваться

🔥 Написать документацию

Пока моя любимая фича. Набираете перед методом /**, появляется кнопка Suggest documentation. Классно заполняется краткое описание и смысл входных-выходных параметров. Требует немного правок, но здорово экономит время!

✅ Написать сообщение для коммита

При коммите появляется кнопка ✨ (без шуток, так и выглядит). ИИ описывает изменения в стиле: "в классе А добавился метод B, в классе C изменилась реализация метода D". Очень многословно, пока not recommend

🤖 Плагин ChatGPT - EasyCode

Самый популярный плагин по работе с ChatGPT. Лучший вариант, если у вас IDEA Community, и хочется попробовать ИИ прямо сейчас. Основные фичи такие же, как в AI Assistant:

✅ Окошко для общения
✅ Получить объяснение, что делает выделенный код
✅ Узнать варианты рефакторинга

Но есть кое-что, чего в у JetBrains пока нет: опция Write Unit Tests🔥

Тесты ужасно примитивные, но идея чудесная! Возлагаю на этот функционал большие надежды

🤖 CodeWhisperer от Amazon

Не самый известный вариант, но самый интригующий. Амазон пишет, что натренировал модель на огромном количестве кода, и контрольная группа увеличила productivity на десятки процентов.

Установить CodeWhisperer чуть сложнее, чем предыдущие варианты: поставить плагин AWS Toolkit, зарегистрироваться и привязать учётку к IDEA.

Название CodeWhisperer очень точно отображает поведение. В предыдущих плагинах надо явно спрашивать совет у ИИ, а здесь помощник шепчет рекомендации, даже если не просишь. Причём они появляются не в отдельном месте, а сразу в коде призрачным шрифтом.

Меня это бесит, но формат real-time рекомендаций выглядит круто. В менее навязчивой форме будет вообще отлично💛

Другие фичи:
✅ Поиск OWASP уязвимостей в коде + идеи по исправлению
✅ Посмотреть похожий код в open-source проекте

По этим функциям ничего сказать не могу. В моём проекте не оказалось уязвимостей и не нашлось кода, похожего на open-source проекты. Но звучит интересно.

Что не понравилось:

😒 Нет окошка "просто спросить". Можно попросить написать код в самом классе, но без диалога и дальнейших уточнений
😒 Нет кнопок с базовыми действиями вроде "сгенерировать документацию". Все запросы надо писать целиком и самостоятельно
😒 Неудобный интерфейс и мутная документация

Хотелось удалить помощник через 5 минут после использования. Непонятно, какие ключевые слова использовать, что за странные кнопки со стрелками, неудобно смотреть предложенные варианты. В документации никаких примеров.

CodeWhisperer выглядит как сырой продукт, но очень аутентичный.

Общее впечатление

Интеграция ИИ в IDE делает первые робкие шаги. Мне понравилась генерация документации, за остальным пока буду наблюдать со стороны:)

Для ваших задач выводы могут отличаться. Попробуйте сами, все инструменты в посте — бесплатные, а установка не занимает много времени🔥
  • 🔥 106
  • 👍 39
  • ❤ 14
  • 👎 7
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →