TGViewer
Channel Public Channel
Java: fill the gaps

Java: fill the gaps

@java_fillthegaps

Привет! Меня зовут Диана, и я занимаюсь разработкой с 2013. Здесь пишу просто и понятно про джава бэк

🔥Тот самый курс по многопочке🔥
https://fillthegaps.ru/mt

Комплименты, вопросы, предложения: @utki_letyat
Subscribers
12.3K
Photos
7
Videos
0
Links
217

Showing posts older than #521 · Back to latest

Older Posts 20 shown
Post #520 9.71K
12 factor app: зависимости

Продолжаем разбирать признаки здорового сервиса. Второй пункт рекомендует

Explicitly declare and isolate dependencies

Разберём его подробнее.

Для java приложений нужные модули и библиотеки описываются в pom.xml или build.gradle файле. Тогда приложение будет собираться на любой среде, где есть среда исполнения и установленный менеджер зависимостей. Не будет проблем с локальной разработкой и настройкой CI.

Dependency isolation часто пропускают при обсуждении 12 факторов, потому что непонятно, что это такое:) Оригинальный текст и правда звучит туманно: ☁️no implicit dependencies “leak in” from the surrounding system☁️

Вообще это означает, что версия каждой зависимости должна быть чётко определена.

Альтернатива — опция latest для Docker образов и gradle зависимостей.

Почему это не ок? Допустим, приложение использует библиотеку Х версии 1 во время разработки и всех стадий тестирования. Затем у библиотеки Х выходит версия 2, которая использует другое API. Вторая версия подтягивается во время релиза, и продакшн погружается во мрак🌑

Таких сюрпризов не будет, если обозначить версию явно
🔹 в pom/build файле проекта
🔹 в BOM файле
🔹 в родительском pom/build

В большинстве компаний используются специальные инструменты для работы с зависимостями — Artifactory или Nexus. Они нужны, чтобы
🔸 хранить приватные артефакты — корпоративные модули или библиотеки
🔸 кэшировать библиотеки, чтобы экономить трафик
🔸 использовать проверенные службой безопасности артефакты

При использовании Artifactory/Nexus конфликты версий случаются редко. Но есть и обратная сторона: апгрейд библиотеки превращается в увлекательное бюрократическое приключение:)

Как проверить приложение:
✅ Для сборки проекта достаточно команды maven/gradle
✅ Для всех сред используется один pom/build файл
✅ Если в компании используется Artifactory или Nexus, не добавляйте явно другие репозитории

12 factor app — классный документ, он объединяет важные моменты, которые часто остаются в стороне. Работа с зависимостями, кодовой базой и остальные 10 пунктов — это БАЗА. Обычно она описана в недрах Confluence или передаётся из уст в уста:)

Объединить все важные знания в один документ — прекрасная идея, а для нас — отличный способ закрыть возможные пробелы🧡
  • 👍 50
  • 🔥 28
  • ❤ 14
  • 👎 1
Post #519 10.1K
12 factor app: кодовая база

12 factor app — чеклист из 12 пунктов для адаптации сервиса к облаку.

Список появился в 2017 году, и был модным года до 20. Упоминание 12 факторов на собеседовании производило вау-эффект и приводило интервьюеров в восторг:)

Большинство идей до сих пор актуальны. Но

🤔 Оригинальный текст очень формальный, иногда это просто набор терминов и процессов. Не написано, в чём смысл, и какая проблема решается. Когда цель непонятна, работа превращается в карго культ или бесполезные движения

🤔 Не всегда понятны конкретные шаги. Иногда это "делайте хорошо, плохо не делайте"

🤔 Некоторые рекомендации в оригинальном тексте слишком жёсткие или устарели

Так что потихоньку пройдусь по всем пунктам, объясню суть и дам более актуальные рекомендации, чем в оригинале.

Первый пункт посвящён работе с кодовой базой и звучит так: one codebase tracked in revision control, many deploys

Приложение полностью отслеживается системой контроля версий.

Экземпляр запущенного приложения называется deploy. Неважно, где он запущен — в проде, локально у разработчика или в тестовой среде. Хотя в жизни чаще используются другие термины (билд, артефакт или просто сервис), дальше буду использовать оригинальный термин.

🔸 У каждого сервиса своя кодовая база в одном репозитории.

🔸 У разных приложений разные кодовые базы. Общий код выделяется в библиотеку/модуль и импортируется через менеджер зависимостей.

🔸 У каждого приложения одна кодовая база, но на разных средах могут использоваться разные версии. Например, локально у разработчика запускается ветка с фичей, тестировщик работает с мастером, на проде разворачивается релизная ветка.

В чем смысл ограничений: если продакшн использует одну кодовую базу, а разработка и тестирование — немного другую, однажды появится ошибка, которая воспроизведётся только на продакшене.

На практике вполне нормально, что для разных сред код работает по-разному. Обычно изменения касаются внешних компонентов.

Яркий пример — платёжная система. Работать с настоящими деньгами — непозволительная роскошь, поэтому для разработки и тестирования используются либо заглушки, либо специальные песочницы.

Как проверить приложение:

✅ В коде нет условий вроде if (env == dev). Переключение между заглушками и настоящими системами происходит через конфиг
✅ Общие модули импортируются через менеджер зависимостей — Maven или Gradle
✅ Финальный этап тестирования происходит на версии, которая потом отправится в продакшн
  • 🔥 55
  • 👍 35
  • ❤ 16
Post #518 10.7K
IDEA: live templates

Хейтеры говорят, что java многословная. Похоже, они пишут код в блокноте, потому что IDEA помогает писать код со скоростью мысли🚀

Есть две полезные фичи: live templates и code completion.

1️⃣ Live templates

Это по сути аббревиатуры для кода. Вводите 4 символа, нажимаете Enter, и они разворачиваются в 40!

🔸 Простые
▫️ St → String
▫️ sout
System.out.println();
▫️ main
   public static void main(String[] args) {}
▫️ prsf
   private static final

🔸 Сложные
Разворачиваются в методы с параметрами для автозаполнения. Перемещаться между полями можно через Tab:

▫️ fori
for (int i=0; i< ; i++) {}
▫️ ifn
if (args == null) {}
▫️ mx
Math.max(, );
▫️ lazy
if (obj == null)
{ obj = new Integer(); }

Полный список live templates: File → Settings→ Editor → Live Templates.

Есть для Java, Kotlin, JS, Groovy, для разработки под Android и React.

2️⃣ Code completion

Это дополнение имен на основе контекста.

🔸 Начните набирать начало класса/метода:
▫️ Int → Integer
▫️ Cust → Customer

🔸 Для классов наберите заглавные буквы:
▫️ NPE → NullPointerException
▫️ CHM → ConcurrentHashMap

🔸 Добавьте синтаксическую конструкцию:
▫️ count == 4.if
if (count == 4) {}
▫️ list.for
for(Integer i : list) {}
▫️ obj.opt
Optional.of(obj)
▫️ answer.switch
switch (answer) {}

Полный список: File → Settings → Editor → General → Postfix Completion. Есть варианты для Java, Kotlin и JS.
  • 👍 155
  • 🔥 78
  • ❤ 19
  • 👎 2
Post #517 9.42K
​Разделение строк и велосипеды

Простой способ разделить строку на части — встроенный метод split:

"123-456-789".split("-") → [123, 456, 789]

Сегодня разберём, насколько оптимально работает метод, и как написать код быстрее, чем JDK.

Исходный код split выглядит как-то так:

public String[] split(String regex) {
if (разделитель — один символ)
пройтись по всем символам. Встречаем разделитель - извлекаем подстроку
} else {
Pattern.compile(regex).split(this)
}

Разберём обе ветки этого кода

Разделитель — один символ

Сразу видим fast path для разделителей из одного символа. Алгоритм в этом случае не использует регулярку и выполняется быстрее. Но проверка, что строка-разделитель является символом, занимает 10(!) строк.

🚲 Напишем свой split — изменим тип входных данных на char, чтобы проверку делал компилятор:

split(String regex) → split(char delim)

Остальной код остаётся тем же. Мы только убрали лишние условия. Потом проверим, стало ли лучше:)

Разделитель — несколько символов

Также в глаза бросается работа с регуляркой, если разделитель состоит из нескольких символов. Компиляция регулярного выражения выполняется долго, для набора строк кажется разумным выполнить её один раз:

List<String> list = …
❌ list.stream().map(s -> s.split(": "))…
✅ Pattern p = Pattern.compile(": ");
list.stream().map(s -> splitPattern.split(s))
…

Насколько это поможет — проверим в бенчмарке.

С другой стороны, кажется, что регулярка — это слишком серьёзное решение. Если разделитель — двоеточие с пробелом, то мощь регулярного выражения здесь не нужна.

🚲 Поэтому напишем второй велосипед, который очень похож на первый. Будем искать в исходной строке подстроку-разделитель. По полученным индексам делить строку на части.

Оба велосипеда припаркованы тут: 🚲🚲

Оценим готовые решения

Библиотека Apache Commons предлагает метод split, но работает он чуть по-другому. Метод ищет только первый разделитель и делит строку максимум на две части:

StringUtils.split("1-2-3", "-"); 
// получим 2 строки: "1" и "2-3"

Ставим минус за неспортивное поведение, но включаем метод в наши эксперименты.

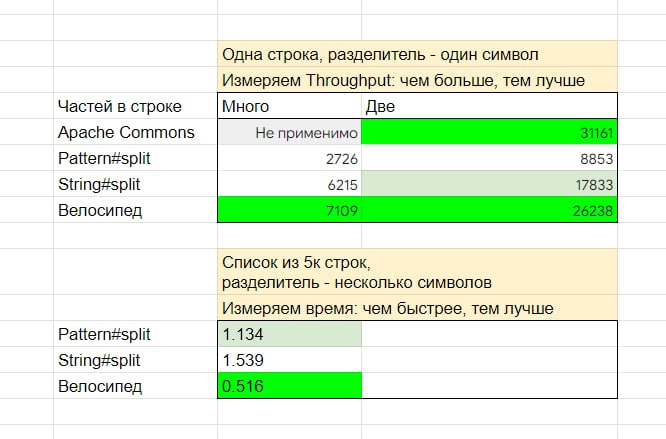
Результаты

на картинке внизу. Результаты на разных железках могут отличаться.

🔸 Оба велосипеда в пух и прах разбили стандартный split. String#split слишком универсальный, и как любое универсальное решение, проигрывает кастомизированному. Если деление строк — ваш hot spot, не стесняйтесь написать свой метод.

К слову, это не первый велосипед, который выигрывает у JDK. Такое уже случалось при сравнение строк. Надо бы завести тикет по этим кейсам:)

🔸 Если строка делится только на две части — подойдёт split из Apache Commons

❗️Для нормальной нагрузки и однократного вызова подойдёт стандартный String#split. Оптимизации нужны, когда деление строк происходит очень часто.

Не могу не отметить, что хотя подобные задачи появляются редко, они приносят море удовольствия. Разобрать код в деталях, найти пути улучшения, и в итоге метод выполняется в 2 раза быстрее, красота😊
  • 👍 81
  • 🔥 41
  • ❤ 7
Post #516 9.83K
​Skip List

Сегодня расскажу о структуре данных Skip List. Хочу сделать упор не на деталях реализации, а на том, зачем он нужен. И почему в java Skip List есть только в многопоточном варианте.

Кто вообще использует связные списки?

Давным-давно мы сравнивали ArrayList (список на основе массива) и LinkedList (связный список).

В большинстве энтерпрайзных задач LinkedList проиграл. Вставка в середину редко встречается в бизнес-логике, в основном мы работаем со списком как с хранилищем данных. Но

✅ В инфраструктурных задачах вставка в середину более актуальна. SortedSet в Redis — сортированный список уникальных элементов. Элементы часто добавляются и удаляются из произвольных мест, логично взять за основу именно LinkedList. В очереди с приоритетами и secondary indexes тоже пригодится связный список.

✅ Многие структуры используют связный список косвенно: элементы ссылаются друг на друга для упрощения обхода или дополнительной сортировки.
Взять ту же LinkedHashMap из JDK — хэшмэп, в котором элементы связаны между собой в порядке добавления.

Самая проблемная операция LinkedList — поиск элемента. Даже в сортированном списке приходится ходить по ссылкам последовательно. Это долго.

Как устроен Skip List

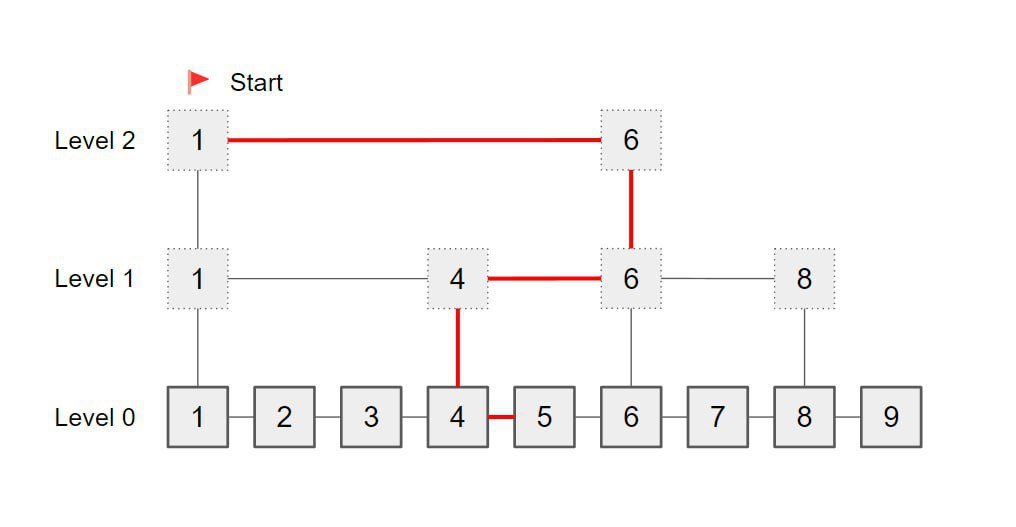
Чтобы искать элементы быстрее, добавляем для исходного списка несколько уровней со ссылками.

Пример — на картинке под постом. Чтобы найти пятёрку, движемся от верхнего уровня к нижнему.

В реальности на верхних уровнях промежутки больше, и мы быстрее приходим к нужному месту. В идеальном случае за O(log N).

❓ Это разве не дерево теперь?

Действительно, алгоритм поиска очень похож. Но чем Skip List отличается от дерева:

🔸 Балансировка

В деревьях очень строгие правила, при добавлении-удалении дерево часто перестраивается. Зато мы получаем высокую и стабильную скорость поиска.

В Skip List более расслабленный подход. Новый элемент добавляется в основной список, а вопрос с наличием ссылки на верхних уровнях решается через рандом.

В целом структура получается нормально сбалансированной. Одни элементы будут находиться быстрее, другие медленнее, в среднем время поиска стремится к O(log N).

🔸 Расположение элементов

В Skip List все элементы хранятся на нижнем уровне. Добавление-удаление происходит очень легко — надо переписать всего пару ссылок.

В дереве элементы находятся в узлах со строгой структурой. Вставка и удаление часто приводят к ребалансировке.

Резюме

✍️ Связные списки редко используются в энтерпрайзе, но часто в инфраструктуре (кэши, БД). Основной сценарий здесь — поиск. И сам по себе, и для работы с текущими значениями.

✍️ Дерево не всегда подойдёт, тк часто балансируется. В нагруженных системах лишняя суета ни к чему😑

✍️ Чтобы ускорить поиск в связном списке, добавляем дополнительные уровни. Получаем Skip List!

Сортированные структуры в JDK

В однопоточной среде для хранения сортированных элементов чаще используют TreeMap/Set. Это красно-чёрное дерево. Балансируется при каждом изменении, поиск работает быстро и стабильно.

Поддерживать дерево в многопоточной среде сложно как раз из-за балансировки. Чтобы дерево безопасно сбалансировалось, лучше заблокировать его целиком, что снижает общую пропускную способность.

В многопоточной среде для той же задачи используется ConcurrentSkipListMap/Set. Изменения очень локальные: меняется несколько ссылок, а большая часть списка остаётся неизменной. Поэтому одновременно со структурой могут работать больше потоков.

Ответ на вопрос перед постом

ConcurrentSkipListSet — сортированный список без повторов. Skip List — название базовой структуры данных, Set — признак уникальности элементов.
  • 👍 79
  • 🔥 37
  • ❤ 14
  • 👎 1
Post #515 8.12K
  • 👍 15
Post #514 10.3K
​B-tree

Если жизнь занесёт вас в чтение материалов по БД, то с вероятностью 90% там встретится B-tree. Собственно, о нём сегодня и расскажу.

Обычное двоичное дерево подходит для данных, которые помещаются в оперативку. Тогда можно без проблем прыгать по дереву и быстро его перестраивать.

Ситуация меняется, если данных много, и они записываются на диск. Обращение к диску в тысячи раз медленнее, чем обращение к оперативке. Чтобы скорость работы осталась терпимой, нужно реже обращаться к диску и как следствие — меньше прыгать по дереву.

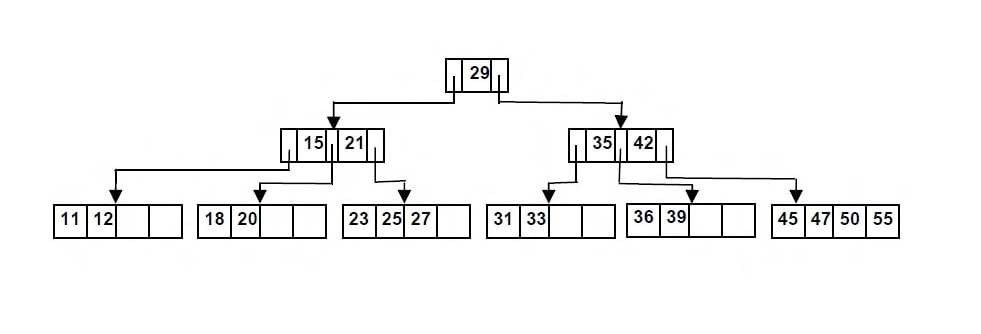
В долговременной памяти данные хранятся и читаются блоками по 4-8 Кб. Под размер блоков как раз и заточено B-tree: каждый узел занимает один блок и содержит сотни элементов. КПД чтения одного блока увеличивается, высота дерева уменьшается. Таким образом структура отлично работает в условиях, когда чтение — затратная операция.

Высота редко превышает 3. Дерево с высотой 4 вмещает до 256 TB данных!

Такая вот несложная структура, то что надо для пятницы:) Пример B-tree — на картинке внизу. Визуализация тут

Вариации:

🌴 B+ tree: элементы хранятся только в листьях. В узел помещается больше ссылок, высота дерева уменьшается ещё больше. Конечные данные лежат рядом, поэтому последовательный доступ получается чуть быстрее

🌲B* tree: блоки заполняются экономнее, чем в классическом B-tree. Дерево занимает меньше памяти, но изменения выполняются дольше

❓ Что означает B?

Часто говорят, что B означает Balanced. Но другие деревья тоже балансируются, не только B-tree.

Моя любимая версия, что B означает Boeing, потому что эту структуру придумали и описали в Boeing Research Labs. Но точно неизвестно, что значит B.

❓ Что ещё почитать на эту тему?

Информации выше вполне хватит обычному разработчику. Всё, что дальше — пугающе сложно:)

B-tree редко используются в одиночку. В индексах БД они работают в паре с
🔸 Bloom filter, чтобы не искать элементы, которых нет
🔸 Write ahead log (WAL), чтобы не потерять изменения во время перезаписи блока
🔸 Bitmap, чтобы следить за наполненностью блоков

Про работу B-tree в Postgre можно подробнее узнать в этой статье и с помощью библиотеки pageinspect.

Итого: B-tree пригодится для размещения данных, которые лежат на диске. В основном это индексы БД и файловые системы. Основная фишка — размер узла B-tree равен размеру блока на диске🌳
  • 🔥 63
  • 👍 33
  • ❤ 11
Post #513 9.75K
Bloom filter

Прошлый пост получил нереальное количество огонёчков, было супер приятно, спасибо за реакции❤️

Сегодня начну серию постов "компутер саенс лайт".

Расскажу о структурах данных, которые используются в популярных библиотеках. Вряд ли вы будете писать их самостоятельно, но полезно понимать, зачем они нужны. Плюс это очень интересно:)

Первый участник — Bloom filter (фильтр Блума). Помогает узнать, есть элемент во множестве или нет.

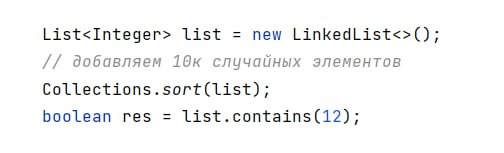
❓ Зачем нужна отдельная структура, когда есть метод contains?

В LinkedList contains последовательно обходит коллекцию, даже если элементы отсортированы. Это долго, сложность такого подхода составляет O(n). В бинарном дереве contains выполнится быстрее, за O(log n).

Но есть ситуации, когда даже такой поиск нежелателен: данных очень много, они не отсортированы или хранятся на диске. В этих случаях проверка займёт уйму времени.

Здесь на помощь приходит Bloom filter — вероятностная структура данных для быстрого contains. Если фильтр вернул

▫️ true — элемент скорее всего есть. Но может и нет
▫️ false — элемента 100% нет

Более формально: это структура с возможным false positive ответом

Принцип работы

В основе лежит bitSet, набор битов. Возьмём для примера bitSet длиной 8:
00000000

Чтобы добавить в фильтр элемент Х:

☝️ Считаем хэш тремя разными функциями, получаем H1, H2, H3
✌️ Вычисляем индексы в bitSet. Берём остаток от деления H1, H2, H3 на 8. Пусть это будет 0, 2 и 3
💅 Обновляем соответствующие индексы в фильтре. Получится
10110000

Повторяем для всех элементов списка/дерева/множества/etc.

Как проверить, был ли добавлен элемент в фильтр?

🔸 Считаем хэш элемента 3 функциями
🔸 Получаем 3 индекса и считываем биты
🔸 Если среди них хотя бы один 0, значит элемента в фильтре нет

Здесь можно поиграться и углубиться в детали.

Фильтры Блума активно используются в базах данных, роутерах, при проверке чёрных списков. Много примеров ищите здесь.

Готовая реализация BloomFilter есть в библиотеке Google Guavа.

❓ Как возможны false positive результаты? Если фильтр вернул true, почему элемента Х может не быть?

Другие элементы могут занять индексы, которые используются для проверки элемента Х. Поэтому фильтр вернёт true, хотя Х не был добавлен.

❓ Как размер фильтра влияет на вероятность false positive ответов?

Чем больше размер фильтра, тем ниже шанс, что индексы элементов будут пересекаться. Вероятность false positive снижается, но увеличивается размер занятой памяти.
  • 🔥 116
  • 👍 31
  • ❤ 16
Post #512 7.71K
  • 👍 38
  • ❤ 8
Post #511 7.89K
​Какая сложность у операции contains?
  • 👍 8
  • ❤ 6
Post #508 9.94K
Понятия в БД, часть 3. CAP, BASE, PACELC

Аббревиатура ACID появилась в 1983 году и относилась тогда к реляционным БД небольшого размера. В 2023 БД уже большие и распределённые. С ними связаны три понятия — CAP теорема, BASE и PACELC теорема. С ними и разберёмся в этом посте.

CAP теорема говорит, что распределённая система может обеспечить не больше двух гарантий из трёх:

🔸 Consistency — при каждом чтении читается последнее значение. Неважно, один сервер в системе или тысяча. Эта определение целостности отличается от определения в ACID

🔸 Availability — каждый запрос возвращает ответ

🔸 Partition tolerance — система продолжает работать несмотря на задержки в связи серверов и отказ некоторых из них

Речь идёт о распределённых системах, так что без Partition tolerance никак. Если во время запроса пропала связь между серверами, придётся делать выбор:

🤔 Отменить запрос. Это упор на консистенси — доступность снижается, зато ответ будет точным. Такие системы условно называют CP системами
🤔 Выполнить запрос без учёта данных с отвалившихся серверов. Такие системы часто называют AP системы

У целостности и доступности тоже есть градации:

▫️Доступность считается высокой от 90% до 99.999999%
▫️У целостности 15+ различных моделей

100% гарантий никто не даёт, и деление систем на СР и АР довольно условное. У большинства БД и брокеров можно настроить баланс между доступностью и целостностью для разных ситуаций.

Расширением CAP теоремы является теорема PACELC:

🔹 Если связь между серверами нарушается, придётся выбирать между целостностью данных и доступностью. Об этом говорится в CAP
🔹 При нормальной работе встаёт выбор между низкими задержками (Latency) и целостностью (Consistency). Чем чаще синхронизируются сервера, тем выше задержки и целостность данных

И ACID, и CAP теорема обещают больше, чем есть на деле. Более честен акроним BASE:

▪️ Basically Available — некоторые сервера могут быть недоступны, но в целом система работает
▪️ Soft state — некоторые данные могут не сразу попасть на другие сервера
▪️ Eventual consistency — но однажды точно попадут

Неопределённость, слабые гарантии — всё это реалии разработки распределённых систем.

Теперь ответ на вопрос перед постом. Термин "целостность" по-разному трактуется в ACID и CAP теореме. Грубо говоря:
▫️ ACID consistency — в данных нет аномалий
▫️ CAP consistency — данные на всех серверах одинаковые

Может быть ситуация, когда в БД выставлен уровень Serializable и отличная целостность по ACID, но так себе целостность по CAP, и сервера синхронизируются раз в час. Может быть и наоборот, и вообще в любых сочетаниях✨
  • 🔥 81
  • 👍 33
  • ❤ 10
  • 👎 1
Post #507 7.8K
  • 👍 18
  • 🔥 6
  • 👎 2
Post #506 8.53K
Понятия в БД, часть 2. Уровни изоляции

Изоляция в ACID говорит: транзакция должна выполняется так, как будто других транзакций нет.
Единственный надёжный способ добиться этого — запускать транзакции последовательно. Это медленно, поэтому БД поддерживает менее строгие модели изоляции. База работает быстрее, но возможны аномалии данных.

В этом посте углубимся в детали: что за аномалии, что за уровни изоляции, и какие проблемы они решают.

Проблемы давно известны — dirty reads, write skews и тд. Чем больше проблем решает БД, тем больше кода нужно выполнить, и тем медленнее она работает. Уровни изоляции позволяют найти баланс между скоростью и корректностью.

В SQL стандарте их 4:
▫️ READ_UNCOMMITED
▫️ READ_COMMITED
▫️ REPEATABLE_READ
▫️ SERIALIZABLE

Каждый уровень гарантирует решение чёткого списка проблем. Остальные решаются либо в коде сервиса, либо никак (если проблема не актуальна).

В стандарте SQL три основные проблемы:

🔸 Dirty reads — грязные чтения

Транзакция 1 обновляет поле Х. Другие транзакции видят новое значения Х до того, как транзакция 1 завершится.

В вопросе с переводом денег как раз возникла такая ситуация. Транзакция перевода ещё не завершилась, а другая транзакция прочитала промежуточные значения.

Проблема возникает только на уровне READ_UNCOMMITED.

🔸 Nonrepeatable reads — неповторяющиеся чтения

Транзакция 2 читает поле X и работает с ним. В это время транзакция 3 обновляет поле Х. В итоге транзакция 2 работает с устаревшим значением.

Более формально, "неповторяющееся чтение" означает, что чтение одного поля в начале и конце транзакции даёт разные результаты. Но редко кто читает одно поле дважды, на практике получается либо бесполезная транзакция с устаревшими данными, либо несогласованные данные внутри транзакции.

Проблема остро проявляется для долгих запросов, например, бэкапов или аналитики. Решается на уровне REPEATABLE_READ и выше.

🔸 Фантомные чтения

Транзакция 3 проверяет условие по большому количеству записей. Транзакция 4 меняет выборку, например, добавляет новую запись. Если условие в транзакции 3 перестанет выполнятся, транзакция 3 этого не заметит.

Важно, что условие касается не одного поля, а многих. В этом разница с неповторяющимся чтением. Там меняется одно конкретное поле, а в фантомном чтении меняется вся выборка, по которому проверяется условие.

Проблема решается на уровне SERIALIZABLE.

Подробные примеры и схемы аномалий есть в Википедии. У многих проблем есть вариации, поэтому аномалий получается больше, чем уровней изоляции.

Каждая БД сама решает, какие проблемы и вариации на каких уровнях решать. У MS SQL 5 уровней изоляции, у Oracle 3. Многие NoSQL базы не поддерживают транзакции, поэтому для них указывать тип изоляции бессмысленно. В универсальных адаптерах типа JDBC, Hibernate и Spring Data уровней столько, сколько в стандарте — 4.

Ещё одна проблема, которой нет в SQL стандарте, но которая встречается на практике:

🔸 Потерянный апдейт

Транзакции работают с одними данными и не учитывают друг друга.

Пример: транзакция 5 и транзакция 6 одновременно прочитали значение счётчика. Каждая транзакция прибавила к значению единицу и обновила поле счётчика. Вначале они прочитали одно значение, и получается, что один инкремент потерялся.

Проблема решается не только уровнями изоляции, но и SQL конструкциями:

🔹 Атомарный апдейт:
UPDATE test SET x=x-1 where id=1;

🔹 Блокировка строки:
SELECT * FROM test WHERE id = 1 FOR UPDATE;

Итого. Как учитывать внутрянку БД в написании кода:

⭐️ Выбирать уровень изоляции с учётом вероятности и критичности проблем
⭐️ Уточнить в документации БД, какие проблемы решает выбранный уровень
⭐️ Писать код с учётом возможных аномалий
⭐️ Помнить о потерянных апдейтах
  • 👍 85
  • 🔥 31
  • ❤ 14
Post #505 6.76K
  • 👍 22
  • 🔥 8
  • ❤ 2
  • 👎 1
Post #504 7.73K
Понятия в БД, часть 1. ACID

Когда я была беспечным джуниором, то представляла базу данных как всемогущий цилиндр. Записываешь туда что-то, а потом читаешь.

Но база данных — это обычная программа со своими сложностями и ограничениями. В следующих постах расскажу о принципах работы БД. Где на неё можно положиться, а где надо решать проблемы самому.

Есть популярный вопрос на собесах про свойства БД. Предполагается, что кандидат назовёт аббревиатуру ACID и cкажет 4 главных слова — ✨Atomicity, Consistency, Isolation, Durability✨ Сегодня и поговорим об этих прекрасных буквах.

Когда БД обозначена как ACID-compliant, ожидается:

🔸 A — Atomicity

Можно объединить несколько операций в одну транзакцию. Если произойдёт ошибка, уже сделанные операции в группе отменятся.

Благодаря этому можно не держать в коде несколько версий данных "на всякий случай" и восстанавливаться после ошибок гораздо проще

🔸 C — Consistency

Ограничения в БД (constraints) соблюдаются всегда и везде. Если две транзакции захотят записать одинаковые значения в UNIQUE колонку, одна транзакция завершится ошибкой.

На практике большинство проверок находятся в коде, поэтому у базы здесь мало работы

🔸 I — Isolation

Каждая транзакция выполняется так, как будто других транзакций не существует.

На практике внутри БД происходит лютая многопоточка, с одними структурами одновременно работают десятки и сотни транзакций.

Единственный способ надёжно изолировать транзакции друг от друга — запускать их последовательно. Это медленно, поэтому у БД есть менее строгие уровни изоляции. С ними база работает быстрее, но возможны аномалии в данных.

Важный момент: constaints для одной строки (CHECK, UNIQUE и тд) железно выполняются. Аномалии встречаются в транзакциях, где изменения состоят из нескольких шагов или меняются несколько строк.

Чтобы перевести 100 рублей с одного аккаунта на другой, нужно снять с первого аккаунта 100 рублей и добавить их на баланс второго. Целостность данных в середине процесса ненадолго нарушится. От уровня изоляции зависит, заметят ли это несоответствие другие транзакции.

Подробно поговорим об этом в следующем посте!

🔸 D — Durability

Если данные записаны в БД, они не потеряются. Здесь два пути:
▫️ Запись на носитель, например, жёсткий диск или SSD
▫️ Отправка копий на другие сервера

100% надёжности на тысячи лет не будет, но сохранность данных — наименее проблемный пункт из всех остальных

Резюме

ACID не даёт гарантий на уровне "записал и забыл". Целостность данных лежит на бизнес-логике, а в коде учитываются возможные ошибки неполной изоляции.

Поэтому сегодня ACID чаще встречается не в техническом описании, а в маркетинговых текстах рядом с цифровой трансформацией и дизайн-мышлением. Многие БД не берут на себя грех называться ACID-compliant, а используют более мягкую аббревиатуру BASE. Её тоже обсудим чуть позже✨
  • 🔥 84
  • 👍 37
  • ❤ 14
  • 👎 6
Post #503 6.59K
  • 👍 24
Post #502 8.33K
Self-referential generic, часть 2

В прошлом посте мы выяснили, зачем self-referential generic нужен в Enum: для использования дочернего типа при реализации интерфейса родителя. Это довольно экзотичный кейс. Сегодня покажу более практичный пример, как дженерики облегчили работу с иерархией и неизменяемыми переменными.

Дано: класс Delivery с информацией о доставке. Метод cancelled делает заказ недействительным. У класса есть наследник FastDelivery, в котором дополнительно хранится ID курьера:

class Delivery {
final long id;
final boolean isActive;

public Delivery(long id, boolean isActive) {…}

public Delivery cancelled() {
return new Delivery(this.id, false);
}
}

class FastDelivery extends Delivery {
private final long courierId;

public FastDelivery(…) {…}

public long getCourierId() {
return courierId;
}
}

Проблема: метод cancelled возвращает объект типа Delivery, и мы теряем информацию о курьере:

FastDelivery fast = new FastDelivery(…);
Delivery cancelled = fast.cancelled();

❌ long id = fast.getCourierId();

В такой ситуации помогут self-referential generic и небольшой обходной манёвр:

🔸 Добавляем параметр в родителя
public class DeliveryᐸT extends DeliveryᐸTᐳᐳ

🔸 Создаём метод create, который возвращает нужный экземпляр
protected T create(long id, boolean isActive) {
return (T) new Delivery(id, isActive);
}

🔸 Используем этот метод в cancelled
public T cancelled() {
return create(this.id, false);
}

🔸 Определяем параметр в наследнике
public class FastDelivery extends DeliveryᐸFastDeliveryᐳ

🔸 Переопределяем метод create в наследнике
protected FastDelivery create(long id, boolean isActive) {
return new FastDelivery(this.id, this.isActive, courierId);
}

Всё! Теперь информация не теряется:
FastDelivery fast = new FastDelivery(…);
FastDelivery cancelled = fast.cancelled();

✅ long id = cancelled.getCourierId();

Здесь используется комбо двух приёмов:

🔹 Метод create и его переопределение позволяют использовать поля, доступные в наследнике и вернуть нужный объект
🔹 Self-referential generic помогает вернуть нужный тип в методе cancelled

Готовый код доступен здесь

Резюме

Рассмотрите использование self-referential generic, когда

▫️ У вас есть иерархия
▫️ Родительский тип упоминается в аргументах или возвращаемом значении

Дополнительная типизация снизит количество кода, вытащит ошибки на этап компиляции и для некоторых случаев окажется очень изящным решением✨
  • 🔥 85
  • 👍 28
  • ❤ 12
  • 👎 2
Post #501 8.21K
Self-referential generic, часть 1

Кто участвовал в декабрьском адвенте, точно помнит, что еnum компилируется в наследник класса Enum:

public enum Animal {WOLF, TIGER}
↓
public class Animal extends Enum {
public static final Animal WOLF;
public static final Animal TIGER;
}
Подробнее об этом и енамах в целом можно почитать тут — раз, два и три.

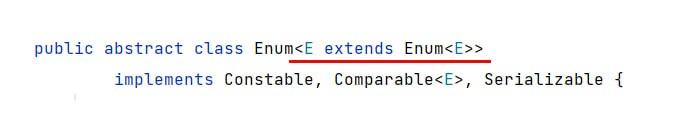
В определении класса Enum используется конструкция, которая называется self-referential generic (или self-bound type, или recursive generic):

EnumᐸE extends EnumᐸEᐳᐳ

В этом посте расскажу, что это такое и зачем нужно.

Чтобы понять, какая проблема решается, представим, что этой конструкции нет. И определение енама выглядит так:

public abstract class MyEnum implements ComparableᐸMyEnumᐳ

Пользователь определяет enum Animal и enum Converter. Компилятор превращает это в классы

Animal extends MyEnum
Converter extends MyEnum

Каждый класс должен реализовать интерфейс ComparableᐸMyEnumᐳ и метод compareTo. Чтобы не сравнивать животных и конвертеры, придётся использовать instanceof:

public final int compareTo(MyEnum o) {
if (o instanceOf Animal other) {
// сравниваем зверюшек
// return ...
}
throw IllegalArgumentException();
}

В самом instanceOf нет ничего плохого. Тем более этот код генерируется при компиляции и остаётся за кадром.

Есть более важный момент. Пользователь может спокойно сравнить животное и конвертер, ошибка возникнет только в рантайме. Это выглядит странно, ведь enum Animal и enum Converter никак не связаны между собой.

Здесь дженерик выходит на сцену:

public abstract class EnumᐸE extends EnumᐸEᐳᐳ implements ComparableᐸEᐳ

🔸 Добавляем параметр E, совместимый с классом Enum
🔸 Используем E в интерфейсе Comparable
🔸 Компилируем enum Animal в
public class Animal extends EnumᐸAnimalᐳ
🔸 Теперь Comparable использует тип Animal, и метод compareTo станет таким:
public int compareTo(Animal o)

✅ Убрали instanceOf, код стал меньше и быстрее
✅ При компиляции происходит проверка типов:

Animal zebra = Animal.ZEBRA;
Converter csv = Converter.CSV;
❌ zebra.compareTo(csv); // не скомпилируется!

Self-referential generic позволяет использовать дочерний тип в интерфейсах и методах родителя. Для некоторых кейсов этот приём здорово упрощает код и снижает количество ошибок. В следующем посте покажу ещё один пример использования.

Ответ на вопрос перед постом: self-referential generic помогает ограничить сравнение разных enum между собой.
  • 🔥 91
  • 👍 29
  • ❤ 13
Post #500 7.45K
  • 🔥 17
  • 👍 7
  • ❤ 2
Post #499 7.43K
​Зачем нужна конструкция <E extends Enum<E>> в определении Enum?
  • 👍 9
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →