Если жизнь занесёт вас в чтение материалов по БД, то с вероятностью 90% там встретится B-tree. Собственно, о нём сегодня и расскажу.
Обычное двоичное дерево подходит для данных, которые помещаются в оперативку. Тогда можно без проблем прыгать по дереву и быстро его перестраивать.
Ситуация меняется, если данных много, и они записываются на диск. Обращение к диску в тысячи раз медленнее, чем обращение к оперативке. Чтобы скорость работы осталась терпимой, нужно реже обращаться к диску и как следствие — меньше прыгать по дереву.
В долговременной памяти данные хранятся и читаются блоками по 4-8 Кб. Под размер блоков как раз и заточено B-tree: каждый узел занимает один блок и содержит сотни элементов. КПД чтения одного блока увеличивается, высота дерева уменьшается. Таким образом структура отлично работает в условиях, когда чтение — затратная операция.
Высота редко превышает 3. Дерево с высотой 4 вмещает до 256 TB данных!
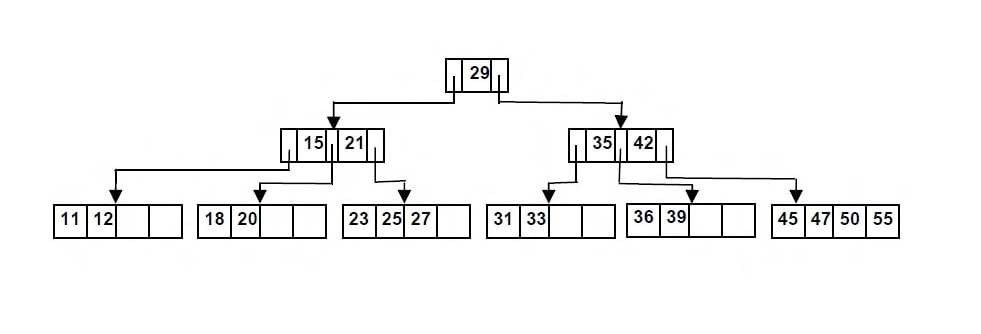
Такая вот несложная структура, то что надо для пятницы:) Пример B-tree — на картинке внизу. Визуализация тут
Вариации:
🌴
B+ tree: элементы хранятся только в листьях. В узел помещается больше ссылок, высота дерева уменьшается ещё больше. Конечные данные лежат рядом, поэтому последовательный доступ получается чуть быстрее🌲
B* tree: блоки заполняются экономнее, чем в классическом B-tree. Дерево занимает меньше памяти, но изменения выполняются дольше❓ Что означает B?
Часто говорят, что B означает
Balanced. Но другие деревья тоже балансируются, не только B-tree.Моя любимая версия, что B означает Boeing, потому что эту структуру придумали и описали в Boeing Research Labs. Но точно неизвестно, что значит B.
❓ Что ещё почитать на эту тему?
Информации выше вполне хватит обычному разработчику. Всё, что дальше — пугающе сложно:)
B-tree редко используются в одиночку. В индексах БД они работают в паре с
🔸 Bloom filter, чтобы не искать элементы, которых нет
🔸 Write ahead log (WAL), чтобы не потерять изменения во время перезаписи блока
🔸 Bitmap, чтобы следить за наполненностью блоков
Про работу B-tree в Postgre можно подробнее узнать в этой статье и с помощью библиотеки pageinspect.
Итого: B-tree пригодится для размещения данных, которые лежат на диске. В основном это индексы БД и файловые системы. Основная фишка — размер узла B-tree равен размеру блока на диске🌳