💻 Есть сайт, есть CRM и есть учетная система. Все как-то связано, заявки идут, статусы обновляются, данные синхронизируются.
Тут в какой-то момент начинаются паранормальные явления: часть заявок не доходит, где-то статусы не совпадают, клиенты говорят “я оставлял заявку”, а в системе ее нет.
Запускаются пять стадий принятия неизбежного и кажется, что это мелкий сбой, вот-вот всё поправят. Но проходит час, потом день — а ничего не меняется.
🔨Начинается первый акт второй сцены. Разработчик сайта говорит, что у них все отправляется. CRM отвечает, что ничего не получала. Интегратор уверяет, что все сделано по задаче. Инфраструктура сообщает, что серверы работают нормально. Постепенно становится понятно: все вроде правы, а система — нет.
И здесь важный момент, который мы часто слышим от клиентов: “Вас, как ИТ-аутсорсинг, не видно и не слышно. А вы вообще работаете?”
⚙️На самом деле это как раз лучший показатель. Хорошая работа ИТ — это когда о нем не думают.
Когда интеграции настроены так, что ничего не ломается, данные идут как надо, а бизнес просто работает. Если же про ИТ вспоминают каждый день — значит, что-то уже пошло не так: где-то костыли, где-то временные решения, где-то нет контроля.
И как раз в таких системах чаще всего и происходит то, о чем мы говорим сегодня.
Причина почти всегда одна и та же. Систему собирали по частям: отдельно сайт, отдельно CRM, отдельно интеграции, отдельно инфраструктура. Подрядчиков выбирали по цене, каждый делал свой кусок, но никто не отвечал за результат целиком.
Пока все работает, этого не видно. Но стоит чему-то сломаться, выясняется, что интеграция — это просто нить между системами, за которую никто не отвечает.
Никто не следит за ней как за процессом, никто не видит, где именно она ломается, и никто не обязан быстро ее чинить.
В итоге время уходит не на решение проблемы, а на переписку и выяснение, чья это зона ответственности. А в это время бизнес уже теряет заявки, деньги и клиентов.
💡 Мораль истории: интеграция — это важная часть бизнес-процесса. Если она ломается, ломается не код — ломается воронка, продажи и работа команды.
🖥⚡️ Почему даже для малого бизнеса актуален вопрос нагрузки на системы
Думаем, вы слышали распространенное убеждение, что нагрузка – это проблема крупных компаний с большим количеством пользователей и данных. Конечно, на практике малый бизнес сталкивается с ней не реже (просто она проявляется иначе).
💼 Даже небольшая компания сегодня использует целый набор систем, состоящий из CRM, 1С, сайта, почты, мессенджеров, интеграций и тд.
Каждая из них по отдельности не выглядит критичной, но вместе они создают постоянный поток операций. Добавляются пики (акции, отчетные периоды, рост заказов) и в какой-то момент система начинает работать на пределе.
Сначала все вроде работает, просто чуть медленнее: интерфейсы открываются дольше, заявки обрабатываются с задержкой, интеграции отвечают не сразу. Можно и не заметить, как в этих мелочах и начнутся потери: менеджер отвечает позже, клиент не дожидается, процессы замедляются.
📊 Чаще всего причина в отсутствии запаса, а ещё в том, что инфраструктура настраивается только под текущие задачи без учета роста и дополнительных нагрузок.
Пока все стабильно, этого безусловно хватает, однако любое изменение – новая система, интеграция или рост числа операций – быстро выводит ее на предел.
🔗 Для малого бизнеса это особенно критично, ведь у вас нет избыточных ресурсов и времени на долгие исправления. А значит любая задержка сразу отражается на работе команды и выручке.
Все-таки в вопросе нагрузки размер компании играет второстепенную роль, главную — интенсивность процессов.
И если ее не учитывать, система не упадет сразу, скорее она будет плавно тормозить бизнес.
🛠 Почему резервирование не равно отказоустойчивость
Во многих компаниях есть ощущение, что если есть бэкапы — значит, все защищены. В реальности это защита только от потери данных, а не от остановки бизнеса.
❗️Важно прояснить: резерв — это возможность восстановить систему после сбоя, а отказоустойчивость — это способность продолжать работу даже при отказе компонентов.
И именно это различие становится критичным в момент инцидента.
🔦 В карточках рассмотрели, что отказоустойчивость — это следующий уровень зрелости. Именно он определяет, насколько бизнес готов к сбоям.
📊 Что происходит, когда растет нагрузка, а инфраструктура — нет
Рост бизнеса редко ломает систему сразу. Сначала все вроде работает, просто становится чуть медленнее. Вы не замечаете, но именно в этот момент начинается деградация.
🗂 Инфраструктура выходит на предел: растут задержки, система отвечает дольше. По данным Google, увеличение задержки на 500 мс может снижать трафик до 20% — пользователи просто уходят.
Дальше — прямые потери. По оценкам Амазон, каждые дополнительные 100 мс могут снижать выручку примерно на 1%.
🔍 В российской практике это выглядит так:
менеджер отвечает позже — клиент уходит, 1С думает дольше — теряются часы работы, интеграции тормозят — заявки теряются.
🔌 Система не падает сразу: она медленно начинает тормозить бизнес, а в пике — уже не выдерживает нагрузку.
Проблема в том, что инфраструктура не растет вместе с бизнесом. И чем позже это замечают — тем дороже исправление.
🔐 Глобальный и локальный инциденты 2025 года: что это значит для бизнеса
Прошлый год еще раз показал: сбои и атаки — это нормальная часть работы инфраструктуры, только вопрос сегодня заключается в том, как бизнес его переживет?
📉 Даже крупнейшие платформы могут падать, а критичные системы могут быть атакованы (смотрите карточки).
Разница только в одном: есть ли у вас сценарий, как быстро восстановиться.
🛡Мы повторяем: инцидент — это не проблема, проблема — это неподготовленность к нему.
🎯 Уровень доступности: что это значит на практике — и как это устроено в Itentis
Про уровень доступности часто говорят как про цифру: 99,9% или 99,99%. Но для бизнеса важны не проценты, а то, что происходит в момент сбоя.
⚡️Уровень доступности — это в первую очередь договоренность о том, как быстро обнаруживается проблема, когда начинается ее устранение и сколько времени занимает восстановление. Именно это определяет реальные потери.
Цифры могут вводить в заблуждение. 99,9% — это до 43 минут простоя в месяц, и они обычно приходятся на самый неудобный момент. При этом процент не говорит, как быстро система вернется в работу.
🛰 В Itentis мы смотрим на это как на управляемость: проблемы фиксируются автоматически, реакция начинается сразу, есть понятные сценарии восстановления и четкая зона ответственности.
В итоге важно не «сколько доступно», а насколько быстро система возвращается в работу. Потому что простой — это всегда про деньги, а не про проценты.
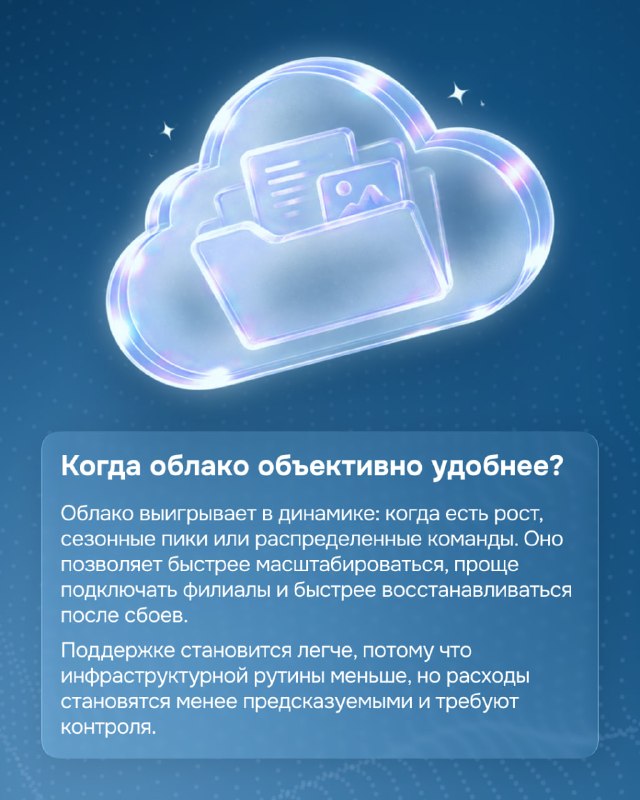
☁️ Из практики: как компания переплатила за облако в 2 раза — и что с этим сделали
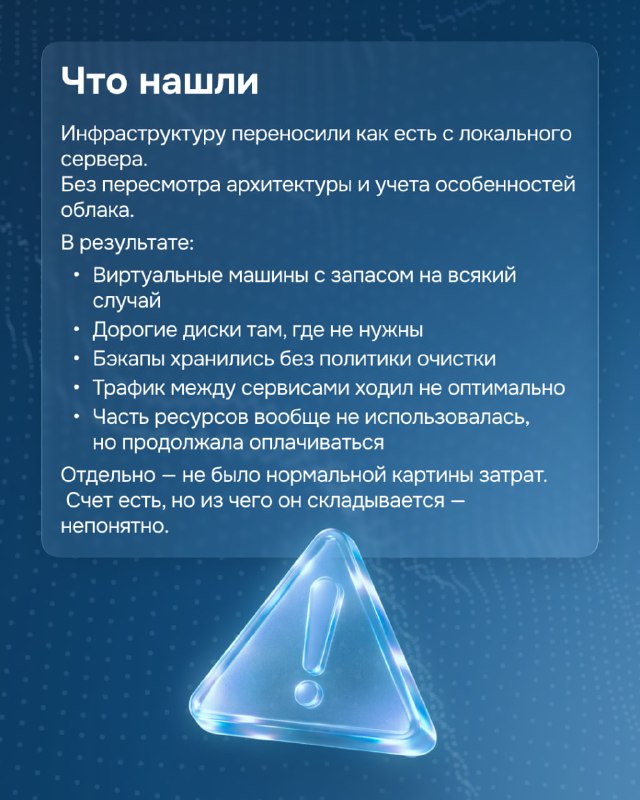
Компания из электронной коммерции пришла с типичной болью: облако вроде работает, но счет растет быстрее бизнеса.
📈 За год расходы увеличились почти в 2 раза, при том что нагрузка выросла всего на ~30%.
Изначально инфраструктура была развернута в крупном корпоративном облаке. Все работало стабильно, без сбоев — но стоимость постепенно выходила из-под контроля.
🔍 На первый взгляд все выглядело нормально (сервисы работают, инцидентов нет), но при разборе выяснилось, что проблема не в самом облаке — а в том, как выстроена архитектура и используется инфраструктура.
Кажется, что 5–10 минут лагов в день — это мелочь. Да, почта чуть дольше открывается, система управления продажами подвисает, заявки грузятся не сразу. Неприятно, но не критично.
📉 На практике же — это прямые потери в лидах и выручке.
Возьмем простую модель: У вас 10 менеджеров, каждый теряет в среднем 7 минут в день из-за из-за недостаточной скорости загрузки. Это почти 1 час потерянного времени ежедневно на всю команду. За месяц — около 20 часов, то есть почти 3 полноценных рабочих дня.
⛓️💥 Теперь к лидам: Допустим, один менеджер обрабатывает 20 заявок в день. Из-за задержек он не успевает оперативно ответить части клиентов: кто-то уходит к конкурентам, кто-то остывает. Даже если теряется всего 10% — это уже 2 заявки в день на человека. На команду из 10 человек — 20 потерянных лидов ежедневно.
👀 А теперь смотрите подсчеты в карточке выше и делайте выводы.
Стабильность почты и CRM равняется скорости реакции, конверсии и деньгам. Потому что каждая минута задержки — это не время. Это лид, который ушел.